团队的 AI 支出,通常是从"各买各的"开始的
一个五六人的小组用上 AI,路径大多相似:写代码的人拿一个编码 agent,做图的人开一个生图平台,做口播的再挂一家语音服务,联网搜索和素材视频又是另外两家。三个月后,财务手里攒了四五张来自不同供应商的账单,每张的计量单位还不一样——有的按 token,有的按张,有的按秒。
这种状态的问题不在于贵,在于不可治理。没有统一单位,就没法回答三个最基础的问题:上个季度哪条业务线消耗最多、下个季度预算该报多少、换一个模型能省多少。
阿里云百炼升级后的 Token Plan,从成本治理的角度看做的正是"统一计量单位"这件事:一个订阅、一份 Credits 额度,文本、图像、视频、语音识别、实时语音对话都从同一个池子里扣,模型内置工具(联网搜索、代码解释器等)也走 Credits 统一抵扣。
这篇不谈使用体验——本机那把订阅凭证已经过期,试用类实测没做成,原因后面单独交代。这里只把订前该核的几笔账按团队视角过一遍:所有数字来自官方文档口径与模型目录逐条核验,本机真实输出原样贴出。
第一笔账:三档原价、额度与并发
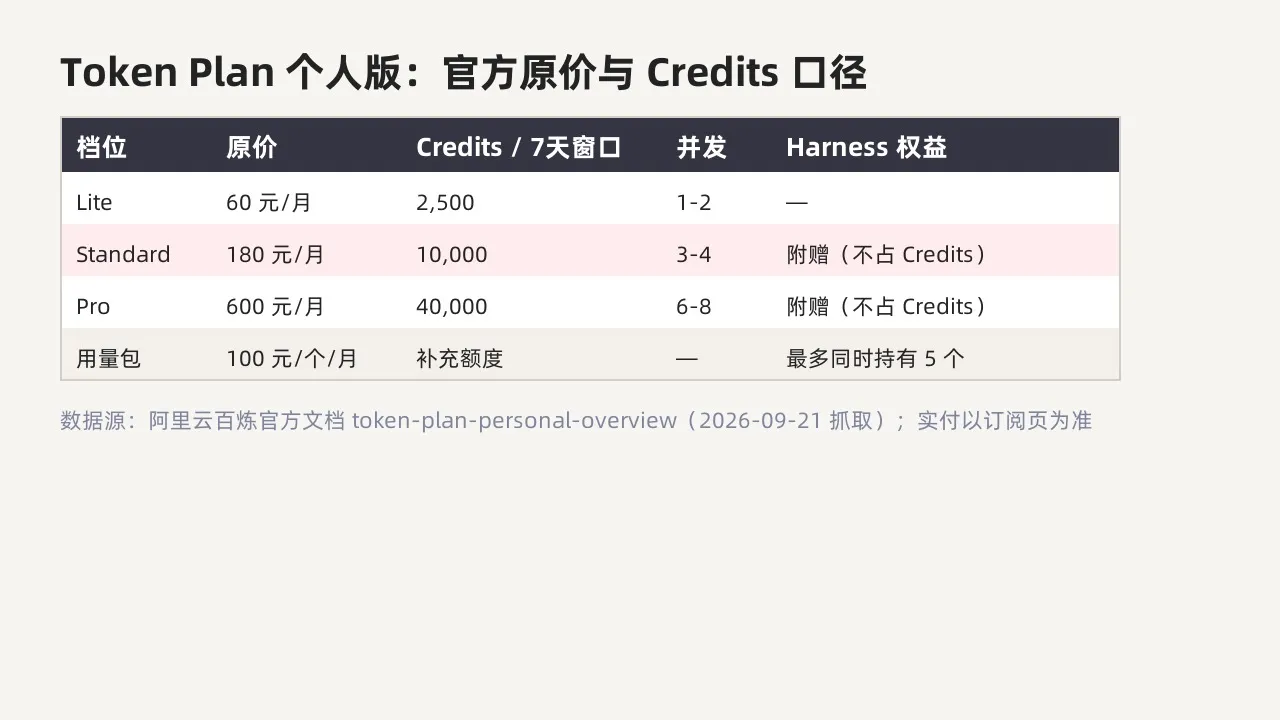
官方口径,个人版三档:
| 档位 | 原价 | Credits | 并发 |
|---|---|---|---|
| Lite | 60 元/月 | 2,500 | 1-2 |
| Standard | 180 元/月 | 10,000 | 3-4 |
| Pro | 600 元/月 | 40,000 | 6-8 |
额度不够时可以买用量包补充:100 元/个/月,最多同时持有 5 个。订阅页偶尔有促销价,实付以订阅页为准。
这张表里最容易被团队跳过的是并发那一列。Credits 决定"一个周期能干多少活",并发决定"几个人能同时干"。Standard 的 3-4 并发,大致对应一个三到四人小组同时跑任务的天花板;如果团队里有人习惯挂着长任务(批量生图、长视频、长文改写),实际可并行的人数还要再打折。选档时把并发和 Credits 放在一起看,比只盯额度靠谱。
第二笔账:7 天窗口是排期约束,不是计费约束
Token Plan 的限额规则:从每个周期的第一次调用开始计 7 天,这 7 天内 Credits 触顶就暂停服务;窗口内没用完的额度不结转到下一周期。触顶之后有四条出路:买用量包、升级档位、使用额度重置功能(消耗重置次数)、或者等窗口结束。
翻译成团队语言:这是一份按周吞吐的额度,不是按月囤货的额度。它带来三个具体的排期后果。
一,周期起点由第一次调用决定,不由订阅日决定。 订阅买了但周一没人用、周五才跑第一条,这个窗口的有效工作日就被压缩了。规范化做法是把"每周期第一次调用"固定在一个大家都干活的时间点,比如周一上午的例行任务,让 7 天完整覆盖一个工作周。
二,批量任务要主动错峰。 集中在一两天里跑完一个月的量,是最容易触顶的用法。能挪到夜里的挪到夜里——官方有限时的夜间五折:每晚 22:00 到次日 08:00,qwen3.8-max、deepseek-v4-pro-0813、deepseek-v4-flash-0731、deepseek-v4.1-flash 四个模型的 Credits 消耗打五折。同样的额度,夜间跑等于翻倍。活动限时,以页面最新内容为准。
三,触顶即暂停,需要有人负责处置。 服务暂停不会自己恢复,四条出路里三条要花钱或消耗重置次数,一条要等。团队里得明确一个人有权当场决定"买用量包还是等窗口",否则触顶那天就是全员停摆那天。
第三笔账:Harness 权益独立计量,别算进 Credits 预算
Standard 与 Pro 两档附赠 Harness 权益(AgentStudio 工具的每月免费额度与后付费折扣),这份权益独立计量,不占 Credits。
这一条对做预算的人有实际含义:团队有两条额度线要分开管。Credits 池对应模型调用(文本/图像/视频/语音/内置工具),Harness 权益对应 AgentStudio 工具的使用。把两者混在一张表里估算,结果一定是错的——要么高估 Credits 消耗,要么低估工具侧的可用额度。做月度成本表时,建议直接开两列。
反过来,模型内置工具(联网搜索、代码解释器等)是走 Credits 抵扣的,这部分在 Credits 池里。对频繁调搜索的业务链路,估算 Credits 时要把工具调用一并计进去,只按模型输入输出估会偏低。
第四笔账:模型目录里有什么,逐个 ID 核一遍
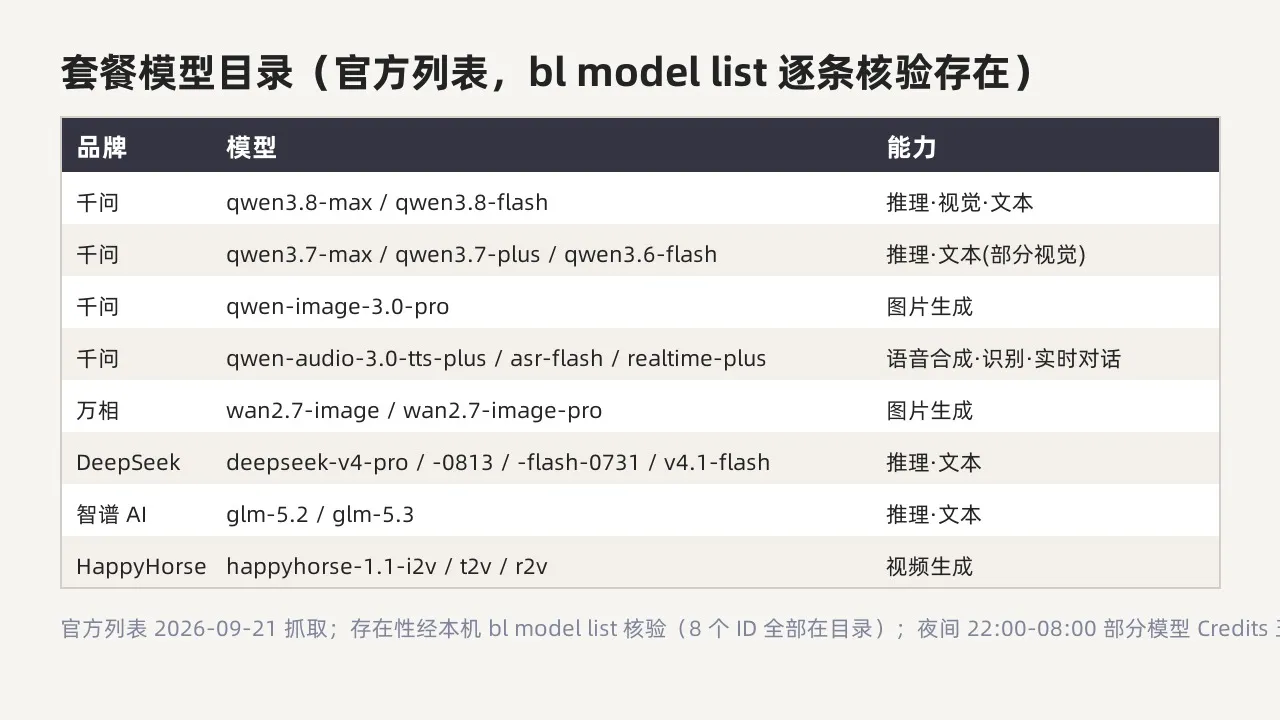
宣传页的模型名单要落到"我的业务用得上哪几个",得逐个 ID 核对。官方目录覆盖五个家族:
- 千问:qwen3.8-max、qwen3.8-flash、qwen3.7-max/plus、qwen3.6-flash、qwen-image-3.0-pro,以及 qwen-audio-3.0 的合成/实时/识别三件套(tts-plus / realtime-plus / asr-flash)
- 万相:wan2.7-image 及 pro
- DeepSeek:v4 系列四款
- 智谱:glm-5.2、glm-5.3
- HappyHorse 1.1:图生视频 / 文生视频 / 参考生视频
我用阿里云百炼 CLI(bl)逐条查了其中 8 个 ID 是否真的在目录里。这一步不需要任何凭证,可以直接抄进团队的选型流程:
bl model list --model qwen3.8-max --output json
8 个全部返回在目录:qwen3.8-max、qwen-audio-3.0-tts-plus、qwen-audio-3.0-asr-flash、wan2.7-image、happyhorse-1.1-t2v、deepseek-v4-pro、glm-5.2、qwen-image-3.0-pro。
配音场景还能零成本先看音色:
bl speech synthesize --config token-plan --model qwen-audio-3.0-tts-plus --list-voices
返回两个系统音色:龙安灵心(知心温暖音)、龙安鲁风(明亮开朗音),中英文都支持。--list-voices 只列音色,不产生合成调用。
一个和目录有关的口径:qwen3.8-max-preview 已经下线,旧的 preview ID 会自动路由到 qwen3.8-max。团队里如果有历史脚本写死了 preview ID,不改也能跑,计费按实际路由到的模型走。
第五笔账:用量包当缓冲,别当常态
用量包的口径是 100 元/个/月,最多同时持有 5 个。它的设计位置很清楚:触顶之后的应急补充,不是把月额度堆上去的手段。
对团队的含义有两条。一是上限明确:同时最多 5 个,靠用量包能补出来的额度有天花板,指望它扛住一个异常高产的周期不现实。二是同样按月计:囤着不用也会过期,不能当库存备着。
所以选档的正确顺序是先按周期吞吐定档位,再把用量包当保险。如果连续两个周期都要靠买用量包才够用,那不是保险生效,是档位定低了。
消耗口径怎么建:用一个周期做基线
统一计量单位的价值要落地,团队得先有自己的消耗数据。这一步我这次没能完成——bl usage token-plan 走控制台登录态,本机登录态过期,命令直接报错退出,没有返回旧数据。所以 Credits 消耗明细我这边查不到,一律以订阅页和控制台显示为准。
方法本身可以先定下来,凭证到位就能直接跑:
- 第一个周期只记录,不优化。每类任务(长文改写、批量生图、配音、带搜索的问答)各跑几次,记下档位和量级,得到一条属于自己业务的消耗基线
- 按任务类型分摊,不按人头分摊。谁的消耗高没有治理价值,哪类任务的单位产出消耗高才有——前者会让人藏用量,后者才能优化
- 第二个周期再定档。基线出来之后,档位、并发、要不要常备用量包,都是能算的
这套动作的成本是一个周期,收益是往后每个周期的预算都有据可依。相比之下,按宣传页的额度上限反推档位,通常会在第一次触顶时返工。
我们没核到的部分:凭证 401,试用实测待补
核完目录准备实测,第一条命令就撞墙:
bl text chat --config token-plan --message "用一句话介绍你自己"
返回 HTTP 401 InvalidApiKey。换成带联网搜索的调用方式、换成语音合成,错误码一致,说明问题不在命令签名,在这把 Key——本机存的订阅凭证是上一期的,已经失效。想查 Credits 消耗明细的 bl usage token-plan 走的是控制台登录态,本机登录态也过期了,命令直接报错退出。
所以这篇里没有"配音自然不自然""生图够不够用"这类结论,我不会编。全部数字标注为:官方文档口径 + 模型目录逐条核验 + 本机真实终端输出。等换到有效凭证跑完一个完整窗口,再补一篇带真实消耗曲线的实测账。
对同样准备订的团队,有一条可以直接写进流程的建议:下单之前,先用一条最便宜的调用验证凭证有效性。订阅类 Key 与按量 Key 是两套东西,过期不会有任何通知,用到那天才报 401。Key 的签发与更换入口在控制台密钥管理页。
订前核验清单:三条命令
把上面的核验过程压成一份可以直接抄的清单。前两条不需要订阅凭证:
# 1. 核模型 ID 是否真在目录里(不需要凭证)
bl model list --model qwen-image-3.0-pro --output json

# 2. 核配音音色(只列音色,不产生合成调用)
bl speech synthesize --config token-plan --model qwen-audio-3.0-tts-plus --list-voices

# 3. 下单前验凭证:一条最短的调用
bl text chat --config token-plan --message "用一句话介绍你自己"
第 3 条返回 401 就先别掏钱,回控制台重新取一把 Key;第 3 条能出结果,说明凭证有效,这时候谈档位选择才有意义。团队里最好把这三条固化成一个脚本,换人、换机器、换 Key 都跑一遍,哪一条挂了问题就落在哪一层。
什么样的团队适合,什么样的不适合
适合:产出节奏稳定(每周都有量)、AI 能力用得杂(文本+图像+语音+搜索同时在用)、希望把多供应商账单收敛成一份可核算的 Credits 支出。这三条同时成立时,统一计量单位带来的治理价值明显大于 7 天窗口带来的排期成本。
不适合:用量按月甚至按季度爆发(7 天窗口 + 不结转,额度大概率作废);只用单一模型且量很小(按量付费更好算账);团队里没人负责额度监控(触顶暂停需要有人当场处置)。
如果决定试,建议从 Lite 或 Standard 起步,跑完一个完整周期再定档——用真实的 Credits 消耗曲线决定升不升,而不是按宣传页的额度上限反推。自己账号的余量与消耗明细,以订阅页和控制台显示为准。