
一、前言
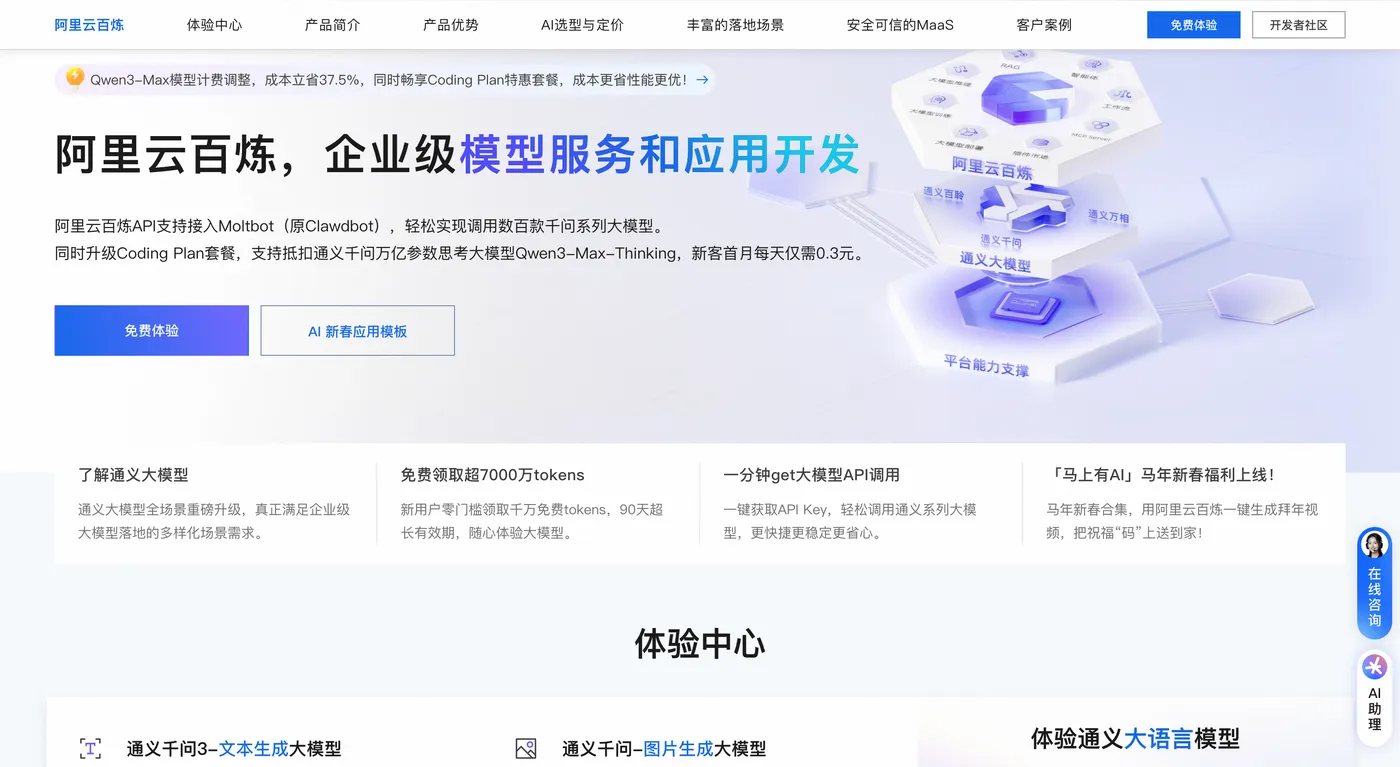
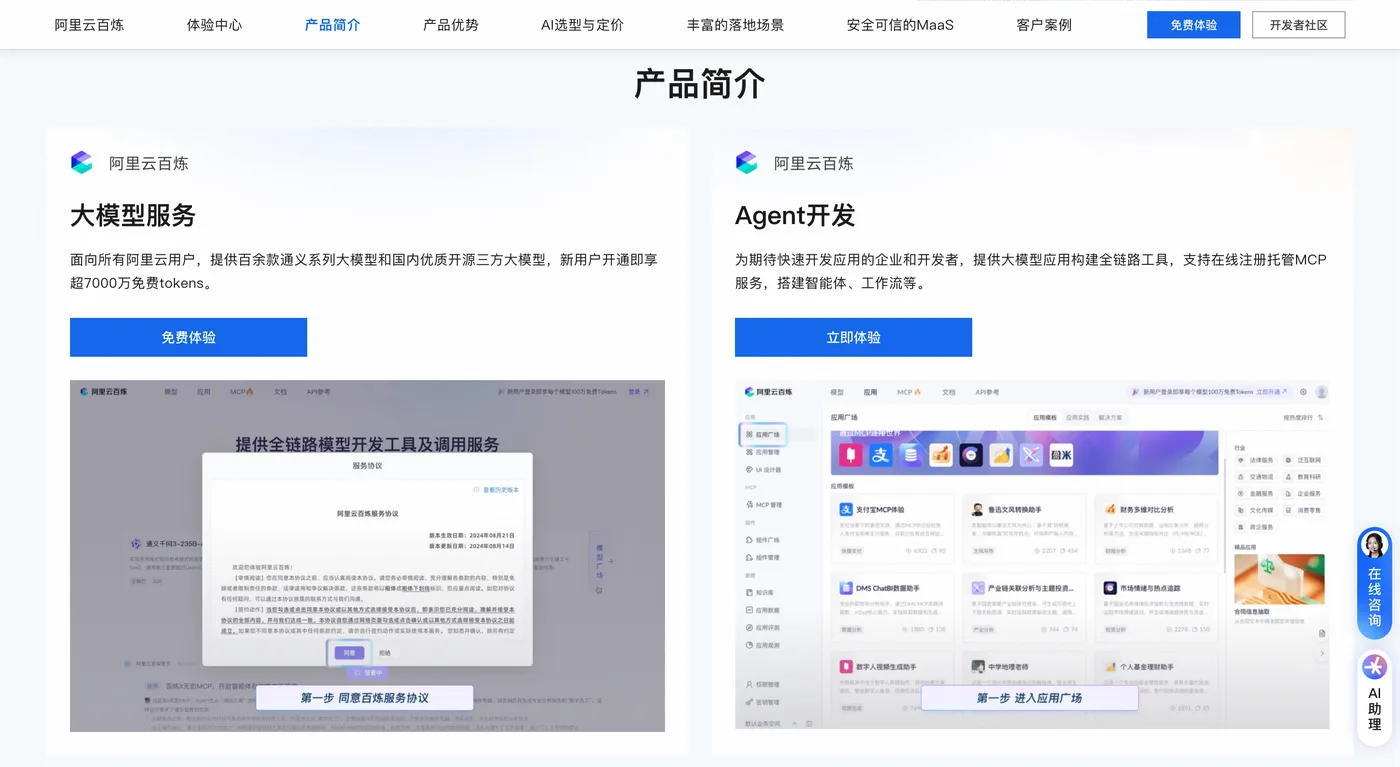
DeepSeek Harness 是一款功能强大的 AI 应用开发框架,能够帮助开发者快速构建基于大语言模型的智能应用。在本文中,我们将以 阿里云百炼大模型服务平台页面 为核心入口,从账号注册、API 获取、环境配置到实际项目部署,为您提供一站式的完整指南。无论您是初次接触大模型开发的新手,还是寻求高效集成方案的资深开发者,都能从本指南中获得实用的操作指导。
在开始之前,请您确保已有一个阿里云账号,并能够顺利访问 阿里云百炼大模型服务平台页面,以便后续所有操作都能顺利进行。
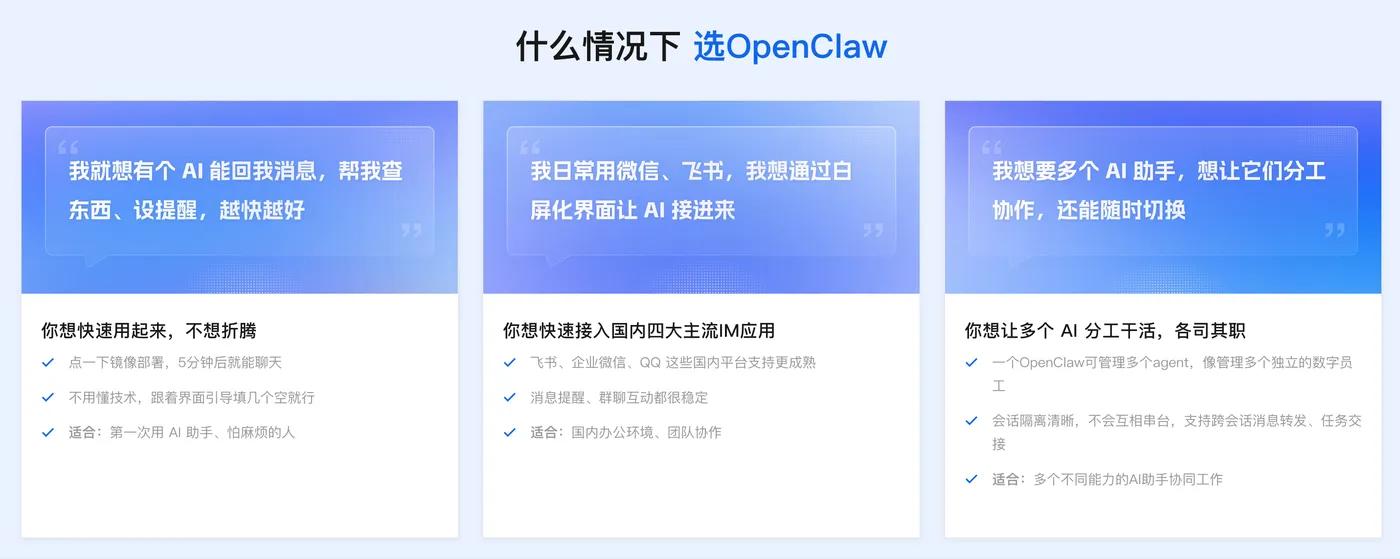
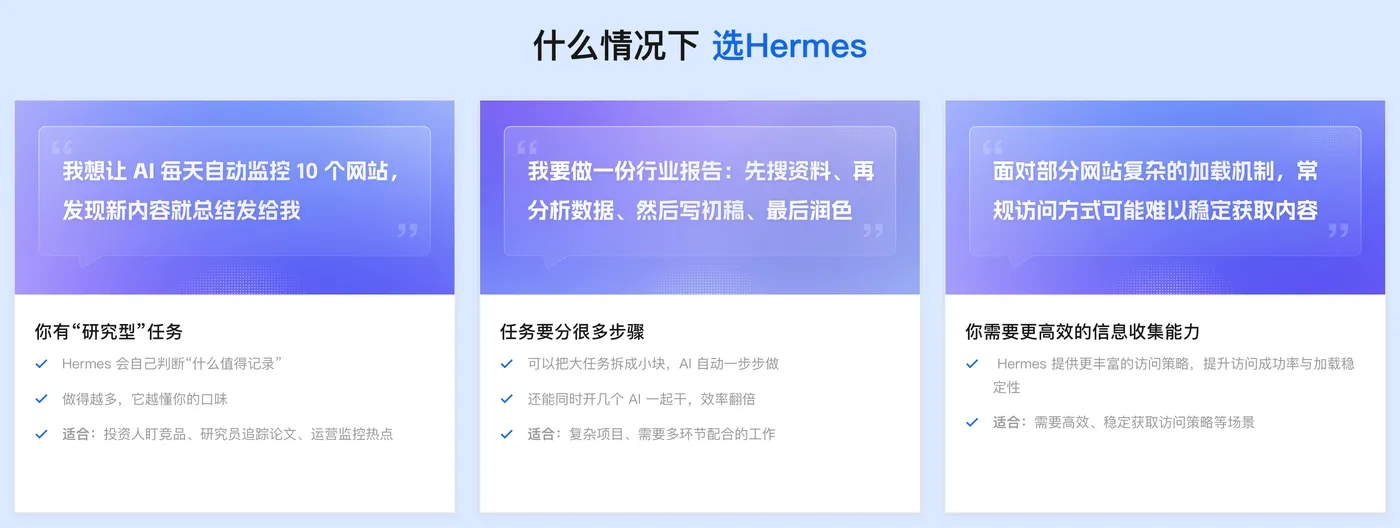
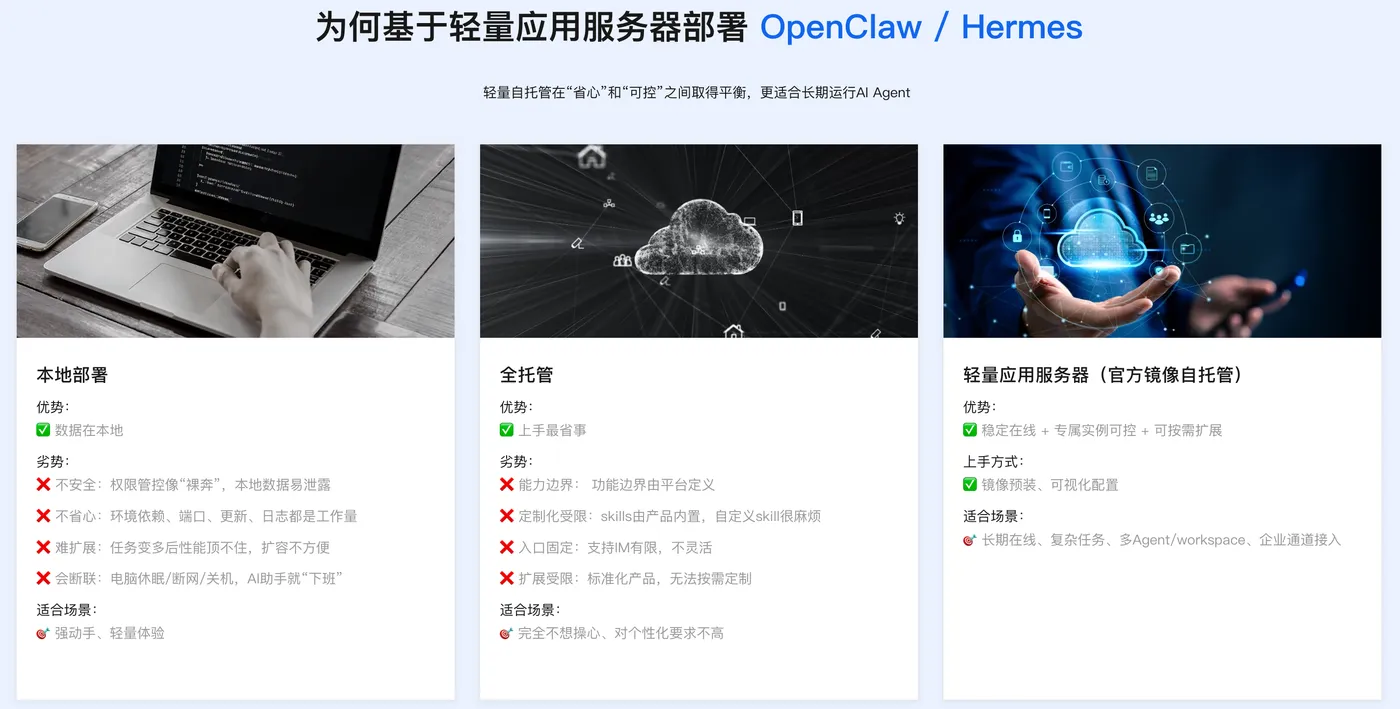
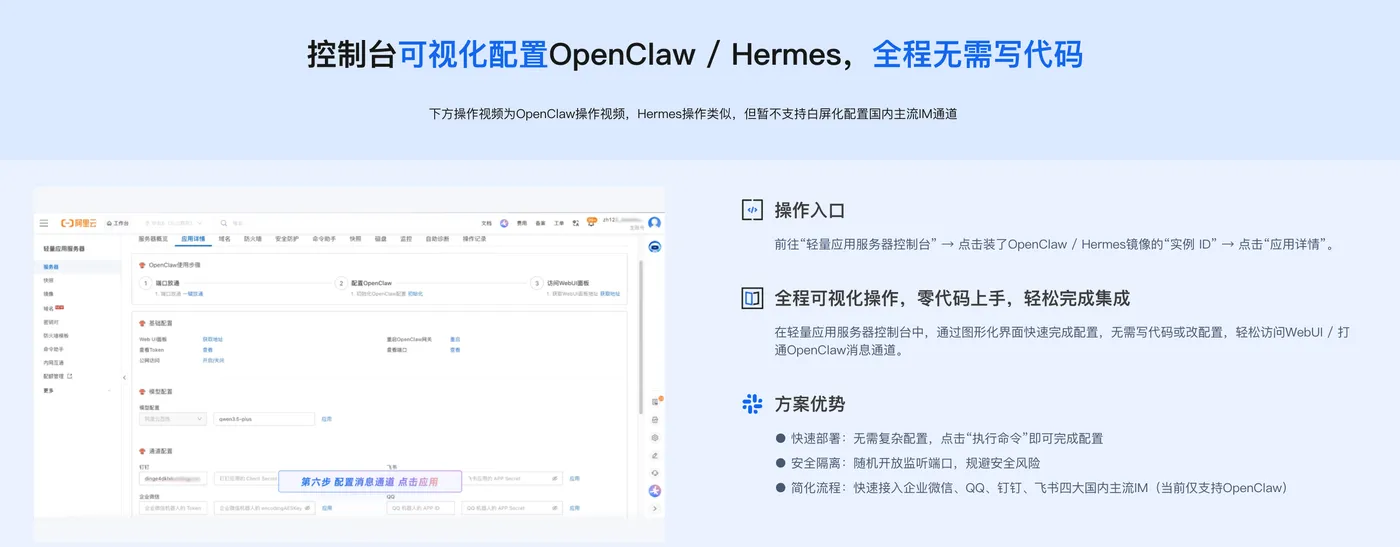
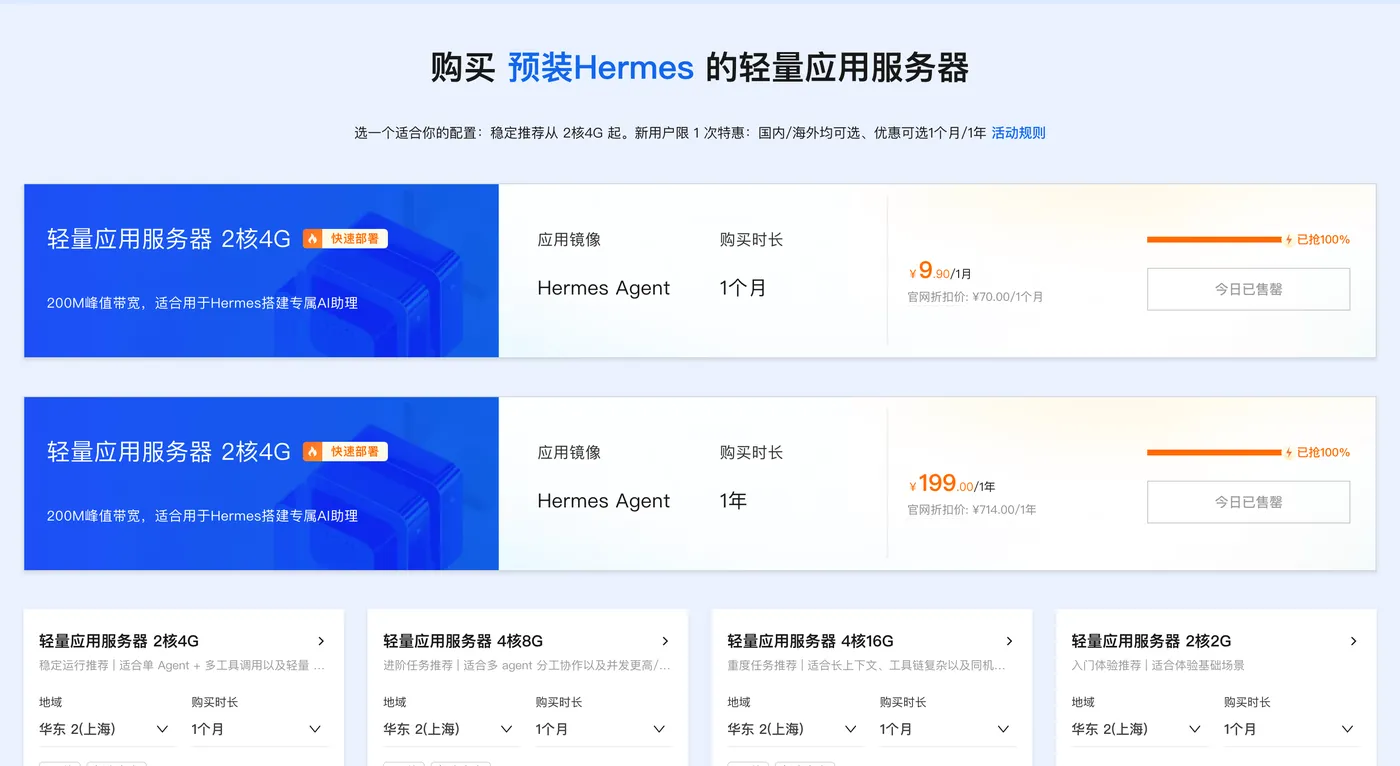
阿里云部署AI Agent:OpenClaw/Hermes Agent全网最简单,只需两步,详情👉访问阿里云OpenClaw/Hermes一键部署专题页面了解。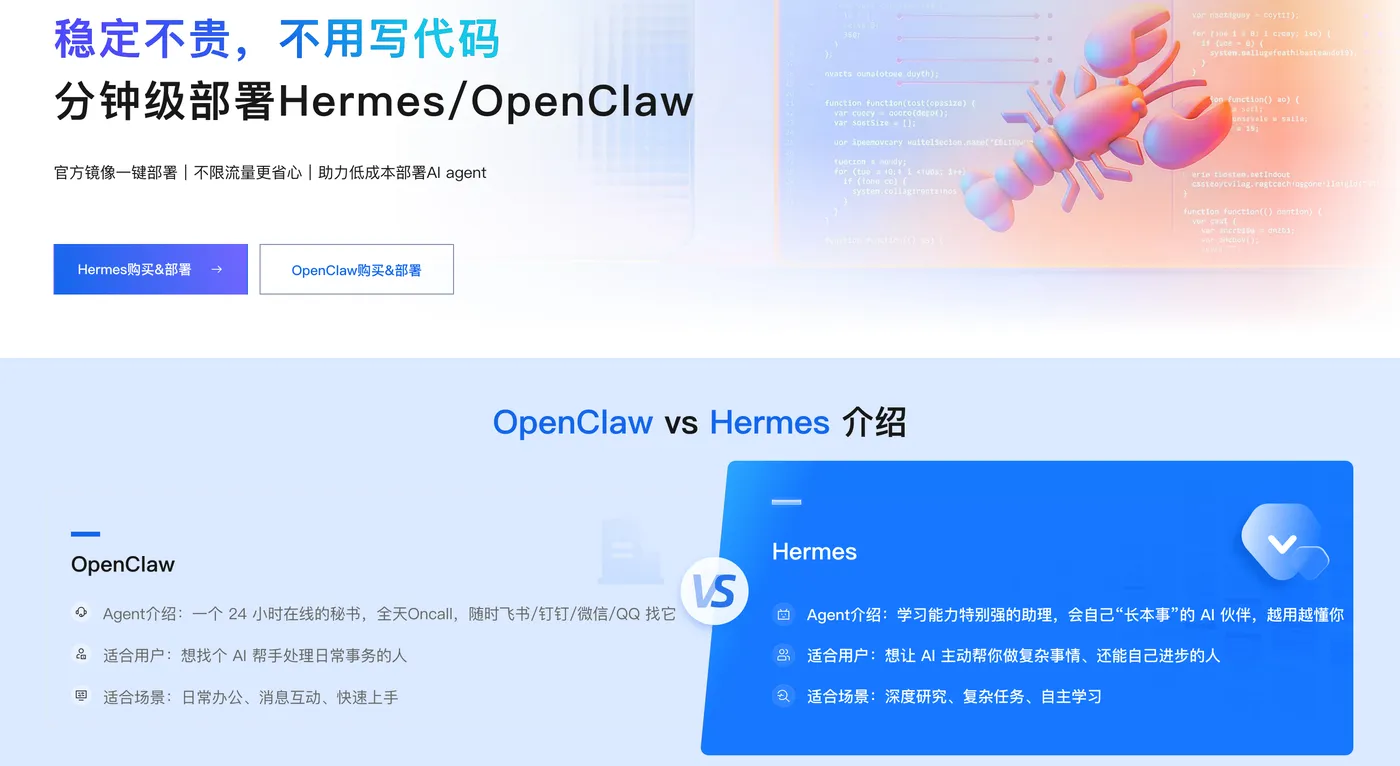
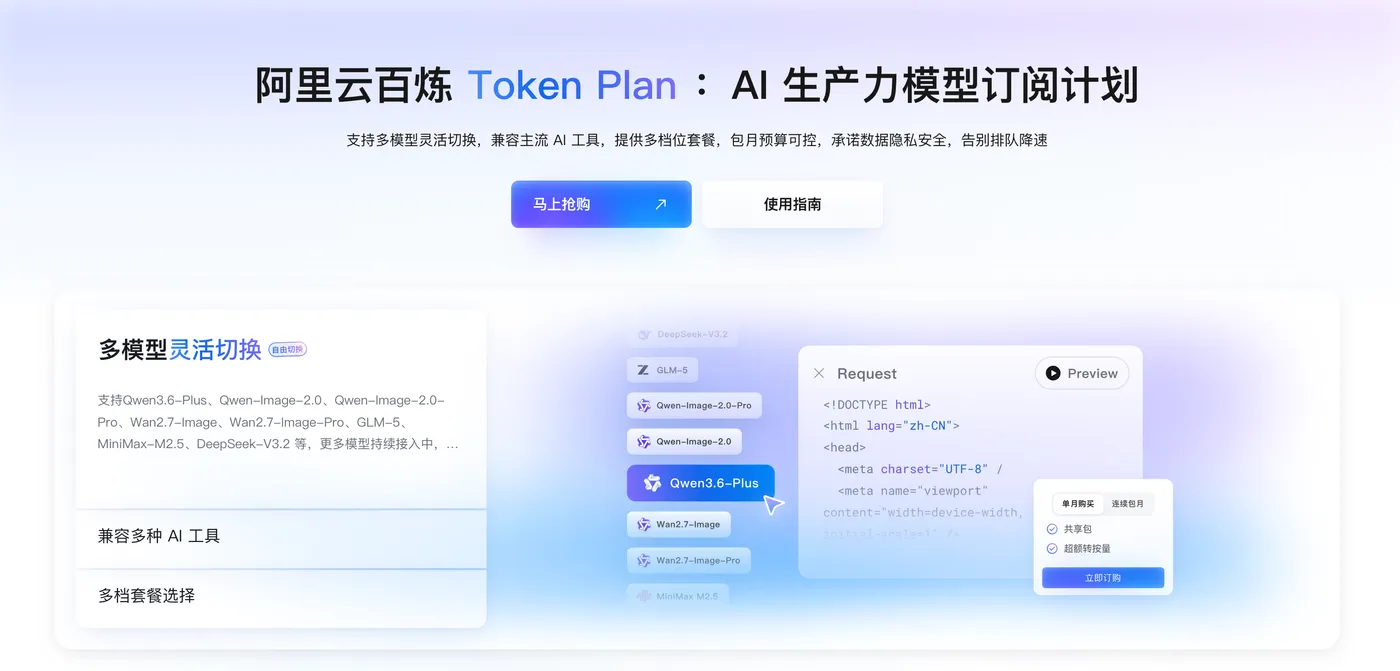
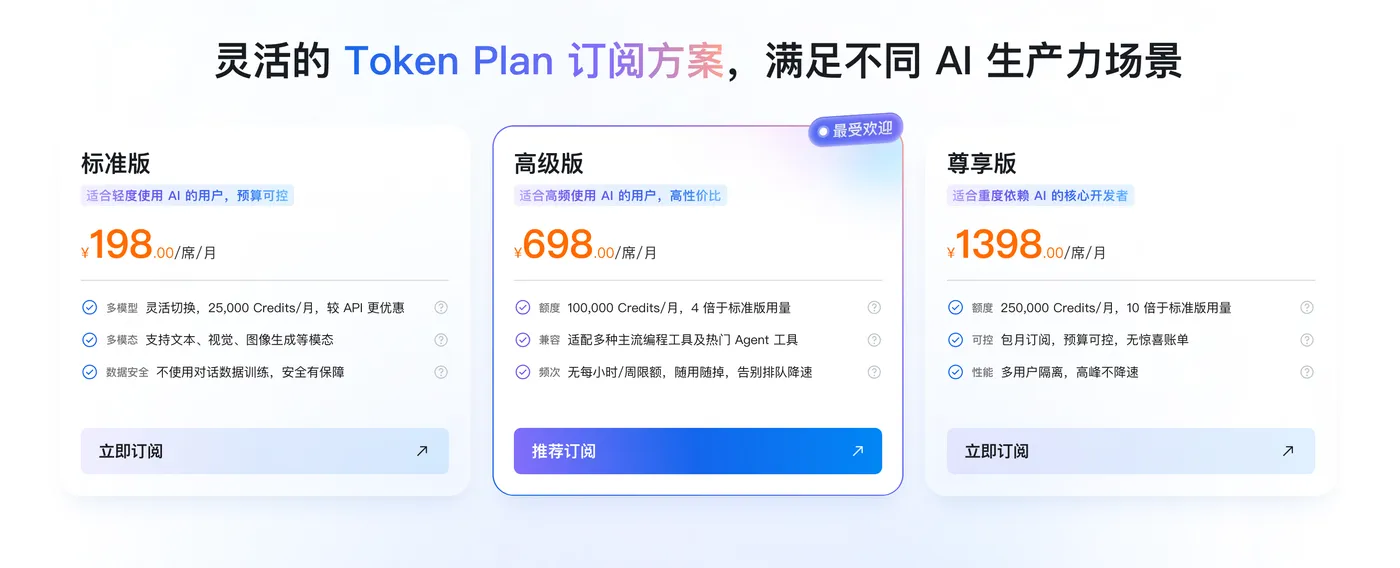
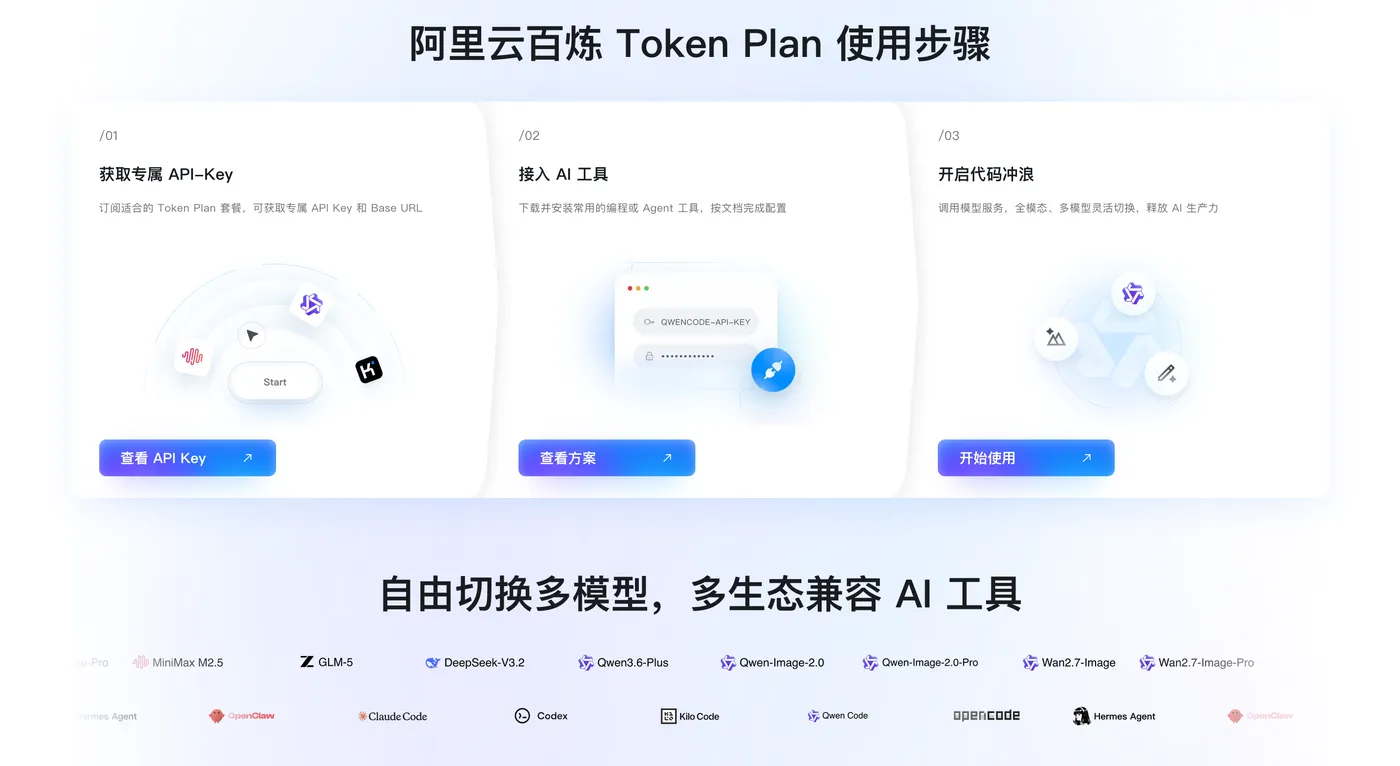
Token Plan Token 最便宜/支持多模型切换:👉访问订阅阿里云百炼Token Plan AI大模型服务 。支持多模型切换,用于多模态模型灵活调用,实现多模型、多工具、多场景下的额度共享与统一管理,兼顾灵活性、稳定性与安全性,大幅降低企业使用大模型的门槛与成本。
二、前期准备工作
在正式安装 DeepSeek Harness 之前,您需要完成以下几项基础准备工作:
- 注册并实名认证阿里云账号,确保您的账号具备大模型服务的开通权限
- 登录 阿里云百炼大模型服务平台页面,进入控制台主界面
- 在 阿里云百炼大模型服务平台页面 中开通"模型服务"相关产品,确认服务已生效
- 创建并获取 API Key,该密钥将用于后续 DeepSeek Harness 的模型调用鉴权
- 准备本地开发环境,包括 Python 3.8 及以上版本、pip 包管理工具以及 Git 版本控制工具
- 确认本地网络能够稳定访问阿里云 API 端点,避免因网络问题导致调用失败
完成以上准备后,您便可以正式进入安装环节。
三、DeepSeek Harness 安装步骤
3.1 通过 pip 安装
这是最简单、最推荐的安装方式,适用于绝大多数开发场景:
- 打开您的终端或命令行工具
- 输入以下安装命令:
- 等待安装过程完成,系统会自动下载并安装所有依赖包
- 安装成功后,在终端中输入以下命令验证安装是否成功:
- 如果正确输出版本号,说明安装已完成
3.2 通过源码安装
如果您希望对框架进行二次开发或查看源码,可以选择从源码进行安装:
- 打开终端,使用 Git 克隆官方仓库:
- 进入项目根目录:
- 创建并激活虚拟环境(强烈推荐):
python -m venv venv
source venv/bin/activate # Linux/Mac
venv\Scripts\activate # Windows
- 安装项目依赖:
- 安装完成后,同样通过版本命令进行验证
3.3 配置 API 密钥
安装完成后,您需要将从 阿里云百炼大模型服务平台页面 获取的 API Key 配置到 DeepSeek Harness 中:
- 在项目根目录下创建名为 .env 的环境变量文件
- 在文件中写入以下内容(将占位符替换为您的真实密钥):
DEEPSEEK_API_KEY=your-api-key-from-alibaba-cloud
DEEPSEEK_BASE_URL= https://dashscope.aliyuncs.com/compatible-mode/v1
- 保存文件并确保该文件不被提交到公开的代码仓库
- 如果您是通过 阿里云百炼大模型服务平台页面 直接创建的应用,也可以在平台提供的 SDK 配置向导中自动生成此配置
四、在阿里云百炼大模型服务平台页面创建应用
为了让 DeepSeek Harness 能够正常调用模型,您需要在 阿里云百炼大模型服务平台页面 中完成应用创建:
- 登录 阿里云百炼大模型服务平台页面
- 在左侧导航栏中选择"应用管理"或"我的应用"
- 点击"创建应用"按钮
- 填写应用基本信息,包括:
- 应用名称:建议使用具有辨识度的英文或中英文组合名称
- 应用描述:简要说明该应用的用途和功能
- 模型选择:在模型列表中选择 DeepSeek-V3 或其他您需要的模型版本
- 创建成功后,系统会为您生成一组 App ID 和 App Secret
- 将 App ID 和 App Secret 记录下来,后续集成时会用到
- 在 阿里云百炼大模型服务平台页面 的应用详情页中,还可以对应用进行微调、知识库挂载等高级配置
五、DeepSeek Harness 核心功能与使用
5.1 基础对话功能
DeepSeek Harness 提供了简洁的对话接口,以下是基本使用方法:
- 导入核心模块:
- 创建配置对象,填入从 阿里云百炼大模型服务平台页面 获取的凭证:
config = ChatConfig(
api_key="your-api-key",
base_url=" https://dashscope.aliyuncs.com/compatible-mode/v1",
model="deepseek-chat"
)
- 初始化 Harness 实例:
- 发送对话请求:
print(response.text)
- 获取流式输出(适用于需要实时展示的场景):
for chunk in harness.chat_stream("请帮我写一首关于春天的诗"):
print(chunk, end="")
5.2 多轮对话管理
在实际应用中,您往往需要维护多轮对话的上下文,DeepSeek Harness 原生支持此功能:
- 创建会话对象以追踪对话历史:
- 进行第一轮对话:
- 进行后续追问,系统会自动携带上下文:
- 查看完整对话历史:
history = session.get_history()
for msg in history:
print(f"{msg['role']}: {msg['content']}")
- 清除会话(当需要开始新话题时):
5.3 函数调用(Function Calling)
DeepSeek Harness 支持模型的函数调用能力,这在构建智能 Agent 时非常关键:
- 定义您的工具函数:
def get_weather(city: str) -> str:
return f"{city} 今天天气晴朗,气温 25°C"
def search_news(keyword: str) -> str:
return f"关于 '{keyword}' 的最新资讯已为您检索到 10 条结果"
- 将函数注册到 Harness 实例:
harness.register_tool(get_weather)
harness.register_tool(search_news)
- 使用带工具的对话模式:
- 查看模型调用了哪些工具:
for tool_call in response.tool_calls:
print(f"调用工具: {tool_call.name}, 参数: {tool_call.arguments}")
- 获取工具执行后的最终回答:
5.4 知识库挂载与 RAG 检索增强
通过 阿里云百炼大模型服务平台页面,您可以为应用挂载自定义知识库,再结合 DeepSeek Harness 实现 RAG 能力:
- 在 阿里云百炼大模型服务平台页面 的应用设置中,进入"知识库"模块
- 上传您的文档资料(支持 PDF、Word、TXT、Markdown 等多种格式)
- 等待知识库索引构建完成
- 在 DeepSeek Harness 中配置知识库参数:
config = ChatConfig(
api_key="your-api-key",
knowledge_base_id="your-kb-id-from-alibaba-cloud"
)
- 发起带知识库的查询:
- 模型会自动从知识库中检索相关内容并生成回答,大幅提升回答的准确性和专业性
六、高级配置与优化
6.1 模型参数调优
您可以通过调整以下参数来控制模型的输出行为:
- temperature(温度值):控制输出的随机性,范围通常为 0 到 2,值越高输出越具创造性,默认值为 0.7
- top_p(核采样):与 temperature 配合使用,建议二选一调整,值越小输出越确定
- max_tokens(最大令牌数):限制单次回复的最大长度,根据实际需求设置
- frequency_penalty(频率惩罚):减少模型重复使用相同词汇的倾向,值范围为 -2 到 2
- presence_penalty(存在惩罚):鼓励模型引入新话题,值范围为 -2 到 2
- stop(停止序列):指定模型在遇到特定字符串时停止生成
在代码中使用示例:
config = ChatConfig(
temperature=0.5,
top_p=0.9,
max_tokens=2048,
frequency_penalty=0.3,
presence_penalty=0.2
)
6.2 请求重试与容错机制
为了保证服务的稳定性,DeepSeek Harness 内置了重试机制:
- 默认情况下,框架会在遇到网络超时或服务端错误时自动重试 3 次
- 您可以自定义重试策略:
config = ChatConfig(
max_retries=5,
retry_delay=2.0, # 每次重试间隔 2 秒
retry_backoff=True # 启用指数退避策略
)
- 对于高频调用场景,建议在代码中加入限流逻辑
- 同时建议在 阿里云百炼大模型服务平台页面 中查看您的调用配额和使用情况,避免超额
6.3 日志与监控
良好的日志记录能够帮助您快速定位问题:
- 开启调试日志:
import logging
logging.basicConfig(level=logging.DEBUG)
- 记录每次 API 调用的请求参数和响应时间:
- 定期查看 阿里云百炼大模型服务平台页面 中的用量统计和调用报告
- 设置告警阈值,当调用量或错误率超过预设值时及时处理
- 结合阿里云的云监控服务,实现全方位的应用性能监控
七、常见问题与解决方案
在使用过程中,您可能会遇到以下常见问题:
- API 调用返回 401 错误:请检查您的 API Key 是否正确,确认该密钥是从 阿里云百炼大模型服务平台页面 正确复制的,并注意不要有多余的空格
- 模型响应速度慢:可能是当前时段调用量较大,建议错峰使用或在 阿里云百炼大模型服务平台页面 查看服务状态公告
- 安装依赖失败:尝试升级 pip 版本后重新安装,或使用国内镜像源加速下载
- 流式输出中断:检查网络连接是否稳定,可适当增加超时时间设置
- 知识库检索不到内容:确认知识库已完成索引构建,并在 阿里云百炼大模型服务平台页面 中检查文档解析状态
- 函数调用不生效:确保函数签名和参数描述清晰准确,模型需要足够的信息来判断何时调用哪个函数
- 版本兼容性问题:确保您使用的 DeepSeek Harness 版本与 Python 版本兼容,建议使用 Python 3.9 或 3.10
八、最佳实践建议
为了帮助您更高效地使用 DeepSeek Harness,以下是一些经过验证的最佳实践:
- 始终通过环境变量或安全的配置文件管理 API 密钥,切勿将密钥硬编码在源代码中
- 在正式部署前,先在 阿里云百炼大模型服务平台页面 的测试环境中进行充分验证
- 合理规划会话管理策略,对于高并发场景建议使用 Redis 等外部存储管理会话状态
- 对用户输入进行必要的过滤和校验,防止恶意输入导致异常
- 定期更新 DeepSeek Harness 框架版本,以获取最新的功能和安全修复
- 善用 阿里云百炼大模型服务平台页面 提供的模型对比功能,选择最适合您业务场景的模型版本
- 在生产环境中启用请求日志和错误追踪,便于后续运维和优化
- 对于涉及敏感数据的应用,建议在 阿里云百炼大模型服务平台页面 中开启数据加密传输和访问控制
九、总结
通过本指南,您已经全面了解了 DeepSeek Harness 从安装、配置到实际使用的完整流程。整个过程以 阿里云百炼大模型服务平台页面 为核心支撑平台,涵盖了账号创建、API 获取、应用配置、模型调用、高级优化等各个环节。
核心要点回顾如下:
- 安装方式灵活,pip 安装最为便捷,源码安装适合深度定制
- API 密钥和 Base URL 需正确配置,均可从 阿里云百炼大模型服务平台页面 获取
- 基础对话、多轮会话、函数调用、RAG 知识库四大核心功能覆盖主流应用场景
- 通过参数调优、重试机制和日志监控可以显著提升应用的稳定性和用户体验
- 遇到问题时优先查阅 阿里云百炼大模型服务平台页面 的官方文档和社区支持
希望本指南能够成为您在 AI 应用开发道路上的得力助手。祝您开发顺利!

