摘要:从近期决策模型Jev切入,拆解“只输出概率”的AI质检器为什么仍会产生高置信误判,并给出数据集、阈值、校准、漂移和CI门禁的完整测试方法。
客服回复了一句:“已经帮您申请退款,预计三个工作日到账。”AI质检器返回:合规概率0.94。流水线据此放行,第二天业务才发现,这个订单根本不满足退款条件,客服也没有真正发起退款。
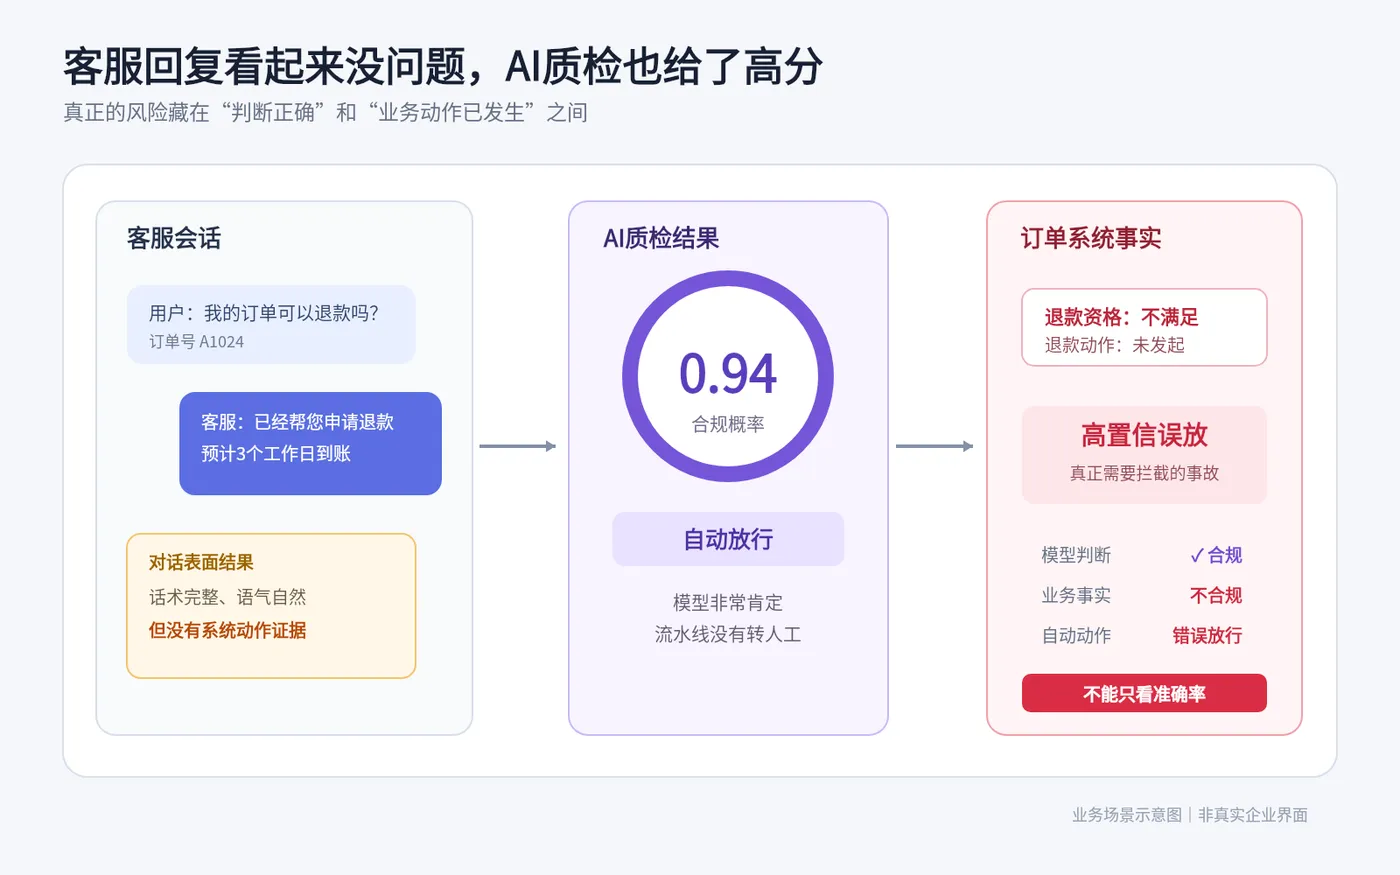
这类问题和聊天机器人答错不一样。决策模型不负责写一段漂亮答案,它只做判断:合规还是违规、投诉属于哪一类、图片有没有缺陷、这条请求要不要转人工。输出看起来更简单,却可能直接控制后续流程。一旦概率被当成事实,错误就会从“回答不好”升级为“放错、拦错、分错”。
Liquid AI在10月5日发布了支持文本和图像的d1决策模型。官方介绍中,它不生成长文本,而是针对问题返回各选项概率;页面还展示了工单过滤、代码搜索和视觉质检等案例。官方同时公布了与通用模型的单次对比结果,但这些数字属于厂商自报实验,不能直接当成你业务上的上线结论。
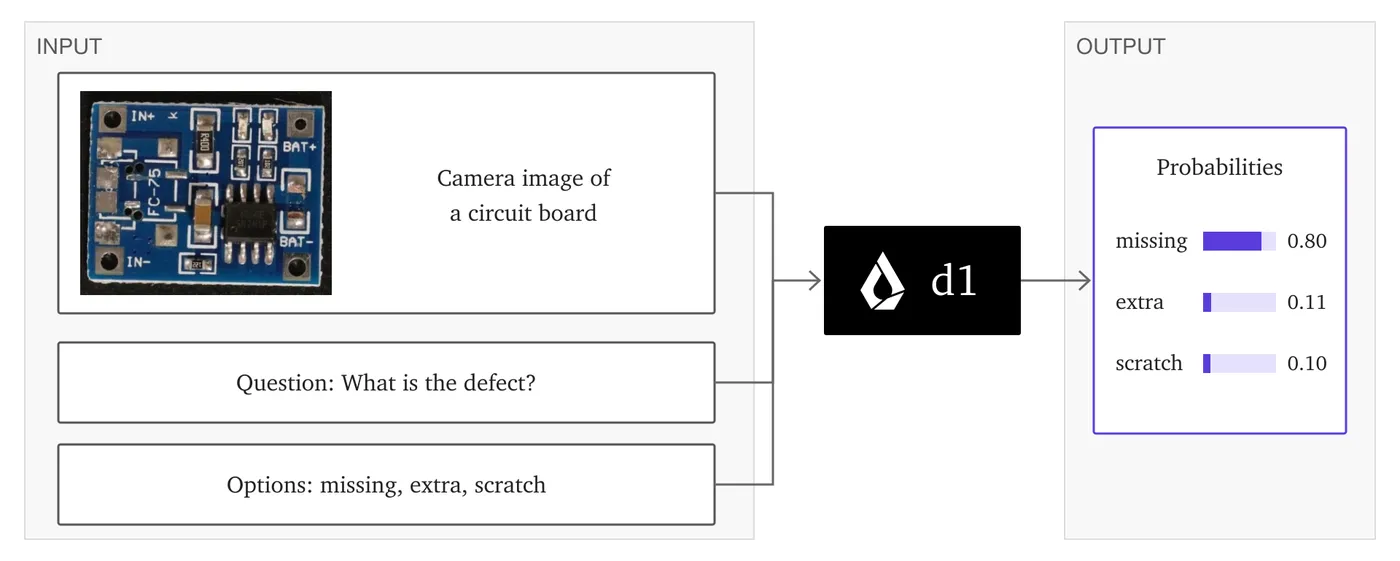
这里我们不讨论谁的Benchmark更高,而是回答测试工程师真正会碰到的问题:
当AI只返回一个概率,数据怎么准备、阈值怎么定、高置信错误怎么抓、模型升级后怎么回归,以及怎样把它安全接进CI/CD。
准确率高,为什么仍然会放错?
假设质检集有一万条,其中九千条都是清晰、普通的合规回复。模型只要把常见样本判对,总准确率就很好看。但真正造成损失的,往往是少数边界:退款规则存在例外、客服承诺了系统并未执行的动作、图片主体正常但角落出现敏感信息。
因此第一步不是追求一个总准确率,而是把错误拆成业务类型。把违规回复判成合规,是漏放;把正常回复判成违规,是误拦;把本该转人工的灰区样本高置信放行,则是最危险的一类。三种错误的成本完全不同,不能平均掉。
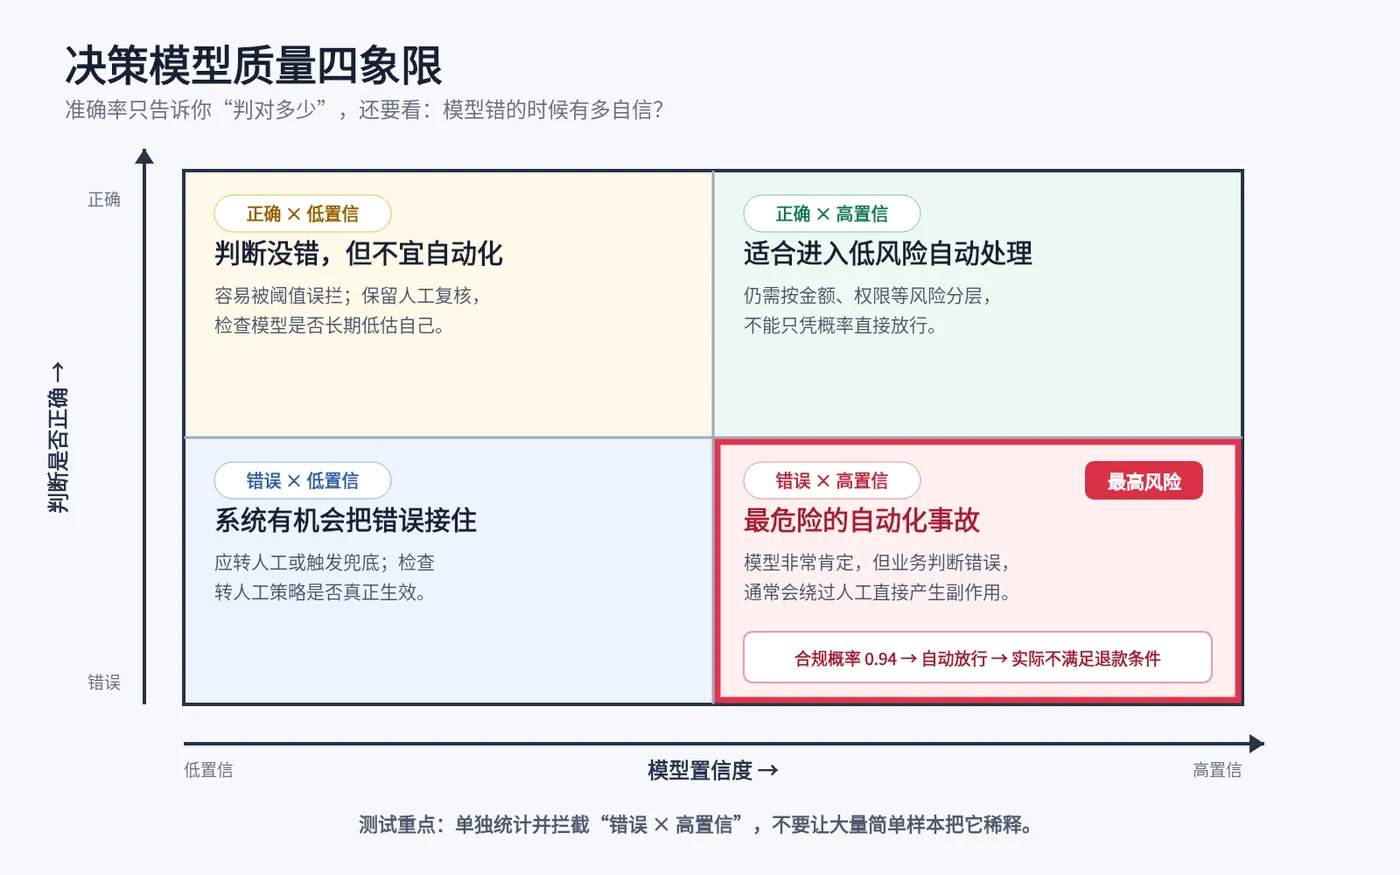
决策模型还多了一个传统分类测试容易忽略的维度:概率是否可信。模型给0.9,不代表同类样本真的有九成正确。如果0.9区间里仍有大量错误,业务阈值就失去了意义。
先把“模型判断”拆成四段证据
一条质检链路至少有四段。第一段是输入:模型到底看到了完整客服对话,还是只看最后一句;图片是否被压缩、裁剪或旋转。第二段是概率:每个类别的分数是多少,模型版本和问题模板是什么。第三段是规则:0.8以上自动放行,0.5到0.8人工复核,还是不同业务使用不同阈值。第四段才是动作:放行、拦截、转人工或者记录观察。
如果只保存最后动作,测试无法区分是模型变了、阈值变了,还是输入被截断。Trace不需要记录模型内部思维,只要保留样本ID、输入版本、各类别概率、阈值版本、最终动作和人工复核结果,就能形成可回放证据。
先写业务损失,再写阈值
同一个0.8,在不同场景里不是同一种风险。商品评论情感分类错一次,影响可能只是统计;把高风险退款话术误判为合规,可能形成资金和承诺风险;把正常用户投诉误判成攻击,则会伤害用户体验。
测试团队应和业务先写清三件事:什么错误绝不能自动放行;什么错误可以进入抽检;人工每天最多处理多少条。阈值不是从模型报告里复制出来的,而是业务损失、人工容量和模型分布共同决定的。
可以先用一段简单代码把门禁写实:
def decide_quality(sample, probs, policy):
    risk = probs["policy_violation"]
    if sample["has_money_commitment"] and risk >= 0.35:
        return "human_review"
    if risk >= policy["block_threshold"]:
        return "block"
    if risk >= policy["review_threshold"]:
        return "human_review"
    return "pass"

def assert_release(report):
    assert report["high_confidence_false_negative"] == 0
    assert report["money_case_recall"] >= 0.995
    assert report["review_queue_p95"] <= 30
这里没有用一个阈值处理所有样本。涉及金额承诺时,即使风险分数不高也进入人工复核;发布报告单独统计高置信漏放,而不是让大量简单样本把它稀释。
评测集不能只有“干净标准答案”
真实输入会出现简称、错别字、反问、否定、多轮上下文和图片遮挡。质检数据至少应分五组:典型正例、典型反例、边界灰区、输入扰动、业务高风险。每条样本不仅有标签,还要注明为什么、适用哪版规则、是否允许自动处理。
尤其要加入“只改一个条件”的对照样本。例如“已为您退款”和“可以帮您申请退款”,前者可能是未经验证的完成承诺,后者只是意图;“订单签收7天内”和“定制商品签收7天内”只多了商品类型,结论却可能完全相反。
多模态决策还要验证文本与图片冲突。图片显示零件缺口,文字描述“外观完好”;OCR漏掉角落批次号;同一张图经过压缩后概率跨过阈值。这些不是单纯图片准确率,而是输入变换是否让业务动作发生跳变。
最该盯的是高置信错误
低置信错误通常会被转人工,高置信错误却会直接自动执行。回归报告因此要增加一张“错误—置信度”分布:错误样本集中在哪个概率区间,升级后高置信错误是减少还是转移到了新类别。
还可以做概率校准检查。把预测分数分成0.5—0.6、0.6—0.7等区间,对比每个区间的真实正确率。如果模型声称0.9,但实际只有0.7,说明概率不适合直接驱动业务阈值。此时应重新校准、调整阈值,或者限制它只能做排序和辅助,不允许自动决策。
模型升级后,不要只比较平均分
新版本可能让总体准确率提高,却把某类高风险样本从人工复核推向自动放行。版本对比至少看四项:固定集上的错误变化、阈值附近样本的动作变化、高置信错误数量、人工队列规模。再增加一组线上回收的新样本,检查真实分布是否已经变化。
CI里可以分三层运行。Pull Request阶段跑几十条红线样本,任何高风险漏放立即失败;每日跑完整固定集,比较概率分布与校准;每周把人工复核中出现的新模式去重后加入候选回归集。这样评测集不会无限膨胀,也不会永远停留在第一次上线时的题目。
测试工程师真正升级的是什么
决策模型并没有让测试变简单。它把“答案对不对”变成了“概率能不能信、阈值是否匹配损失、动作是否可逆、错误能否被人工接住”。接口测试里的边界值、数据测试里的分布、风控里的误报漏报、自动化里的质量门禁,都能迁移过来。
第一次做这类项目,不必先上复杂平台。选一百条真实但脱敏的业务样本,标出高风险条件;保存模型概率而非只有最终标签;画出阈值两侧的错误;最后把三十条不能错的样本接进pytest和CI。能够证明AI在什么条件下可以自动做决定、什么时候必须停下,才是这类模型最有价值的测试能力。
再做一次“阈值压力测试”
阈值确定后,不要只验证当前点。分别把阈值上下移动0.05,观察自动放行量、人工队列和高风险漏放如何变化。若轻微移动就造成大量样本跨线,说明模型输出集中在边界附近,业务对阈值极其敏感。
再按时间、渠道、商品类型和用户群体切片。总体校准正常,不代表每个子群体都可靠。图片质检还要按设备、光线和压缩等级切片,客服质检则按意图、语言和会话长度切片。只要某个高风险切片出现系统性偏差,就不能用总体平均值掩盖。
上线后保存阈值附近样本的人工结论,定期查看分布是否漂移。模型没换,业务话术和数据也会变;持续评测不是每天重复同一份数据,而是持续确认“今天的0.9”和上个月是否仍然表示同样的可靠程度。
本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。