摘要:
做 RAG 时,一个很常见的问题是:
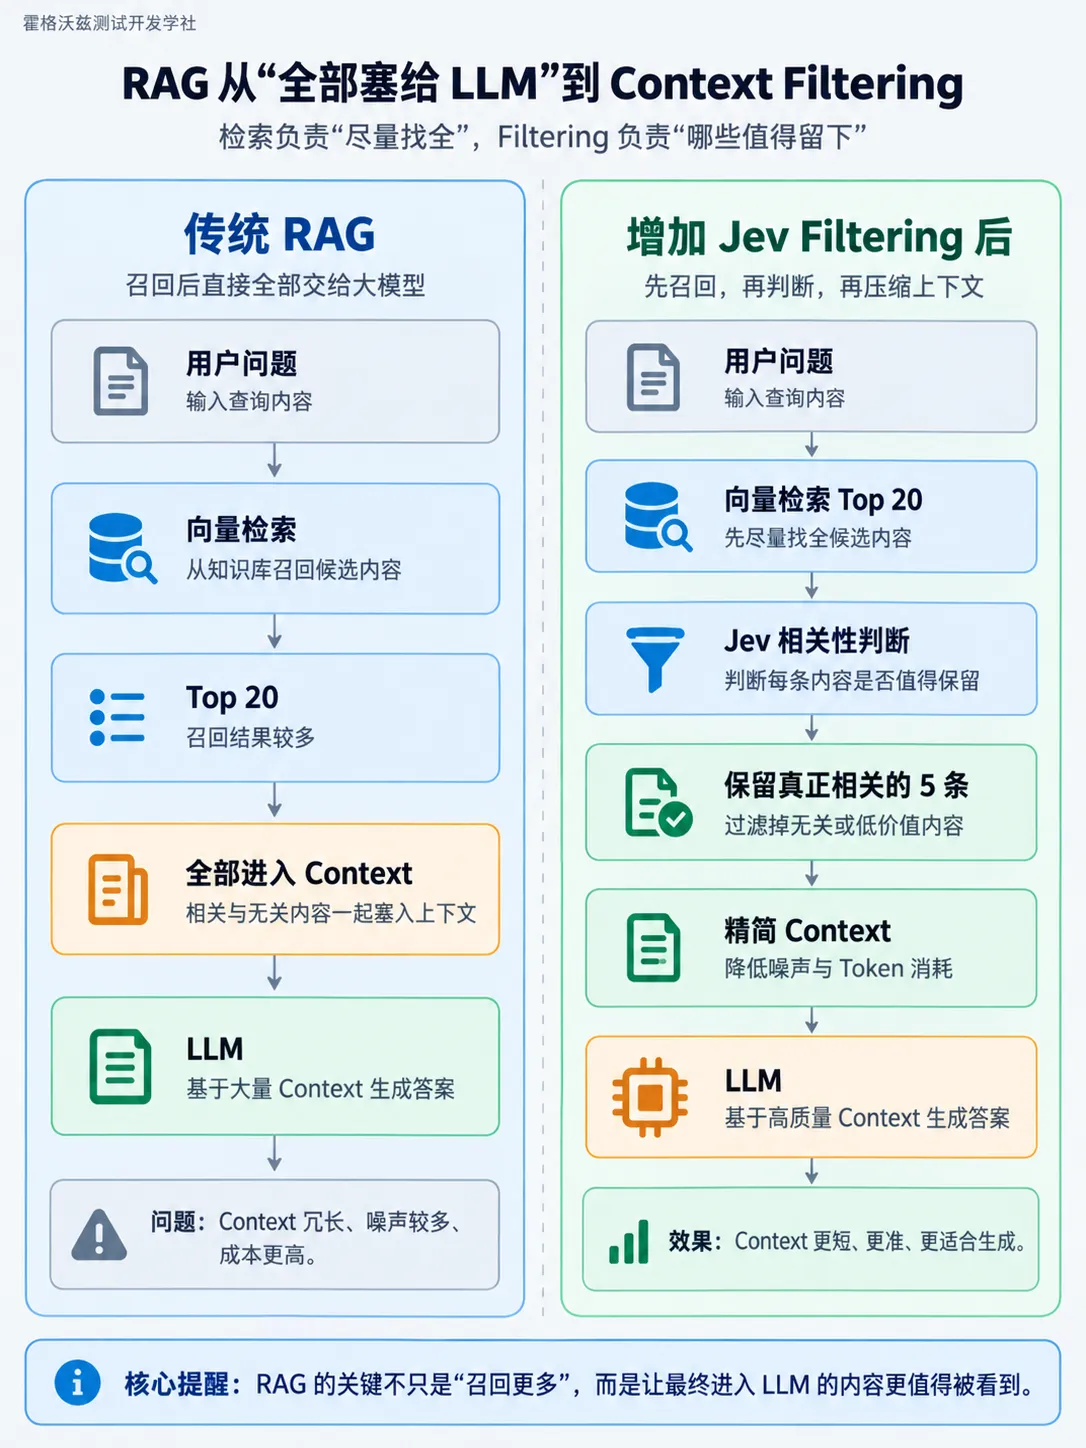
检索能召回很多内容,但真正应该塞进 LLM 的,其实只有少数几条。
传统方案会用 Embedding 阈值、Cross-Encoder Reranker,或者再调用一次 LLM 做筛选。
Jev 出现以后,又多了一种值得研究的思路:
检索负责“尽量找全”,Jev 负责“哪些值得留下”,LLM 最后只处理真正相关的 Context。
一、RAG 的问题,很多时候不是“没找到”
一个最简单的 RAG 流程通常是:
用户问题
↓
向量检索
↓
Top 10 文档
↓
全部塞给 LLM
↓
生成答案
看起来没问题。
但实际做过 RAG 的同学应该都遇到过:
Top 10 并不等于 10 条都有用。
可能真正相关的只有 3 条。
剩下的内容只是:
- 关键词相似
- 属于同一个业务模块
- 提到了相同实体
- 语义接近,但回答不了当前问题
LangChain 很早就把这个问题总结为 Contextual Compression:检索可以偏召回率,但进入 LLM 前还需要把无关文档过滤掉,只保留真正相关的信息。
所以一个成熟的 RAG,其实更像:
Retrieve
↓
Filter / Rerank
↓
Context
↓
Generate
而不是:
Retrieve → 全部塞给 LLM。
二、为什么 Context 越多,效果不一定越好?
很多人第一次优化 RAG,会本能地:
Top 5 不够,那我改成 Top 20。
但 Context 并不是越多越好。
无关内容会带来两个直接问题:
第一,增加 Token 成本
本来只需要 3 个 Chunk,
结果传进去 20 个。
每次生成都在为大量无关 Context 付费。
第二,干扰模型判断
LLM 面对的信息越杂,
越有可能从“看起来相关、实际上无关”的内容里找到错误依据。
Vercel 的 RAG 指南也建议通过相关性阈值过滤低质量结果,并限制最终传入模型的 Context 数量,而不是无限增加召回结果。
所以真正的目标不是:
召回越多越好。
而是:
进入 LLM 的 Context 越准越好。
三、传统 Rerank 是怎么解决这个问题的?
今天比较常见的一种架构是:
用户 Query
↓
向量库召回 Top 50
↓
Reranker
↓
重新计算相关性
↓
Top 5
↓
LLM
例如 Cross-Encoder Reranker。
它会同时阅读:
Query + Document
再重新判断相关性。
Vercel AI SDK 和 LangChain 目前都已经提供专门的 Rerank 能力,用来重新排列检索结果并减少无关 Context。
这种方案很成熟。
但现在还有另外一种情况。
有时候我们真正需要的并不是:
把 20 篇文档严格排出第 1~20 名。
而只是:
这条内容到底要不要进入 Context?
这其实就从:
Ranking Problem
变成了:
Decision Problem。
而这恰好是 Jev 比较有意思的地方。
四、Jev 能不能放到 RAG 中间做 Context Filtering?
理论上是可以尝试的。
Jev 当前提供的核心能力包括:
Choice、Score、Boolean,并返回相应概率;Vercel 对它的定位也主要是 classification、routing、scoring 和 verification 这类结构化判断。
那么对于一条召回的 Chunk,可以问:
用户问题:
Jev 为什么适合 Agent Routing?

候选文档:
......

问题:
这段内容是否能够直接帮助回答用户问题?

是:91%
否:9%
程序就可以直接做:
相关性 > 80%
→ 保留

50%~80%
→ 降低优先级

< 50%
→ 删除
于是整个 RAG 可以变成:
五、它和 Reranker 不是一回事
这里一定要区分清楚。
Reranker 更擅长:
这 20 篇文档,谁应该排在前面?
结果可能是:
Chunk A:0.96
Chunk C:0.91
Chunk F:0.87
Chunk B:0.74
……
核心是:
排序。
而 Jev 更适合被设计成:
这条 Chunk 是否满足某个明确条件?
例如同时判断:
与问题相关吗?

包含直接证据吗?

是否来自正确产品版本?

是否值得进入最终 Context?
最后返回结构化结果。
所以更准确地说:
Jev 更像 Context Decision Layer,而不是传统意义上的专用 Reranker。
目前 TypeSafe 和 Vercel 的官方资料也没有把 Jev 定义成专门的 RAG Reranking 模型,它的公开定位仍然是通用的软件决策模型。([TypeSafe AI][5])
这一点很重要。
不要因为 Jev 很快,就把:
Embedding、Reranker、LLM
全部替掉。
六、真正有意思的是:一次可以判断多个维度
Context Filtering 还有一个优势:
相关性不一定只有一个维度。
例如企业知识库里召回一篇文档。
它可能:
语义非常相关,但已经过期。
或者:
内容正确,但属于另一个产品版本。
所以最终是否进入 Context,可以拆成:
问题相关性:92%

版本匹配:34%

信息是否过期:87%

是否包含直接证据:76%
程序再根据业务策略决定:
相关性高
+
版本匹配
+
没有过期
↓
进入最终 Context
Jev 支持在同一次 Evaluation 中并行评估多个声明的问题,这种“多条件判断”正好比较适合软件工作流。([Vercel][6])
七、未来的 RAG 可能变成五层

注意这里我没有:
用 Jev 替代 Reranker。
而是把它放成一个可选的判断层。
在简单系统中:
Retriever
→ Jev
→ LLM
可能已经够用。
复杂系统则可能是:
Retriever
→ Reranker
→ Jev
→ LLM
两者并不冲突。
八、什么时候 Jev Filtering 可能更合适?
我认为至少有三种情况值得尝试。
1. 判断规则不只是“语义相似度”
比如:
必须同时满足当前版本、当前产品、含直接证据。
这已经不是简单的 Embedding 相似度了。
2. 需要可编程的判断结果
例如:
relevant = true
version_match = true
contains_evidence = false
业务系统需要直接根据结果走不同流程。
3. RAG 是 Agent 的一部分
Agent 可能要继续决定:
证据够不够?

是否需要重新检索?

是否换知识库?

是否询问用户?

是否进入深度搜索?
这时候 Context Filtering 本身就开始和:
Agent Decision
合到一起了。
九、从测试角度,这一层也必须单独评测
一旦 Jev 真正进入 RAG Pipeline,
测试工程师就不能只看:
最终回答对不对。
还需要单测 Filtering。
例如准备一组标注数据:
1000 个 Query-Chunk Pair

人工标注:
相关 / 不相关
然后测试:
该留下的,有没有被删掉?
这是 False Negative。
而且通常风险很大。
因为:
后面的 LLM 再聪明,也无法使用一段已经被过滤掉的正确证据。
不该留下的,有没有混进去?
这是 False Positive。
会增加:
Token、噪声和幻觉风险。
所以 Context Filtering 最关键的指标应该包括:
Recall
Precision
误过滤率
Context 压缩率
最终 Answer Accuracy
千万不能只追求:
Context 越短越好。
写在最后
所以回到标题:
Jev 能不能做 Context Filtering?
我的理解是:
值得试,但不要简单把它理解成“一个更便宜的 Reranker”。
Reranker 解决的是:
谁更相关?
而 Decision Model 更有价值的问题可能是:
这段内容到底应不应该进入下一步?
这背后其实又回到了 Jev 整个系列一直在讲的一条主线:
过去我们习惯:
数据
↓
全部给 LLM
现在越来越多 AI 系统开始变成:
先检索
↓
再过滤
↓
再判断
↓
最后才推理
真正成熟的 RAG,
可能不是不断给 LLM 塞更多 Context。
而是让模型最终看到的每一段 Context,
都更值得被看到。