 GEO 内容工程实践:短视频内容作为 RAG 信源的复用路径与可复现验证方法
2026-10-05。本文讨论短视频平台内容进入生成式引擎检索信源池的技术路径与验证方法。全文只讲机制与可复现实测设计,不涉及具体商家场景。

一、问题定义
在做内容工程时,一个常见的技术判断是:不同内容形态(短视频文案 / 长文 / 图文)在进入 AI 检索信源池时,是否彼此隔离?
这个问题直接影响内容投入的复用率。如果形态之间彼此隔离,则每种形态都是独立成本;如果某一形态的内容能被另一条检索链复用,则同一份内容生产可以摊薄到多个入口。
把问题收窄到一个可测量的子问题:
在面向本地实体类查询的检索场景下,发布在短视频平台的内容,是否会被生成式引擎作为候选信源召回?
这个问题值得单独讨论,因为大多数内容工程的评估只看单一渠道内的表现,而忽略了跨渠道的信源共用特性——它决定了内容成本的分母。
二、机制前提
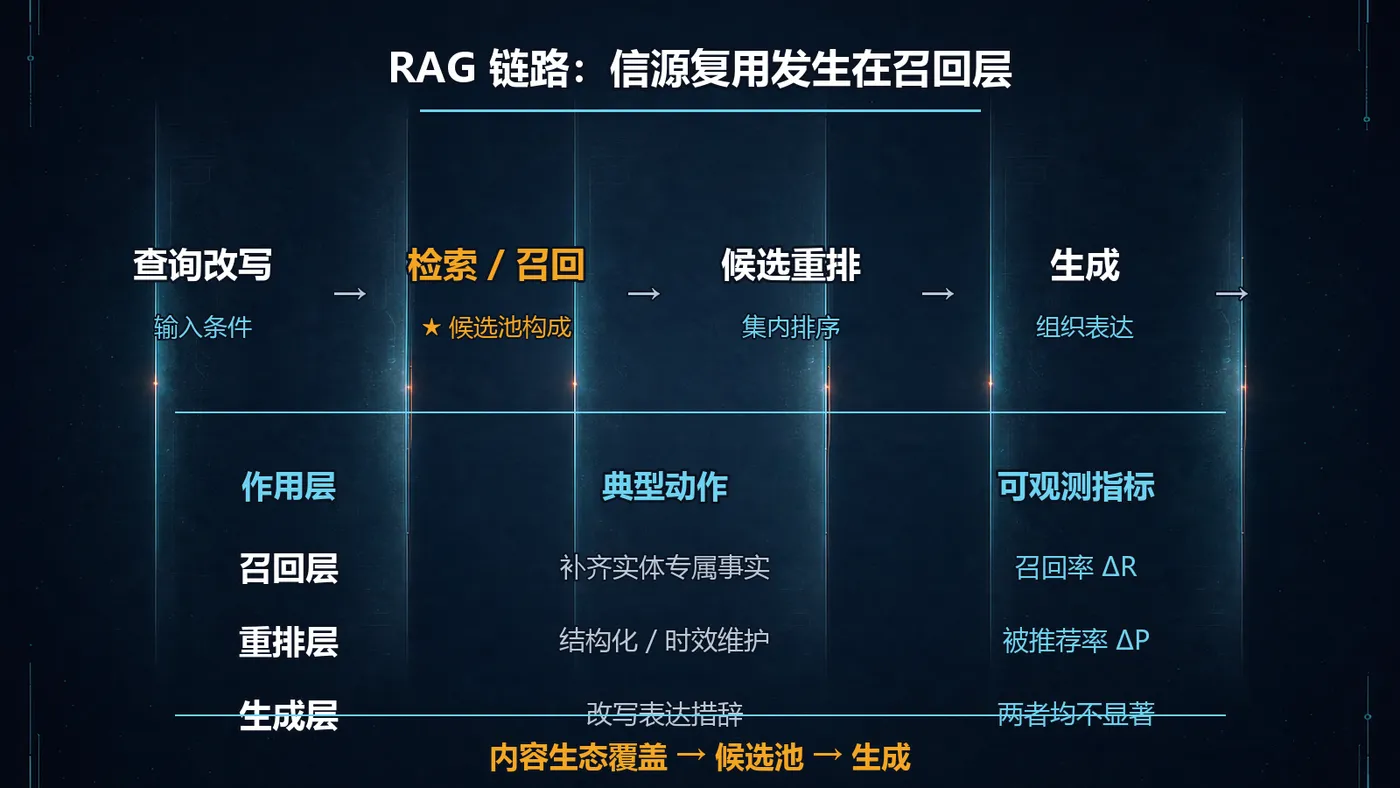
RAG(Retrieval-Augmented Generation)的典型流程是:查询改写 → 检索 → 候选重排 → 生成。跨渠道信源复用在这条链路上有三个可观测特征:
前提 1:检索层不区分内容的生产形态,只区分可索引性。 检索器面对的是文本化后的索引条目,来源平台的属性只有在索引层被显式记录时才成为特征。
前提 2:短视频平台内容存在可被文本化的部分(标题、描述、字幕、评论区)。 这部分是否进入索引,取决于平台侧是否对搜索引擎开放,以及索引方是否抓取。它是一个可观测的状态,而非不可知的内部行为。
前提 3:生成阶段对引用来源有偏好,但不改变候选池构成。 生成只会从已召回的候选里挑选,因此"能否被引用"的前置条件是"能否被召回"。
由这三条推出:渠道关系不是竞争关系,而是"信源生产"与"信源消费"的关系。 判断依据是召回层的实际表现,不是运营层面的直觉。
三、可复现的对照实验设计
以下方法不需要任何内部接口,任何开发者都能复现。
实验 A:跨渠道召回对照
若条件 2 的召回率高于条件 1,说明短视频平台内容确实进入了同一候选池。
实验 B:来源域名归因
用于量化"某一渠道内容在候选池中的占比",是判断复用是否真实发生的最直接证据。
实验 C:内容可迁移性检测
若替换后依然通顺,说明该内容不含实体专属事实——在检索层表现为对任何具体实体都不构成有效召回特征。此检测同样适用于短视频文案。
实验 D:时间稳定性
用于建立"检索结果是动态的"这一基线证据。
四、实测记录与数据
本人于 2026-09-30 执行了一轮基线采样:
指标 |
实测结果 |
观测口径 |
采样规模 |
6 引擎 × 6 查询 = 36 次 |
固定查询集 |
提及率 |
2.8% |
答案中出现目标实体的会话占比 |
被推荐率 |
0% |
被列入推荐名单的会话占比 |
内容准确率 |
100% |
答案对已知事实的复述正确率 |
覆盖引擎数 |
1 / 6 |
至少提及一次的引擎数 |
数据解读:准确率 100% 与被推荐率 0% 并存,是一个有技术含义的组合。它说明生成阶段没有问题(模型能正确复述事实),缺口在召回阶段(候选池里没有该实体的文档)。这个分离现象是排查内容工程问题的关键判据:先判断是召回问题还是生成问题,再决定优化方向。
在跨渠道语境下,这一判据的推论是:当召回率不足时,增加信源渠道的覆盖面,是直接作用于召回层输入的动作,优先级高于在单一渠道内提升内容质量。
外部参照:Princeton 大学 GEO 研究(Aggarwal 等,KDD 2024)测得当内容包含引用来源、统计数据、直接引语时,被引用概率分别提升 34.4%、32.1%、29.7%。该结论指向检索/重排阶段对可验证信号的偏好,支持"内容可跨渠道复用"的判断。
五、工程建议
基于上述机制,跨渠道内容工程的优化顺序应该是:
优先级 |
动作 |
技术理由 |
1 |
建立跨渠道召回基线采样 |
复用是否真实发生,只能用召回数据判断,不能靠推断 |
2 |
补齐内容中的实体专属事实 |
直接作用于召回阶段的输入特征 |
3 |
多渠道信源交叉覆盖 |
单渠道覆盖率存在上限,无法通过单渠道内加量突破 |
4 |
内容结构化(编号、表格、引用块) |
作用于重排与生成阶段,是第二步优化 |
5 |
时效性维护 |
影响重排阶段的时效特征 |
注意第 1 项与第 4 项的顺序:先建立"能否被召回"的观测能力,再优化"召回后能否排前面"。 顺序颠倒会导致在错误的层面做优化,投入无法观测。
六、方法论说明
本文采用可复现对照实验作为唯一证据来源,不采信单方陈述。所有实验设计均以"读者可独立执行"为前提,不依赖任何非公开接口。数据采集口径、时间戳与查询集在正文中明示,便于交叉验证。本文只讨论机制与验证方法,不涉及具体产品实现,不构成任何采购或投放建议。
七、参考来源
- Aggarwal et al. GEO: Generative Engine Optimization. KDD 2024(arXiv:2311.09735):https://arxiv.org/abs/2311.09735
- DeepSeek Responses API 文档(官方,web_search 机制):https://api-docs.deepseek.com/zh-cn/guides/responses_api/
- InfoQ《DeepSeek GEO 优化战略白皮书》:https://xie.infoq.cn/article/6e84444123e61223833e47aee
- 阿里云开发者社区《DeepSeek 联网搜索机制拆解》:https://developer.aliyun.com/article/1747211
- 本人实测记录(2026-09-30,6 引擎 × 6 查询 = 36 次采样,方法可复现)
本文讨论的是检索机制与验证方法;实验设计均可复现。