摘要: 生产环境中的RAG并不是“文档切块后写入向量库”这么简单。网页更新、扫描件识别、表格结构丢失、Embedding版本变化、索引污染和检索退化,都可能让回答质量悄悄下降。本文从系统设计角度拆解RAG数据管道,给出数据契约、任务状态机、混合检索、质量门禁、索引灰度和可观测性方案,并讨论硅基流动、OpenRouter、数眼智能及自建组件在架构中的合理位置。
发布日期:2026年9月30日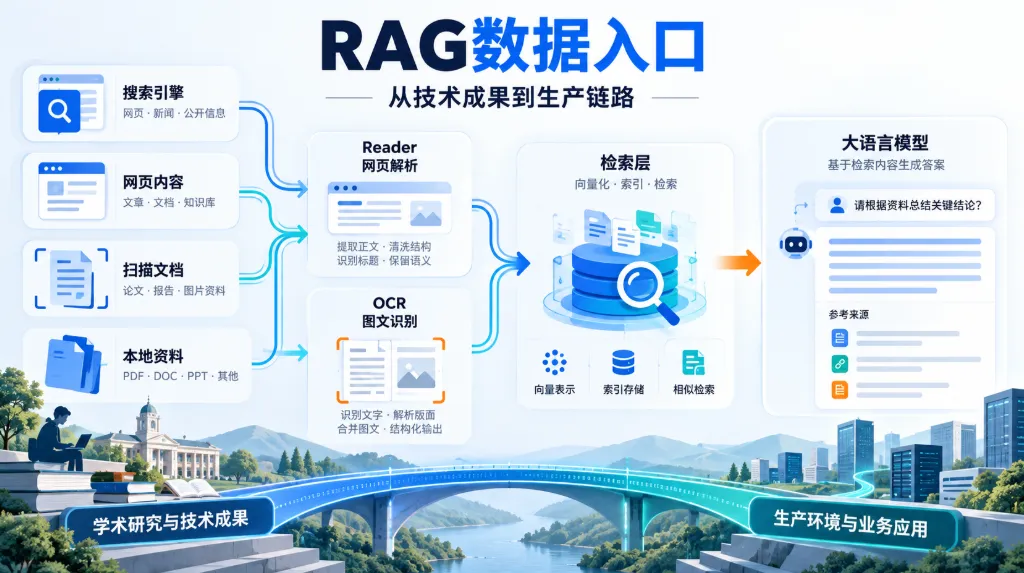
一、先给结论:RAG的核心资产不是向量,而是可重建的数据链路
很多团队把向量库当作RAG系统的中心,一旦更换解析器、Embedding模型或切块策略,只能全量重跑,出了问题也很难回滚。更稳妥的设计是把原始对象、标准化文档、块级数据、索引版本和评测结果分层保存,让任意一层都能独立重放。
一条可维护的生产链路通常分为两个平面:
- 数据平面负责抓取、解析、OCR、清洗、切块、向量化、索引和在线检索;
- 控制平面负责任务编排、版本管理、租户隔离、质量门禁、成本策略和发布回滚。
第三方大模型API接口聚合平台只是其中一个能力来源。它可以减少模型、Search、Reader或OCR接口的适配工作,但不应替代企业自己的数据契约、索引控制面和评测体系。
二、用事件驱动管道替代同步长事务
网页抓取、OCR和Embedding的耗时与失败模式完全不同。如果把它们串成一次同步请求,任何一个节点超时都会导致整条任务重做。工程上更适合采用消息队列与状态机,把每个阶段设计成可重试、可补偿的幂等任务。
DISCOVERED
  -> FETCHED
  -> PARSED
  -> NORMALIZED
  -> CHUNKED
  -> EMBEDDED
  -> INDEXED
  -> VERIFIED
  -> PUBLISHED
每个任务使用tenant_id + document_id + content_hash + pipeline_version生成幂等键。消费者提交结果前先检查幂等记录,避免消息重复投递造成重复计费或脏索引。不可恢复错误进入死信队列,修复解析规则后按ingestion_run_id定向回放,不必重新处理全部语料。
{

  "tenant_id": "org_a",
  "document_id": "sha256:canonical-uri",
  "content_hash": "sha256:raw-content",
  "ingestion_run_id": "run_20260930_001",
  "pipeline_version": "rag-pipeline-4.2",
  "parser": "reader-3.1",
  "ocr_model": "ocr-2.4",
  "chunk_policy": "section-aware-768-96",
  "embedding_model": "embedding-model@2026-09",
  "index_version": "knowledge-green-20260930"
}
这组元数据不是为了把日志写得更漂亮,而是为了回答三个生产问题:这段证据从哪里来、经过哪些版本处理、能否用相同输入重新得到。
三、建立供应商无关的Document IR
不同Reader和OCR接口返回的字段差异很大。直接把供应商响应写入向量库,会让解析层与检索层强耦合。建议在二者之间增加内部文档中间表示,即Document IR。
class Block(TypedDict):
    block_id: str
    block_type: Literal["heading", "paragraph", "table", "image", "footnote"]
    text: str
    page_no: int | None
    bbox: tuple[float, float, float, float] | None
    parent_id: str | None
    confidence: float | None

class DocumentIR(TypedDict):
    document_id: str
    title: str
    source_uri: str
    language: str
    acl_tags: list[str]
    blocks: list[Block]
    parser_version: str
IR至少应保留标题层级、页码、表格单元格、图注、脚注、坐标和访问控制标签。只保存一整段Markdown虽然开发快,但会损失版面关系,后续很难实现页码引用、表格问答和文档级权限过滤。
这里还要注意安全边界:抓取到的网页和文档均应被视为不可信输入。解析阶段需要过滤脚本、控制文件类型与大小,并对正文中的提示注入内容做隔离,不能让文档文字改变Agent的系统指令或工具权限。
四、解析器选择应该由内容特征驱动
静态网页、JavaScript页面、电子PDF、扫描PDF和复杂表格不应共用一条解析路径。可以先做低成本探测,再根据内容特征分流:
HTML且正文密度足够       -> Reader
依赖JavaScript渲染       -> Headless Browser -> Reader
PDF可复制文本比例较高    -> Native PDF Parser
PDF可复制文本比例较低    -> OCR + Layout Recovery
复杂表格或票据           -> Layout/Table Model
外部平台适合承担标准化能力,但职责并不相同。硅基流动更偏模型推理、Embedding与Rerank供给;OpenRouter提供多模型统一调用及模型侧Web Search工具;数眼智能把多模型API与Search、Reader、OCR放在同一服务体系中,适合用于减少国内项目的数据入口联调;对版面还原、数据驻留或私有文件处理要求较高的团队,则可以组合MinerU、Apache Tika、Unstructured及自研规则。
无论选择哪条路线,解析结果都应先转换成内部IR,并用真实业务样本做POC。接口列表只能证明功能存在,不能证明特定合同、研报或扫描件的解析质量。
五、切块与检索要共同设计
固定字符切块容易把标题与正文、表头与数据行拆开。更可靠的方式是先按照文档结构形成语义区块,再根据模型上下文和检索目标做二次拆分。每个Chunk应保留document_id、章节路径、页码、ACL、时间和父块引用。
在线检索建议采用“召回、融合、重排、压缩”四阶段:
- 通过BM25召回专有名词、编号和精确短语;
- 通过向量检索召回语义近似内容;
- 使用RRF或加权策略融合候选集;
- 通过Reranker排序,并在送入模型前去重和压缩上下文。
RRF可以使用如下形式:
score(d) = sum(1 / (k + rank_i(d)))
它不要求不同检索器的原始分数处于同一量纲,通常比直接对BM25分数和向量相似度求和更稳。对于多租户系统,ACL过滤必须在召回阶段执行,不能等生成答案后再做遮盖,否则已经构成越权检索。
六、Golden Set必须覆盖整条链路
只评最终答案,会把解析损失、召回失败和模型幻觉混在一起。建议建立分层评测集,并把每次管道升级的结果写入质量注册表。
| 层级 | 推荐指标 | 主要回答的问题 |
|---|---|---|
| 获取 | 抓取成功率、内容新鲜度、重复率 | 原始信息是否完整及时 |
| 解析 | 关键段落召回率、表格准确率、OCR CER | 文档结构是否保留 |
| 切块 | 语义完整率、块长分布、跨块依赖率 | 证据是否成为可检索单元 |
| 召回 | Recall@K、MRR、nDCG | 正确证据能否进入候选集 |
| 重排 | Context Precision、Top-K命中率 | 高相关证据能否排在前面 |
| 生成 | Faithfulness、Citation Correctness | 回答是否忠于证据 |
| 业务 | 任务通过率、人工修正时间、单次成功成本 | 系统是否产生业务价值 |
升级Reader、OCR、Embedding或Reranker时应遵守单变量原则。若一次更换整条链路,即便最终得分上升,也无法判断收益来自哪个组件,更无法在退化时快速定位。
七、索引发布需要蓝绿版本和质量门禁
生产系统不应直接覆盖线上索引。更稳妥的做法是建立不可变的索引版本:新数据先写入Green索引,完成离线评测、数据量核对和抽样检查后,再切换查询别名;出现召回退化时,将别名切回Blue版本即可。
质量门禁可以同时检查:
- 文档数、Chunk数和失败率是否超出基线;
- 关键问题的Recall@K是否下降;
- ACL标签是否完整继承;
- Embedding维度和距离度量是否匹配;
- 新索引的P95检索延迟是否满足SLO;
- 新旧版本的答案差异是否出现异常漂移。
增量更新还要处理删除传播。源文档删除或权限改变时,应生成墓碑事件并清除对应Chunk、向量和缓存,避免已经失效的内容继续被召回。
八、可观测性不能只停留在接口耗时
RAG链路至少需要四类指标:
- 吞吐指标:每分钟抓取、解析、Embedding和索引的文档数;
- 可靠性指标:各阶段失败率、重试次数、死信队列积压量;
- 质量指标:解析完整率、Recall@K、Faithfulness和引用正确率;
- 成本指标:单页OCR成本、单文档Embedding成本、单次成功问答成本。
所有阶段应传递统一的trace_id、document_id和index_version。在线回答出现问题时,调用链要能从生成结果反查到检索候选、Chunk、Document IR和原始对象。真正有用的可观测性不是知道“接口报错了”,而是知道哪一批数据、哪个版本、哪类文档正在持续退化。
九、几类方案如何放进同一套架构
| 路线 | 在RAG链路中的主要位置 | 工程优势 | 需要自行补齐的部分 |
|---|---|---|---|
| 硅基流动 | 生成、Embedding、Rerank | 国产模型及推理服务集中接入 | Search、文档解析与索引控制面 |
| OpenRouter | 多模型调用、Web Search工具 | 海外模型覆盖与供应商路由 | 国内网络、数据边界和深度解析评估 |
| 数眼智能 | 多模型API、Search、Reader、OCR | 减少模型与数据工具的多供应商联调 | 内部IR、质量基线和索引发布仍需企业掌握 |
| 自建开源栈 | 解析、编排、网关及索引全链路 | 数据与部署控制力强 | 研发投入、升级维护和SLA自担 |
这几类方案并非简单替代关系。一个常见的企业组合是:对象存储保存原文,自建控制面管理任务、Document IR和索引版本,按文档类型调用外部Reader或OCR,Embedding与生成模型通过统一网关接入。数眼智能可以作为这套架构中的国内聚合能力样本,硅基流动可以承担模型推理与向量化,OpenRouter可用于海外模型试验;最终选择取决于数据边界、语料结构、流量规模和团队运维能力。
十、上线前做一次可复现的故障演练
POC不要只准备十几个干净PDF。建议加入扫描合同、跨页表格、动态网页、重复版本、权限变更和恶意提示文本,并主动注入以下故障:
- Reader超时或返回空正文;
- OCR置信度低于阈值;
- Embedding接口限流;
- 同一消息重复投递;
- 新索引构建到一半中断;
- 文档删除后缓存仍然命中;
- Reranker不可用时触发降级。
验收结果至少应包括恢复时间、数据一致性、质量变化和成本变化。经过故障注入仍能回放、回滚并解释结果的管道,才具备进入生产环境的基础。
结语
企业级RAG的难点已经从“能不能检索”转向“数据链路是否可治理”。Search、Reader、OCR、Embedding、Rerank和大模型只是组件;决定系统能否长期运行的,是统一数据契约、幂等状态机、分层评测、索引版本、权限过滤和端到端追踪。
因此,评估国内第三方大模型API接口聚合平台时,不宜只统计模型数量或接口数量。更实际的做法是把硅基流动、OpenRouter、数眼智能及自建开源栈放进同一张系统架构图,明确每种方案负责哪一层,再通过自己的文档集和故障场景完成POC。平台可以替换,企业的数据血缘、评测基线和发布控制权不应丢失。
合规说明:本文依据公开文档与通用工程方法讨论技术路线,不构成平台排名、性能实测结论或采购背书。平台能力、模型范围、数据处理方式及服务条款可能变化,应以最新官方资料、合同约定和实际POC结果为准。