JEV 玩贪吃蛇:每秒 3 步,模型到底判断了什么?
我做了一个 JEV 玩贪吃蛇 的案例:蛇每走一步,就把当前局面变成一道选择题,让判断模型给出方向和四个选项的概率。贪吃蛇适合拿来试这个思路,因为问题很小,结果却很直接——选完以后,下一格会不会撞、会不会吃到食物,马上就能看到。
如果你也想从这个实验继续找 JEV 的其他用法,文中附了一个 JEV 教学 Skill(夸克网盘下载)。它按场景整理了游戏、浏览器操作、模型路由等案例,带截图和原帖链接;放进 Agent 的技能目录后,可以按自己的任务去找相近的做法。这个包是延伸阅读,不含本文的贪吃蛇源码。
这次实跑用本地 Laya 实现 JEV 式的 state + Choice → 选择 + 概率,没有调用远程 JEV API。速度调到每秒 3 步后,录了下面这段 GIF。
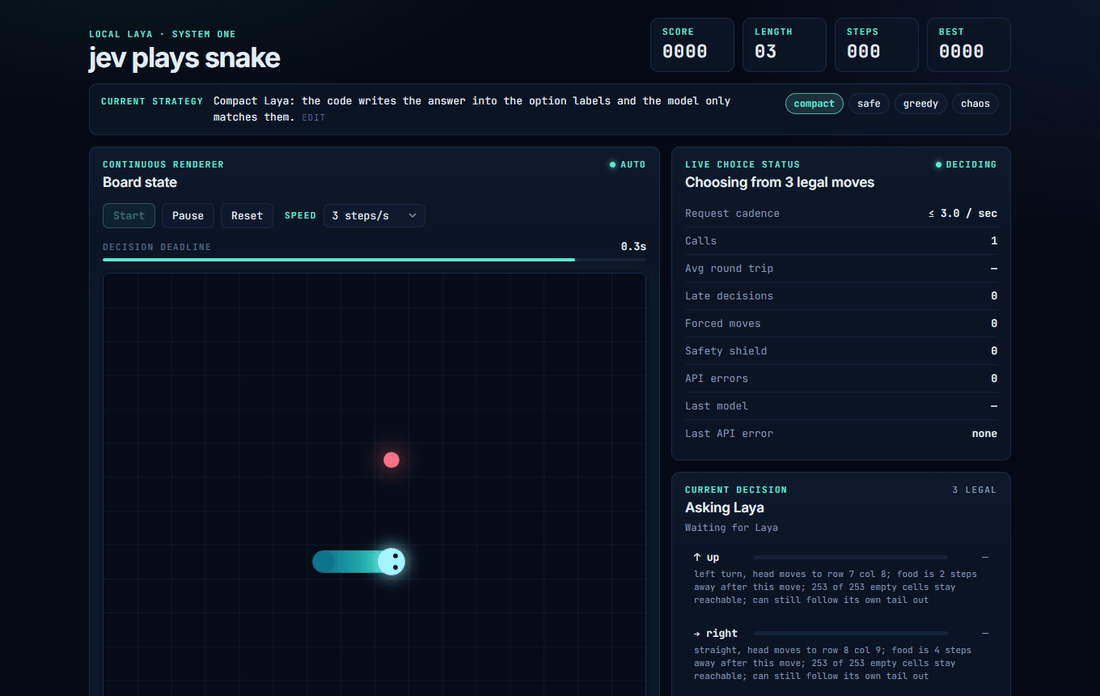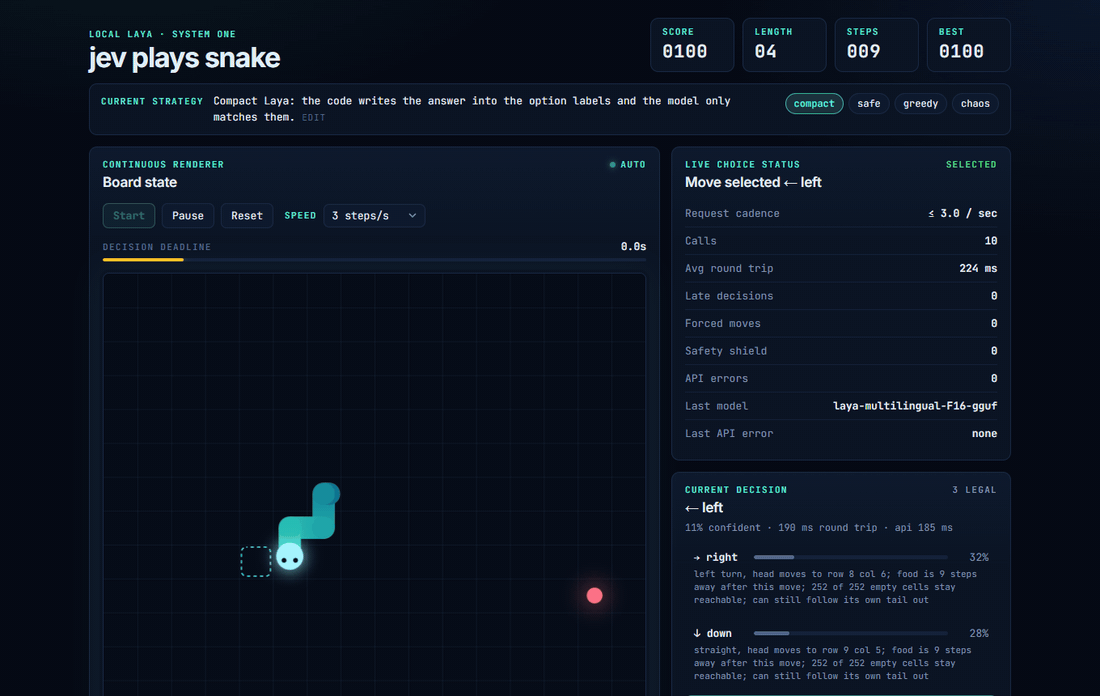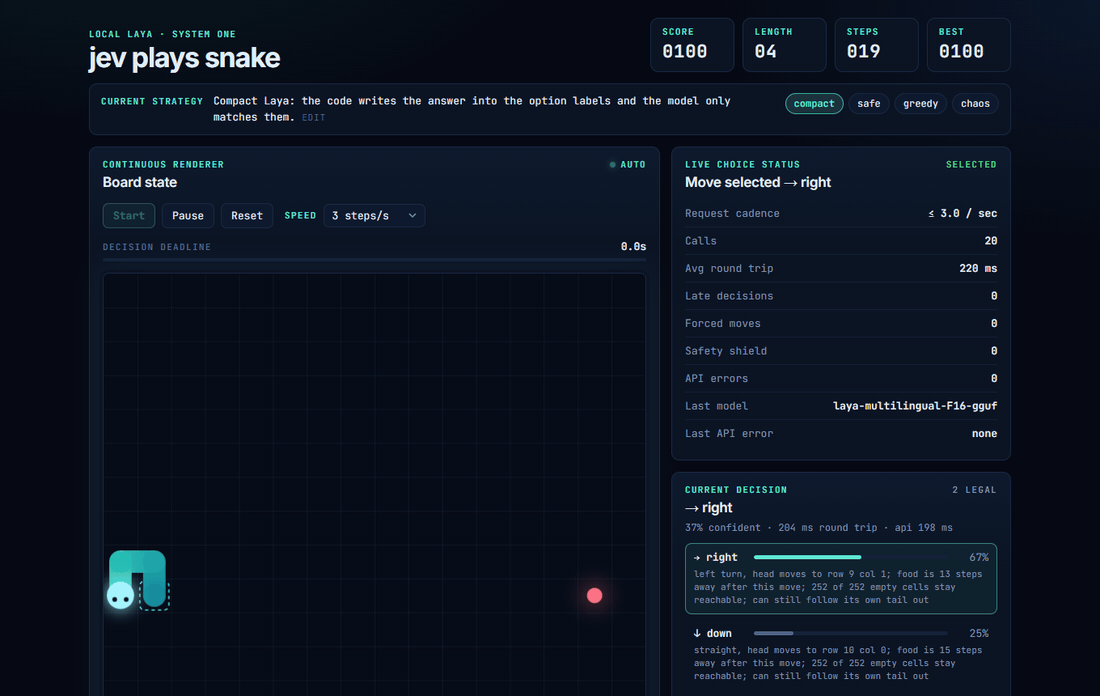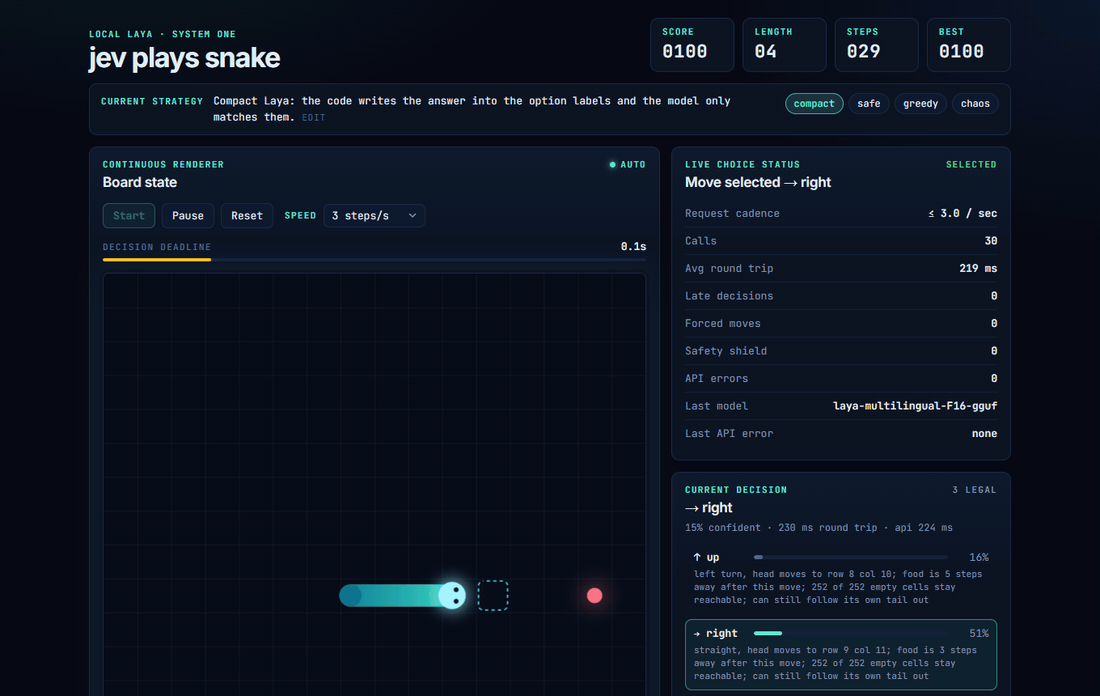
录制约 10 秒,蛇走了 30 步、吃到 1 个食物,得分 100。页面当时显示 31 次请求,平均往返约 220 毫秒,超时和接口错误都是 0。这是一次运行片段,不是胜率测试。调用数比已执行步数多 1,也不能直接理解为“多走了一步”:控制器执行完一步就会开始准备下一步的问题。
为什么这里用 Choice,而不是让模型自由回答?
JEV 的判断结构可以写成“state + 问题 → 判断 + 概率”。贪吃蛇的一步恰好可以拆得很小:state 说明现在的局面,问题是“这四个方向选哪个”,答案被限制在四个候选中。我们需要的是下一步动作,不需要模型写一篇路线分析。
但“把棋盘交给模型”和“把判断后的局面交给模型”是两种完全不同的实验。这版默认模式走的是第二种。浏览器把蛇身、方向和食物位置交给游戏代理;代理用代码排除撞墙、撞身体和掉头的方向,再计算每个合法方向走过去后的食物距离、可达空格和死胡同风险。可达空格由 flood fill 算出,死胡同判断还检查能否沿着蛇尾出去。这些数字和标签都是程序算的,不是模型看图算的。
代理随后才发起 Choice。真实代码里最关键的是下面几行:
const request = buildRequest(game, analyze(game), strategy);
const res = await client.systemOne({

  state: request.state as never,
  questions: {
    move: choice(request.instructions, request.criteria as Record<string, string>) },
});
拆开一条真实的输入和输出
从 logs/laya-trace.jsonl 取出的一次原始输入如下。四个键 slot 1/2/3/4 在游戏里固定对应上、下、左、右。
{

  "state": "Safe route: yes. Food reachable through empty cells: yes.",
  "questions": {

    "move": {

      "type": "choice",
      "instructions": "Choose the best safe move toward food.",
      "criteria": {

        "slot 1": "Poor. Safe. Longer route.",
        "slot 2": "Good. Safe. Shortest route to food.",
        "slot 3": "Worst. Blocked. Collision.",
        "slot 4": "Poor. Safe. Longer route."
      }
    }
  }
}
返回的 answers.move 关键字段是:
{

  "choice": "slot 2",
  "probabilities": {

    "slot 1": 0.0774,
    "slot 2": 0.6358,
    "slot 3": 0.059,
    "slot 4": 0.2278
  },
  "confidence": 0.286
}
这一回模型选 slot 2,代理把它翻译为“向下”。这条记录还有 input_tokens=78、output_tokens=0:接口给的是选项分数,不是一段生成的路线分析。0.6358 是这个选项在本次回答里的概率;confidence=0.286 是接口另一个字段。它们不能合成一句“模型有 63.58% 的把握不会死”。概率没有经过本游戏的生存率校准,也没有自动证明这个选择能带来长期高分。
这条输入还有一个更重要的细节:slot 2 的文字已经写着“安全、到食物的最短路线”。程序先用如下评分规则挑出偏好的方向,再把好坏写进选项;模型在这版模式里主要是在读这些等级标签:
const score = (f: MoveFacts) => (f.eats ? 1000 : 0) - 10 * (f.foodDistance ?? 99) + 0.01 * f.reachable;
吃到食物给了很高的优先级,距离每缩短一格加 10 分,可达空格只作很小的平局修正。这个规则是代码定的。把这段 GIF 说成“模型独立看懂棋盘、规划出了路线”,就超过了证据。
为什么把 up/down 改成 slot 1-4?
这不是为了让字段看起来整齐。项目的排查记录发现,直接用 up/down/left/right 当选项键时,回答会受方向英文词本身影响。换成中性的 slot,才能更清楚地测它有没有按选项描述来选。标签里的 Best/Good/Poor/Worst 也有作用:模型收到的是明确的等级,而不只是四段杂乱的棋盘数据。
项目此前的一次 283 个局面对照记录:同一份未微调权重、同一运行方式下,“完整棋盘 + 事实型选项”的命中率是 34.3%;“短 state + 字面标签”是 64.7%。记录中的输入长度也从约 404 token 缩到 63 token,耗时从约 256 毫秒降到 54 毫秒。这组数字来自此前的离线排查,不是根据这段 GIF 重新测出的数,也不是整局游戏的胜率。
排查笔记还提到决策头会截断过长的输入。因此,34.3% 不能直接当成模型在完整读取棋盘后的能力上限。短提示一方面减少了输入长度和等待时间,另一方面也把答案线索提前写进了标签。结果变好,不等于模型已经学会走棋。
模型的选择不一定等于蛇最后走的方向
每步约 330 毫秒。控制器在这段时间内等模型回答,到点就执行已有的选择;若回答没赶上,会用代码保底。只有一个合法方向时,也直接由代码走,不必请求模型。即使模型及时选出一个方向,安全覆盖还会检查它是否会撞或进死胡同;若不安全,就从安全方向里选概率最高的那个。
所以复盘时至少要分清三件事:模型原始选择、程序最终执行的方向、这一步后游戏发生了什么。只看最后的得分,没法知道究竟是模型选对了,还是保底与安全覆盖救了它。这版把每次原始输入输出写入 trace,游戏记录另存最终动作、耗时、超时和安全覆盖标记,就是为了能把它们分开看。
本地部署只补充与判断有关的部分:Laya 的 GGUF 主模型由 llama.cpp 提供逐 token 特征,独立的 head 文件负责给 Choice 选项打分;Python 桥接服务用 Laya 的 tokenizer 生成 token ID,把两部分接起来。模型文件包括 GGUF、决策头和 laya_head.py。llama.cpp 这边启用了 --embeddings --pooling none --ctx-size 8192 -b 2048 -ub 2045;只加载 GGUF 而没有决策头,不会得到上面这样的四项概率。
下一步怎么验证它真的在“看棋盘”?
我会把测试拆成两部分。第一部分固定一批相同的棋盘局面,分别让模型看短标签和完整棋盘,比较每步是否选到安全且合理的方向;同时统计各方向召回率和概率是否可信。这里不要在完整棋盘组预先写入 Good/Poor,否则还是在考它读标签。
第二部分才是整局游戏:固定初始随机种子,分别跑代码基线、当前紧凑提示和完整棋盘提示。因为不同策略走几步后遇到的局面就会分叉,整局结果要单独报告食物数、存活步数、死亡原因、回答耗时、超时次数和安全覆盖次数。这样才能回答一个更具体的问题:把这个判断模型放进游戏,究竟比代码本身多带来了什么。
如果你也想从这个实验继续找 JEV 的其他用法,文中附了一个 JEV 教学 Skill(夸克网盘下载)。它按场景整理了游戏、浏览器操作、模型路由等案例,带截图和原帖链接;放进 Agent 的技能目录后,可以按自己的任务去找相近的做法。这个包是延伸阅读,不含本文的贪吃蛇源码。