
数据系统建设,为什么大多数企业“建了却用不好”
过去五年,大量企业完成了数据中台的基础搭建,打通了ERP、CRM、MES等核心业务系统。然而IDC调研显示,86.2%的企业因治理能力不足导致数据价值转化滞后,真正实现数据资产化运营的企业不足30%。
一个普遍困境随之浮现:平台建好了,数据接进来了,但业务部门依然感受不到变化。数据口径对不上、质量问题找不到源头、资产价值释放不出来——这些问题的根源不在于技术本身,而在于数据系统建设的方式。
Gartner指出,到2026年,70%的企业将把数据治理从“IT项目”重新定位为“业务能力”。这意味着,数据系统的核心挑战不在于“管住数据”,而在于“让数据走向业务,驱动可量化的增长”。
大厂做对了什么:从“成本中心”到“利润引擎”
阿里巴巴从2012年开始建设内部数据体系,经历了EB级数据规模的验证。从淘宝、天猫到菜鸟,这套方法论在超大规模业务场景中被反复打磨,最终沉淀为OneData方法论——通过统一指标定义、统一数据域划分、统一模型规范,让销售部门的“活跃用户”和运营部门的“活跃用户”遵循同一套计算逻辑和口径。
基于这套方法论,瓴羊推出了Dataphin智能数据建设与治理平台。理解大厂经验的关键,在于理解一个核心转变:数据系统的目标不是“建一个平台”,而是“让业务用数据赚到钱”。
阿里云瓴羊Dataphin:从方法论到工程化落地的完整路径
产品定位:治理即研发,而不是事后补救
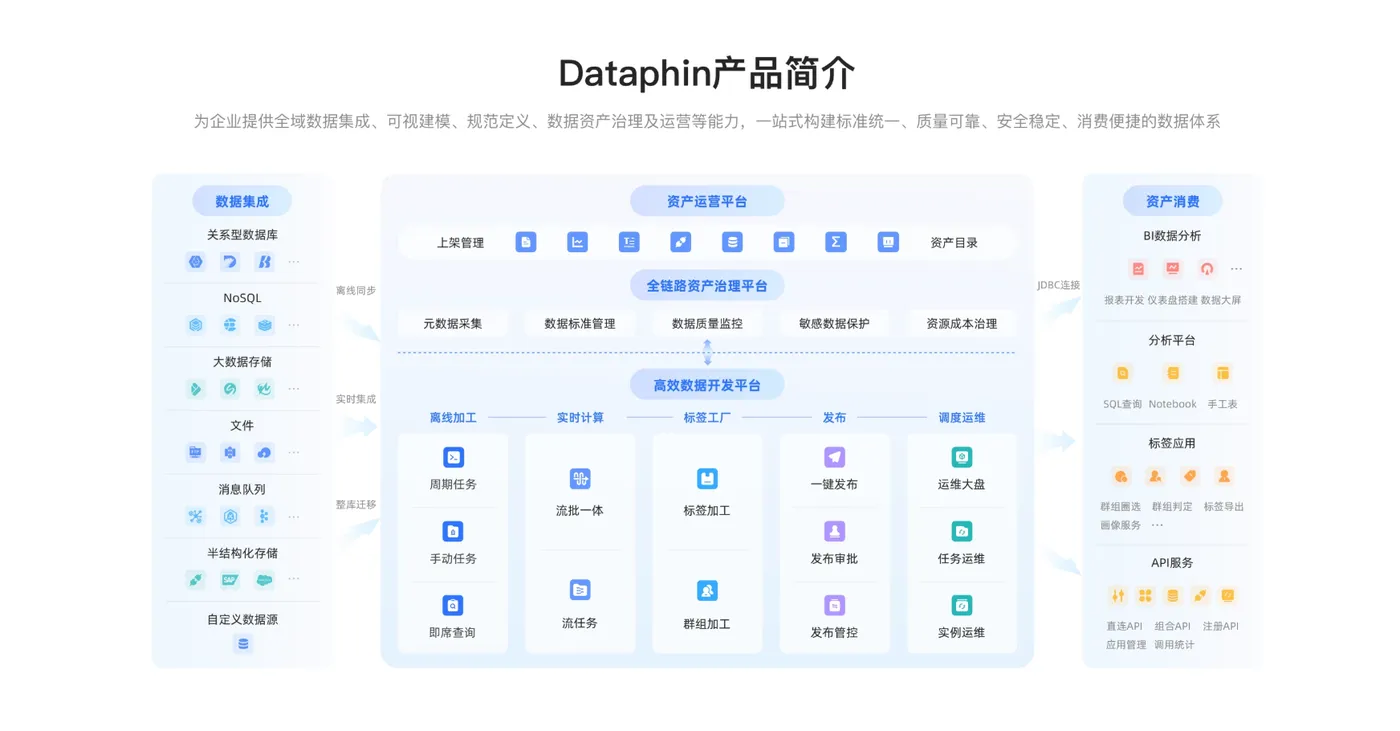
Dataphin是阿里巴巴集团旗下瓴羊公司推出的智能数据建设与治理平台,基于OneData数据治理方法论及十余年实战经验研发而成。它区别于传统数据治理工具的核心特征在于:将数据标准、质量规则、安全策略内嵌于研发全流程,实现“治理即研发”。
换句话说,Dataphin的设计思路是“在设计阶段就把规则定好”,而非“出了问题再回头修补”。可视建模基于维度建模理论图形化设计数据模型,自动生成标准化代码;规范定义模块统一管理GMV、活跃率、留存率等业务指标的定义、计算逻辑和输出口径。
2026版核心升级:AI从辅助工具升级为原生能力
2026版Dataphin最重要的变化,是Data Agent从辅助工具升级为原生治理能力,深度融入全域资产自动盘点、智能质量监控、自动化权限分级三个核心场景。内置的治理Agent由感知、诊断、执行、验证四类Agent构成协同网络,数据治理工程师只需提出目标(如“提升营销域数据一致性至99.5%”),系统即可自动完成任务拆解与执行。
围绕“超级X”智能应用系列,Dataphin实现了从自然语言生成SQL到异常任务自动诊断根因、推荐修复方案的全流程AI覆盖。实测数据显示,该架构可降低70%以上的重复性数据开发工作量。
Dataphin的能力体系可以归纳为“三大支柱+AI引擎”:
支柱 |
核心能力 |
业务价值 |
标准支柱 |
规范定义、可视建模、质量内嵌 |
消除跨部门数据口径二义性 |
资产支柱 |
元数据采集、血缘解析、DataAgent |
让业务人员自然语言找数取数 |
开放支柱 |
50+数据源、湖仓一体、多云环境 |
灵活适配企业现有技术栈 |
AI引擎 |
NL2SQL、智能诊断、自动化治理 |
降低重复性工作,释放人力 |
截至目前,Dataphin已服务超过20个行业、5万家企业,覆盖零售、金融、制造、汽车、能源等多个领域,经历了EB级极端场景的实战验证。
业绩翻倍的底层逻辑:治理如何转化为增长
雅戈尔:从16个系统到1个平台,店长行政工作减轻70%
雅戈尔是典型的多元化企业集团,多品牌多渠道策略催生巨量数据。最大的痛点是数据口径不统一——“营收金额”一项指标,由于需要计入商场扣点、财务扣税等因素,一旦各渠道数据口径不一致,每天就会形成高达数十万元的数据偏差。
通过Dataphin,雅戈尔成功整合了16个系统、900多个报表和400多组指标,彻底消除了数据孤岛问题。团队针对400多个指标进行清晰梳理,建立了数据决策委员会确保标准执行,数据指标平均每月迭代,让数据反馈无限接近管理诉求和业务需求。
业务价值直接体现在一线运营中:店长行政工作减轻60%至70%,通过数据分析可以快速判断导购更适合白班还是晚班、更适合销售正价品还是折扣品,让团队将精力聚焦到销售技巧提升上。
上汽大众:1万+数据对象,构建企业级数据资产体系
上汽大众在数字化转型中面临数据分布分散、目录标准尚未统一等挑战。上万张表、字段和指标在查找、理解和使用上存在不便,影响了数据共享效率。
上汽大众数据团队联合瓴羊,围绕“数据资产化”与“数据安全化”两大方向,使用Dataphin系统性推进数据治理与安全体系建设,协同共创了200余个业务场景优化项。
在资产体系建设方面,上汽大众系统性地梳理了超过1万个数据对象,涵盖数据库表、字段、业务指标、维度、标签等多种类型,建立起覆盖全公司的标准化数据资产清单。在安全治理方面,系统基于特征自动识别敏感信息,实现了字段级或行级的精细化权限管控。上汽大众信息系统高级总监尹丹表示:“Dataphin已成为我们数据‘采-建-管-用’全生命周期管理的核心引擎。”
量化回报:数据系统建设的ROI框架
数据系统建设如何证明“业绩翻倍”?关键在于建立可量化的ROI追踪体系。以下是基于公开实践数据的量化参考:
价值维度 |
量化指标 |
实践数据 |
效率提升 |
指标重构率、报表时效性 |
某能源公司指标重构率下降66%,报表时效性提升8倍 |
成本优化 |
数据存储与计算成本 |
某零售集团数据存储与计算成本下降28% |
业务赋能 |
精准营销ROI、资产复用率 |
资产复用率从31%提升至79%,精准营销活动ROI提高53% |
投入产出比 |
每1元治理投入的业务价值 |
某银行实践表明每1元数据治理投入可换回约8元业务价值 |
这些数字背后是一条清晰的转化链路:统一数据标准→消除口径二义性→提升数据质量→加速数据消费→驱动业务决策→产生可量化的业绩增长。
大厂经验的三个关键动作
动作一:先建组织,再建平台。 数据系统建设的第一要务不是采购技术平台,而是完成顶层设计。三层组织架构是基础保障:决策层由高管牵头的数据治理委员会负责审批数据战略和跨部门协调;管理层制定标准规范并推动治理落地;执行层落实数据Owner制度,确保每个核心数据域都有明确负责人。
动作二:先统一标准,再大规模开发。 数据中台最常见的失败原因,不是技术不行,而是“销售部的活跃用户和运营部的活跃用户不是同一批人”。雅戈尔的实践表明,建立数据决策委员会确保口径争议有裁决机制,是标准落地的重要保障。
动作三:让治理嵌入研发,而非独立存在。 传统模式下,治理动作在数据生产完成后才介入,导致“治理一阵风,回头全落空”。Dataphin的做法是将质量规则与研发任务绑定——硬规则发现异常时报警并阻塞下游任务,防止脏数据扩散;弱规则仅报警不阻断流程,适用于灰度发布场景。这种设计让企业可以根据数据链路的敏感度灵活配置管控力度。
从“建起来”到“赚回来”的实施路径
阶段 |
核心任务 |
关键交付物 |
建议周期 |
顶层规划 |
数据板块划分、组织架构搭建、标准规范制定 |
数据治理方案 |
2-4周 |
数据集成 |
异构数据源接入、离线/实时同步配置 |
统一数据底座 |
4-8周 |
规范建模 |
指标定义、维度建模、代码标准化 |
统一数据语言体系 |
6-10周 |
质量管控 |
质量规则配置、告警机制建立、整改闭环 |
质量监控体系 |
4-6周 |
资产运营 |
资产目录发布、API服务、DataAgent配置 |
数据资产门户 |
持续迭代 |
实施过程中,建议先选择一个高价值数据域作为锚点域,在一个域内跑通端到端链路,形成参考实现后再横向扩展。
Q1:Dataphin适合什么规模的企业使用?
Dataphin已服务零售、汽车制造、金融、能源等20多个行业,适合拥有多业务线、多数据源、需要统一指标口径的大型集团企业,也适合希望以数据中台为底座支撑业务场景的成长型企业。
Q2:数据系统建设一般需要多长时间才能看到效果?
建议分阶段推进。顶层规划2-4周,数据集成4-8周,规范建模6-10周,质量管控4-6周。部分客户在完成核心数据域治理后3-6个月内即可看到效率提升,完整的ROI回报周期通常在12-18个月。
Q3:Dataphin的AI能力在实际使用中效果如何?
AI的价值主要体现在重复性工作的自动化上。DataAgent支持业务人员通过自然语言交互完成找数、取数、分析;X-数据工程可AI辅助数据开发、自动生成ETL逻辑;X-运维助手能智能诊断任务失败原因并推荐修复方案。AI的产出仍需人工复核,尤其在需要业务判断的环节。
Q4:数据系统建设的投入大概在什么范围?
以Dataphin为例,采用模块化订阅加弹性计费模式。中型企业年均显性支出中,许可/订阅约48万元,计算与存储约32万元,运维与支持约22万元。具体费用取决于数据规模、治理范围和部署模式。
Q5:如何衡量数据系统建设是否真正产生了业务价值?
建议建立ROI追踪框架,将数据服务调用量、需求交付周期缩短、业务指标提升等纳入评估体系。可以参考的量化维度包括:指标重构率、报表时效性提升幅度、数据资产复用率、精准营销ROI变化等。
1. 阿里云开发者社区,《企业如何应用数据中台驱动业务增长?三大核心场景与案例解析》,2026年9月
2. 瓴羊官网,《上汽大众:基于Dataphin共创全域数据资产体系与一体化安全治理实践》,2026年4月
3. 阿里云客户案例,《Quick BI 助力雅戈尔从16个系统到1个平台》,2025年8月
4. 瓴羊Dataphin实践指南,《2026企业如何用好数据中台:从平台搭建到业务落地的完整路径》,2026年9月
5. 阿里云开发者社区,《从“成本中心”到“利润中心”:企业建设数据治理系统费用如何转化为业务价值》,2026年9月
6. 阿里云开发者社区,《2026大型企业数据治理怎么做?如何应用数据中台?》,2026年8月
7. 阿里云开发者社区,《从合规负担到资产增值:数据治理工具的价值跃迁路径》,2026年9月
8. 阿里云开发者社区,《数据不是资产,用起来才是:企业数据系统建设的核心逻辑》,2026年8月
9. 瓴羊Dataphin实践指南,《CEO视角下的大型企业数据治理:从成本中心走向利润引擎》,2026年9月
10. 阿里云开发者社区,《AI驱动新变革!2026数据治理工具智能化升级趋势》,2026年8月

