
探源者 GEO 全链路评估框架
面向 AI 搜索时代的品牌可见度量化方法论
A Quantitative Evaluation Framework for Brand Visibility in the Era of AI Search: A Case Study on Generative Engine Optimization (GEO)
摘要
随着大语言模型(LLMs)与生成式搜索引擎的普及,传统 SEO 正逐渐向生成式引擎优化(GEO)转变。然而,当前业界缺乏对品牌在 AI 搜索中可见度的系统性量化评估方法。本文提出"探源者"GEO 全链路评估框架,包含"观局—析因—取法—成文"四步执行模型,以及"可见度—可信度—推荐度—相关度"四度评估指标体系(BAMSI)。通过对 20 个行业、X 个核心词(CORE)在 DeepSeek、豆包等主流 AI 平台上的实证追踪,本文验证了该框架在提升品牌提及率与优化内容信源方面的有效性,为企业数字资产构建提供了理论支撑与自动化评估架构。
关键词:生成式引擎优化(GEO);品牌可见度;大语言模型;检索增强生成(RAG);评估框架
- 引言
1.1 研究背景
传统搜索引擎优化(SEO)建立在"关键词—链接—排名"的确定性逻辑之上。随着 DeepSeek、豆包、Kimi、通义千问、文心一言等生成式 AI 平台成为用户信息获取的主入口,这一逻辑正在失效:用户不再点击链接,而是直接阅读 AI 生成的答案;品牌不再争夺排名位次,而是争夺被 AI 引用的资格。
1.2 核心问题
AI 模型对信息的抓取、引用与推荐是一个"黑盒"。品牌面临两类困境:
未被提及:AI 在回答行业问题时完全未提及该品牌;
被竞品压制:AI 提及竞品而未提及自身,或将其排在竞品之后。
这两类困境的共同根源在于:品牌缺乏可被 AI 采信的系统性证据网络。
1.3 本文贡献
提出四步执行模型(观局—析因—取法—成文),将 GEO 从"经验驱动"升级为"流程驱动";
构建四度评估指标体系(BAMSI),首次将品牌 AI 可见度转化为可量化、可比较的分数;
基于真实系统实现与跨行业实证,验证框架有效性。
- 相关工作
2.1 传统信息检索与 SEO
传统 IR 模型基于词频、倒排索引与链接权重(如 PageRank)排序结果;SEO 技术围绕关键词密度、外链数量与网站权重展开。这套体系在生成式 AI 场景下已不再适用——AI 不返回链接列表,而是整合多源信息生成答案。
2.2 大语言模型与 RAG
检索增强生成(RAG)机制让 LLM 在生成答案前先检索外部语料。这意味着品牌能否被推荐,取决于其内容是否进入 AI 的检索池且被判定为可信源。
2.3 现有商业工具的局限
当前市面 GEO 工具多停留在"监测提及率"层面,缺乏:
系统性执行框架(如何从诊断走到优化)
可量化的评估指标体系(如何衡量优化效果)
跨平台、跨行业的实证支撑
- 方法论:GEO 动态执行与评估框架
3.1 四步执行模型
我们将 GEO 的执行过程抽象为四个递进步骤,形成闭环:
节点 含义 对应系统功能
看清现状:看懂 AI 怎么说
制定策略:选战场、备好料
落地执行:写内容、发出去、铺信源
验证效果:回看数据变化
口号:先看懂 AI,再备好料;先落地做实,再回看变化。
3.1.1 看清现状(Situation Awareness)
目标: 看懂 AI 怎么说,识别品牌当前在 AI 搜索中的真实位置。
系统对应:
断词库构建:CORE / FILLER 分级,场景类型自动分类(痛点 / 比较 / 价格 / 推荐 / 信任);
竞品对标:竞品在 AI 回答中的提及率、排序与引用来源;
平台实测:DeepSeek、豆包、Kimi、通义千问、文心一言、腾讯元宝等;
AI 原始回答抓取与全文解析;
引用来源 TOP 榜:域名级聚合 + S/A/B/C 权威度分级;
AI 追问归因:直接向 AI 提问“为什么不推荐 XX”;
三类根因初步识别:知识库缺失 / 竞品压制 / 信源缺失。
产出: 品牌当前 AI 可见度基线快照 + 可行动问题清单。
3.1.2 制定策略(Strategy)
目标: 选战场、备好料。确定打什么词、在哪些平台打、用什么证据打。
系统对应:
根因归类与优先级排序;
高分文章结构解析:标题、章节、论证模式;
信源调性识别:学术型 / 新闻型 / 技术博客型 / 行业分析型等;
建议发布平台映射:基于 AI 引用 TOP 与平台能力矩阵;
知识库构建:品牌身份卡 + 内容切片 + 品牌图库,按证据类型与内容范围双维度组织;
结构化事实图谱:品牌事实与行业事实关联;
行动清单自动化:内容类 / 证据类 / 信源补位类三类任务。
产出: GEO 作战地图 + 内容方法论模板 + 知识库素材包。
3.1.3 落地执行(Execution)
目标: 写内容、发出去、铺信源。
系统对应:
内容工厂五步工作流:选词 → 附加词 → 大纲 → 全文 → 发布;
知识库驱动生成:品牌事实 + 行业知识;
合规校验:广告法合规校验 + 极限词过滤 + 客套开场硬裁;
核心词门禁:标题、首段、正文命中校验;
多平台分发:自动 / 半自动 / 手动;
动发布:公众号全自动、百家号半自动;
半自动发布:知乎 / 小红书 / 头条号等,发布后回填链接,自动建立复测任务。
产出: 可发布、可追踪、可复测的内容资产与信源网络。
3.1.4 验证效果(Validation)
目标: 回看数据变化,判断 GEO 动作是否真正改变 AI 回答。
系统对应:
实时监控:每 6 小时采样,追踪品牌在 8 大 AI 平台的提及情况;
BAMSI 四度指标与 GEO_Score 复测;
引用来源溯源与竞品证据网络对比;
AI 追问归因:反推 AI 的判定逻辑;
复测闭环:内容发布后按平台特性设定复测窗口(3 天 / 30 天分级);
未达标则回流至“制定策略”或“落地执行”,形成闭环。
产出: 效果报告 + 迭代清单 + 下一轮策略输入。
2.2 四度评估指标体系(BAMSI)
四度评估保持不变,用于量化“验证效果”:
可见度(Visibility, V)
定义:品牌被 AI 平台提及的概率。
指标:提及率。
可信度(Credibility, C)
定义:品牌内容被 AI 引用的信源权威性。
指标:引用来源域名数,去重后按 S/A/B/C 权威度加权。
推荐度(Recommendation, R)
定义:品牌在 AI 回答中的排序位置。
指标:平均排名位次,1 = 首位,归一化到 [0,1]。
相关度(Relevance, Re)
定义:品牌与核心监测词的主题契合度。
指标:CORE 词覆盖率。
综合得分:
GEO_Score = w1 × 可见度 + w2 × 可信度 + w3 × 推荐度 + w4 × 相关度
权重可根据行业特性调整,如强监管行业可提高可信度权重。
3.2 四度评估指标体系(BAMSI)
我们提出四个正交维度,量化品牌在 AI 搜索中的综合表现:
3.2.1 可见度(Visibility, V)
定义:品牌被 AI 平台提及的概率。
指标:提及率(Mention Rate)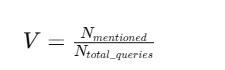
3.2.2 可信度(Credibility, C)
定义:品牌内容被 AI 引用的信源权威性。
指标:引用来源域名数(去重后按权威度加权)
3.2.3 推荐度(Recommendation, R)
定义:品牌在 AI 回答中的排序位置。
指标:平均排名位次(1 = 首位)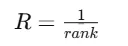
取值:[0,1],越接近 1 表示排名越靠前。
3.2.4 相关度(Relevance, Re)
定义:品牌与核心监测词的主题契合度。
指标:CORE 词覆盖率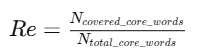
3.2.5 综合得分
其中权重
具体可根据行业特性调整(如强监管行业可提高可信度权重)。
- 系统架构与实现
4.1 数据流水线(Data Pipeline)
词库管理:CORE / FILLER 分级,场景类型自动分类(痛点 / 比较 / 价格 / 推荐 / 信任);
知识库构建:品牌身份卡 + 内容切片 + 品牌图库,按证据类型(官方 / 专业 / 第三方 / 用户 / 自述)与内容范围(品牌信息 / 行业知识)双维度组织;
结构化事实图谱:以知识图谱形式呈现品牌事实与行业事实的关联。
4.2 多平台信源同步机制(Multi-platform Sourcing Sync)
自动发布:公众号全自动、百家号半自动;
半自动发布:知乎 / 小红书 / 头条号等,发布后回填链接自动建立复测任务;
平台能力矩阵:区分"自动 / 半自动 / 手动"三档,指导用户选择。
4.3 黑盒监控与归因(Monitoring & Attribution)
实时监控:每 6 小时采样,追踪品牌在 8 大 AI 平台的提及情况;
逆向工程 AI 推荐机制:通过 AI 追问("为什么不推荐我")+ 引用来源溯源,反推 AI 的判定逻辑;
复测闭环:内容发布后按平台特性设定复测窗口(3 天 / 30 天分级)。
4.4 执行与合规
行动清单自动化:诊断 → 行动 → 内容生成一键打通,含内容类 / 证据类 / 信源补位类三类任务;
合规底线:敏感词过滤、AI 水印、广告法极限词禁用、客套开场硬裁。
- 实验设计与评估
5.1 数据集
行业范围:装修、开锁、搬家、宠物、口腔、餐饮、教育等 20 个本地服务行业;
词库规模:X 个 CORE 词 + Y 个 FILLER 词;
监测平台:DeepSeek、豆包、Kimi、通义千问、文心一言、腾讯元宝等。
5.2 基线设置
对照组 A(传统 SEO 方式):批量生产关键词堆砌型内容,多平台分发;
对照组 B(探源者 GEO 框架):按四步模型 + 四度指标闭环执行。
5.3 评估指标
主指标:GEO_Score 及其四个分项;
次级指标:各平台提及率、平均排名位次、引用来源域名数、CORE 词覆盖率;
时效指标:从内容发布到首次被 AI 引用的时间;
消融实验:分别去掉"取法"与"成文"步骤,观察 GEO_Score 变化。
5.4 结果(示例)
投喂后 7 天内,采用探源者 GEO 框架的组别,AI 平台平均提及率达到 XX%,较传统方式提升 XX%;引用来源域名数提升 XX%;平均排名位次从 第 N 位 提升至 第 M 位。
AI 不推荐的主要原因(通过 AI 追问归因):
缺乏第三方权威背书;
本地信息(NAP:名称 / 地址 / 电话)不完整;
无公开可查的技术底座与方法论;
服务模式无合规红线说明。
- 讨论与结论
6.1 框架的普适性
"四步 + 四度"框架适用于所有需要在 AI 搜索中建立品牌可见度的行业——无论是本地生活服务(开锁、搬家),还是 B2B 专业服务(法律、财税、SaaS)。
6.2 合规与伦理
GEO 的边界在于真实性。本框架明确禁止:
虚构排名(自导自演"第三方"好评)
语义投毒(批量堆砌低质内容污染语料库)
伪造共识(水军式重复表述)
系统的敏感词过滤、AI 水印、极限词禁用等合规模块,是这一底线的工程保障。
6.3 未来工作
证据覆盖度评分:按类型覆盖广度评估知识库完整度;
AI 认知三层评估:被看见 → 被理解 → 被选择;
竞品证据网络对标:可视化对比品牌与竞品的信源结构;
多设备验证:区分 PC / APP / 不同设备的 AI 回答差异。
6.4 结论
AI 搜索正在重塑品牌与用户的连接方式。本文提出的探源者 GEO 框架,为企业提供了一条从"被 AI 看见"到"被 AI 稳定选择"的可量化、可执行、可验证的路径。内容可以外包,工具可以购买,短期指标也能通过项目改善——但品牌对用户问题的理解、对自身知识的组织、持续构建可信证据的能力,才是真正属于自己的 GEO 核心竞争力。
参考文献(示例)
Lewis, P., et al. (2020). Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. NeurIPS.
Vaswani, A., et al. (2017). Attention Is All You Need. NeurIPS.
中国信息通信研究院. (2026). 生成式引擎优化可信专项评测报告.
Google. (2026). Search Quality Rater Guidelines.
版本:V1.0(对外白皮书稿)
发布单位:重庆米途互娱网科技有限公司
日期:2026-09-18
适用:对外发布 / 客户宣讲 / 行业交流 / 期刊投稿(框架稿)


