摘要:NVIDIA用AI Coding Agent和专用Skill迁移ROS 2节点,让GPU数据尽量绕开CPU拷贝。真正值得测试团队学习的不是“AI改了代码”,而是如何用语义、传输路径、回退行为和性能证据证明这次迁移可靠。
一个ROS 2视觉节点已经在GPU上跑TensorRT,模型推理也没有报错。团队把它交给AI Coding Agent做“零拷贝优化”,Agent很快改完依赖、订阅参数和输出缓冲区,编译通过,深度图也能正常显示。
如果测试到这里就结束,最关键的问题仍然没有答案:图像数据真的一直留在GPU上吗?还是中间偷偷绕回CPU,完成一次同步、序列化和再拷贝,只是功能结果看不出来?
9月22日,NVIDIA发布了一篇Isaac ROS工程实践。官方用专门的 migrate-node-to-rosidl-buffer Agent Skill,引导AI Agent审计CUDA节点的数据流,把ROS 2消息迁移到CUDA Buffer,并使用Nsight Systems与运行时Backend检查验证迁移结果。这篇文章最值得测试工程师关注的,不是“AI会改ROS代码”,而是它展示了一种典型的Harness Engineering方法:把一次复杂重构拆成可观察、可断言、可回退的行为链。
功能没变,不等于优化生效
传统功能测试会看输入RGB图像、输出深度图、尺寸、编码和像素范围是否一致。这只能证明业务语义没有明显破坏,却无法证明性能目标已经达成。
NVIDIA原文指出,一个CUDA加速节点的内核很快,并不代表整张ROS 2计算图很快。节点之间的数据仍可能被序列化,经过CPU内存,再重新拷回GPU。模型结果完全正确,延迟和资源成本却没有真正改善。
这类修改至少有四个验收对象: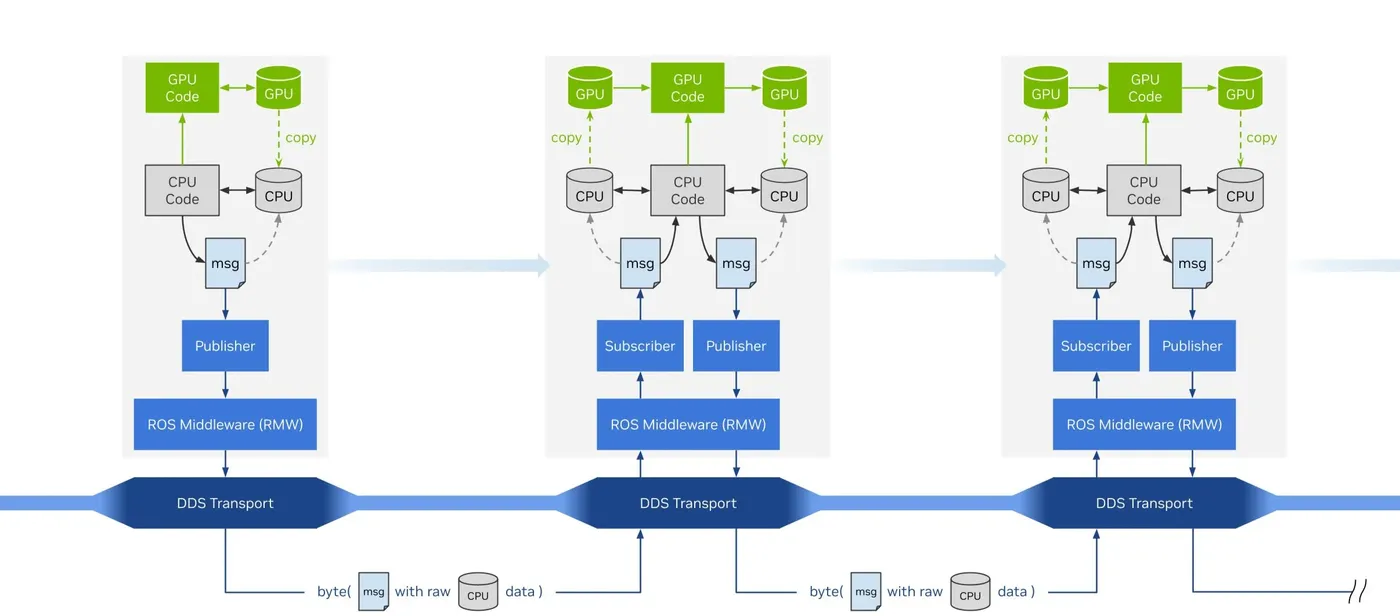
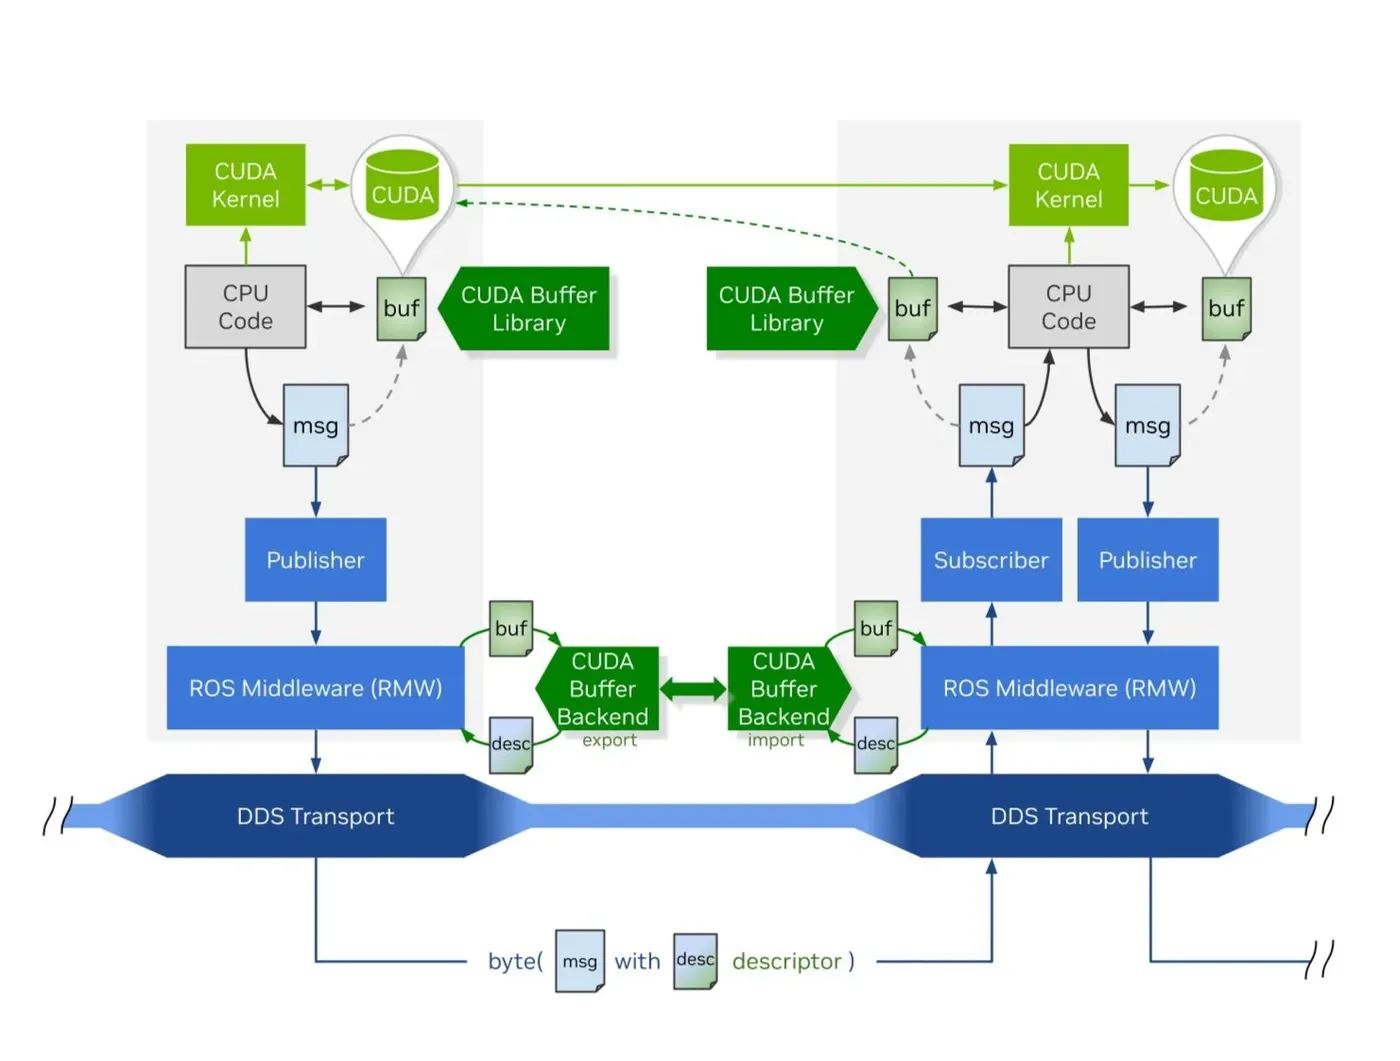
- 业务结果是否保持等价;
- 实际协商出的Buffer Backend是不是CUDA;
- ROS边界是否仍出现与Payload等量的Host-to-Device或Device-to-Host拷贝;
- CUDA路径不满足条件时,CPU回退是否仍然正确。
Agent Skill真正提供的是迁移护栏
官方Skill没有简单要求Agent“把代码改快一点”,而是把工作拆成一串明确任务:记录起始版本与本地改动、确认消息字段兼容性、追踪每个字段从订阅到发布的数据路径、执行只读拷贝边界审计、为每个字段制定迁移计划、完成最小补丁,最后分别验证语义、Backend协商、跨进程传输、Buffer生命周期和真实内存拷贝。
这和普通提示词的区别很大。普通提示词给Agent一个目标,Skill把目标变成了受约束的工程流程;测试再把流程中的关键行为变成断言。这样即使模型更换,团队仍然保留一套稳定的质量标准。
先写一个最小行为断言
下面用Python表达迁移后的核心验收逻辑。它不调用真实ROS环境,但可以直接作为Trace判定器的雏形:
def evaluate_migration(run):
    failures = []
    if run["semantic_diff"] > 0.001:
        failures.append("业务输出不等价")
    if run["eligible_cuda_path"] and run["backend"] != "cuda":
        failures.append("满足条件却没有协商到CUDA Backend")
    if run["eligible_cuda_path"] and run["payload_sized_host_copies"] > 0:
        failures.append("ROS边界仍存在Payload级CPU拷贝")
    if not run["cpu_fallback_ok"]:
        failures.append("CPU回退路径失效")
    if run["p95_latency_ms"] > run["baseline_p95_ms"] * 0.90:
        failures.append("延迟改善未达到预设目标")
    return failures


good_run = {

    "semantic_diff": 0.0002,
    "eligible_cuda_path": True,
    "backend": "cuda",
    "payload_sized_host_copies": 0,
    "cpu_fallback_ok": True,
    "p95_latency_ms": 72,
    "baseline_p95_ms": 100,
}

assert evaluate_migration(good_run) == []
这段断言比“平均延迟下降了”更可靠,因为它同时验证结果、路径和回退。90%的阈值只是教学示例,真实项目应根据基线波动、硬件和SLO设置,不应照抄。
为什么一定要同时测CUDA与CPU两条路径
官方实现保留了CPU回退:只有发布者、订阅者、设备、用户和RMW实现等条件满足时,CUDA路径才能生效。生产环境中只测理想路径,会漏掉最容易出事故的组合。
测试矩阵至少包含:同机同GPU、同机不同GPU、CPU发布者到GPU订阅者、GPU发布者到CPU订阅者、不同进程、不同RMW实现、可选Debug功能开启与关闭。每个组合都记录Backend类型、拷贝次数、结果Diff、P50/P95延迟和显存峰值。
这里还要警惕一个假阳性:运行时打印了 backend=cuda,不代表整个链路都没有CPU拷贝。代码中的可选点云构建或Debug可视化仍可能主动把数据拉回Host。所以Backend断言与Nsight Trace必须同时存在。
把一次成功变成Agent Regression
第一次人工验证通过后,应把证据沉淀为Evaluation Dataset:
- 一组固定输入图像与允许的语义Diff;
- 一份CPU基线与CUDA基线;
- Backend协商事件;
- Host/Device拷贝摘要;
- 关键配置、驱动、ROS与TensorRT版本;
- 一条CPU回退必须成功的负向样本。
CI可以分两层运行。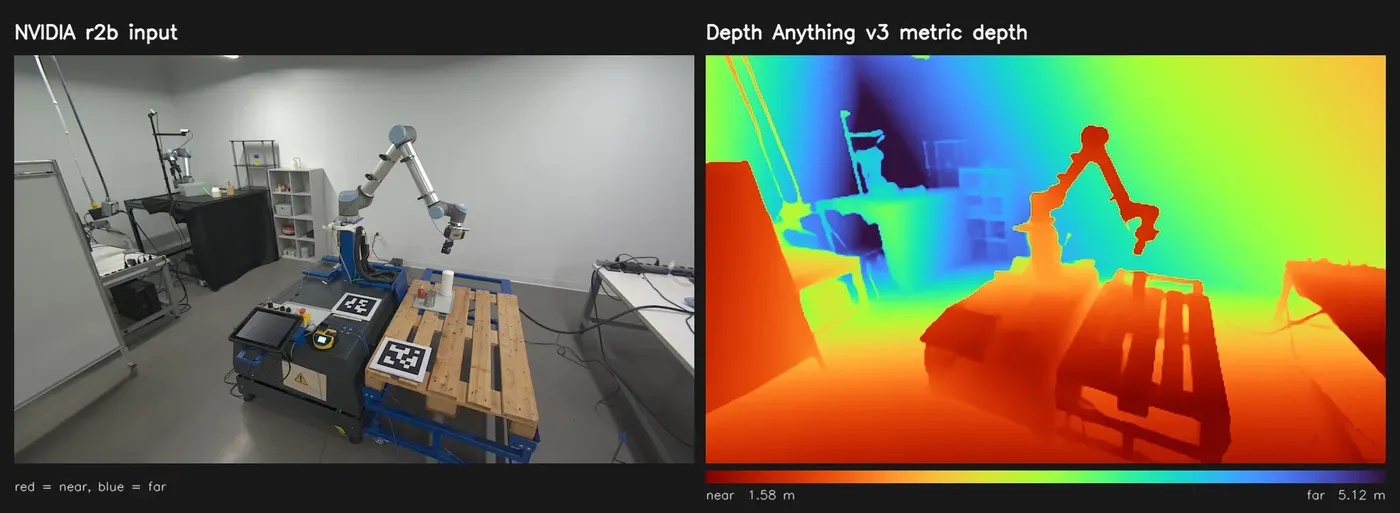
普通PR先做编译、接口契约与小样本语义回归;带GPU的夜间流水线再做真实Backend、Nsight Trace和性能回归。若AI Agent修改了消息字段、内存所有权、CUDA Stream或发布时序,就自动触发GPU回归,而不是所有改动都跑昂贵测试。
测试工程师可以迁移什么
多数测试工程师不需要立刻学会ROS 2和CUDA,先学会这套判断方式就够了:AI Coding Agent声称完成优化时,不只检查代码和最终结果,还要把“优化目标对应的中间行为”变成可观测证据。
数据库优化要看执行计划有没有改变;缓存优化要看真实命中和回源;异步化改造要看调用链有没有被阻塞;GPU零拷贝要看数据路径和Host拷贝。它们背后的测试思想完全相通。
AI写代码的速度会越来越快,但“它到底改变了什么、怎么证明改变生效、失败时是否安全回退”仍然需要测试工程。今天就可以从一个项目开始:给性能需求补上路径断言、回退断言和Trace证据,让代码通过不再等于验收结束。