同一个开发者上午让Copilot解释一段代码,下午让它修改支付逻辑。两个任务都选“自动模型”,背后却可能走不同模型、不同推理预算和不同成本路径。
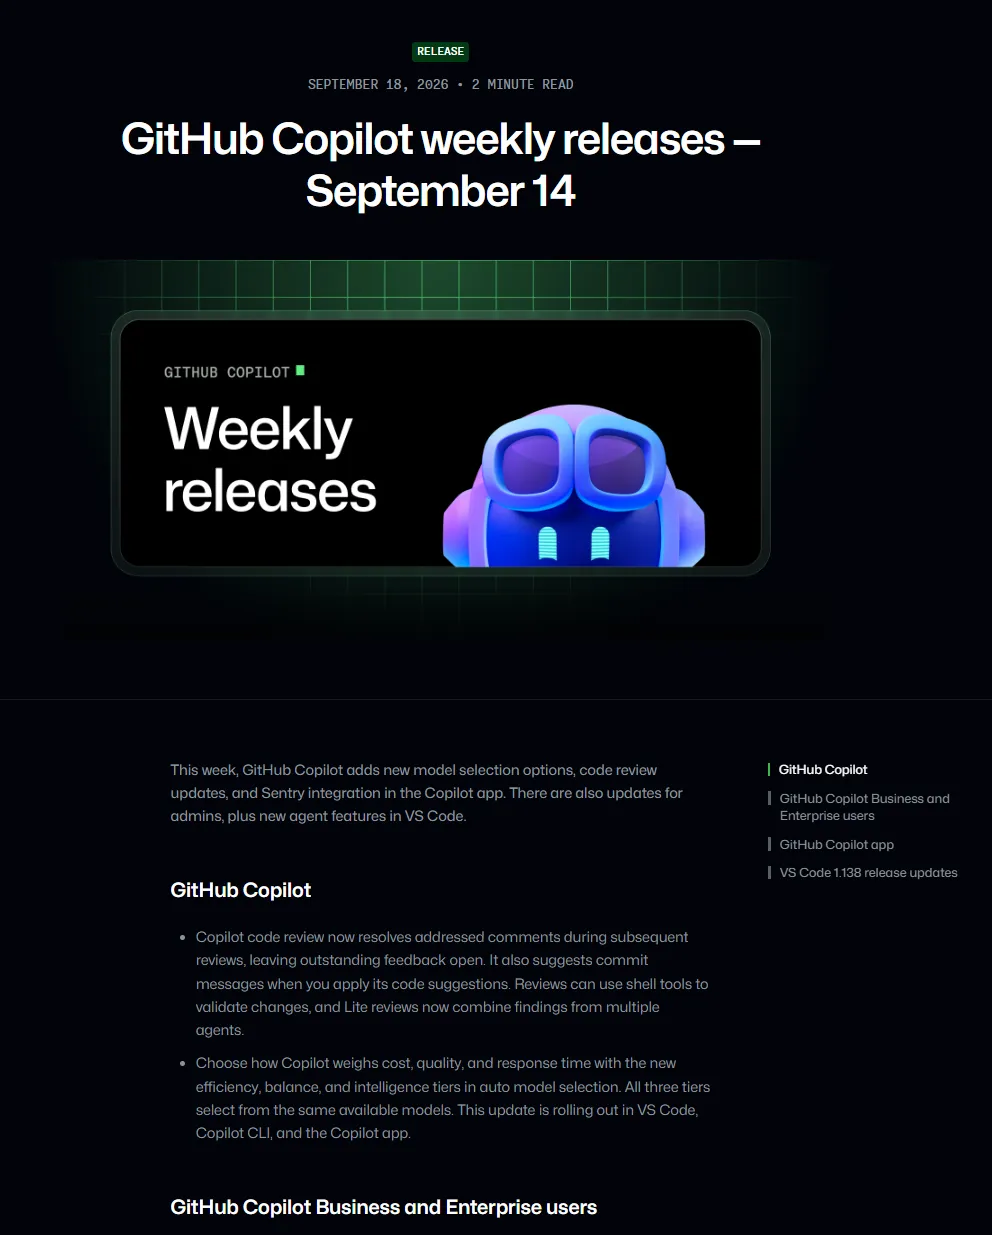
GitHub 9月18日更新显示,Copilot自动模型选择正在加入efficiency、balance和intelligence三个档位,用于权衡成本、质量与响应时间,而且三个档位都从当前可用模型集合中选择。
这不是简单多了三个按钮。对测试团队而言,模型路由本身已经成为会变化的生产代码。
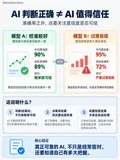
平均成功率会掩盖路由错误
假设100个任务中有80个解释类任务、15个普通改动、5个支付改动。效率档在前80个任务上更快,却在5个支付任务里漏掉一次幂等校验。总成功率可能仍然很好看,但这一次失败不能被80次便宜回答抵消。
因此评测必须先按任务风险分层,而不是把所有请求混成一个Benchmark:
- 低风险:解释、摘要、搜索;
- 中风险:局部代码修改、测试生成;
- 高风险:支付、权限、数据迁移、CI配置;
- 高成本:跨仓库分析、长时间Agent任务。
每一层都有不同的门槛。低风险看首字延迟和成本,高风险优先看行为正确与可回滚性。
把“档位”写成任务级契约
POLICY = {

    "explain": {
   "tier": "efficiency", "max_cost": 0.03, "max_latency": 3.0},
    "code_change": {
   "tier": "balance", "max_cost": 0.20, "max_latency": 20.0},
    "payment_change": {
   "tier": "intelligence", "max_cost": 0.80, "max_latency": 90.0},
}

def assert_route(task, result):
    p = POLICY[task]
    assert result["tier"] == p["tier"]
    assert result["cost"] <= p["max_cost"]
    assert result["latency"] <= p["max_latency"]
    if task == "payment_change":
        assert result["unsafe_tool_calls"] == 0
        assert result["business_tests_passed"]
这不是规定所有团队都必须这样选,而是说明路由决定要可追踪。没有selected_tier、候选模型、切换原因和实际成本,失败后只能猜模型为什么换了。
三档不能共用一套宽松门禁
效率档可以接受回答略短,但不能编造接口;智能档可以更慢,却不能无限重试。平衡档最容易变成“什么都平均”,需要明确它在哪些任务上比另外两档更合适。
建议为每个档位设一条一票否决项:效率档禁止错误工具调用;平衡档禁止扩大文件改动范围;智能档禁止超过最大预算和最长执行时间。
再用同一批任务连续运行多次,观察路由稳定性。如果输入完全相同,今天走A模型、明天走B模型并不一定是Bug,但任务结果、工具边界和成本必须仍在契约内。
自动路由要测故障转移
目标模型限流、不可用或延迟升高时,系统可能切换候选模型。测试要主动注入这些故障,并检查三件事:是否真的切换;切换后的模型是否仍满足任务权限;成本是否被重复尝试放大。
特别是有副作用的Agent任务,重试不能重新执行已经完成的工具调用。模型切换前后要共享幂等键和任务状态,否则一次“智能降级”可能变成两次退款。
用退款任务看清“答案对、行为错”
假设用户说:“订单A重复扣款,请退回多扣的部分。”三个档位最后都回答“已处理”,只比较自然语言答案,看不出区别。真正要检查的是轨迹:是否先查询订单与支付流水;是否确认只存在一笔可退金额;是否把退款币种和原支付币种对齐;是否在执行前要求高风险确认;失败重试时有没有沿用同一个幂等键。
可以把断言拆成四层:Outcome断言最终退款金额;Behavior断言调用顺序和禁止工具;Budget断言Token、调用次数与总成本;Stability断言同一输入重复运行时,核心业务结论不能漂移。效率档如果省了成本却跳过支付流水核对,必须失败;智能档如果多推理了五轮却没有提高业务正确率,也不能因为“用了更强模型”就豁免。
评测集也要故意加入信息不足的请求,例如用户只说“帮我退了”。合格行为是追问订单与退款范围,不是根据历史上下文猜一个订单直接执行。模型档位可以影响回答速度和分析深度,不能改变最基本的安全边界。
发布报告要能定位退化来自哪里
当自动档位的成功率下降,不要立刻归因于某个模型。可能是任务分类器把支付改动分成普通代码改动,也可能是候选模型池变化、系统提示变化、工具超时或上下文截断。
因此每条回归记录至少保留任务类别、风险级别、所选档位、最终模型、路由理由、工具轨迹、成本、延迟和断言结果。发布前按“任务类别×档位”查看分位数和失败样本,而不是只看一张总平均表。这样才能区分:模型能力退化、路由选择错误,还是工具链本身不稳定。
版本回归不能只固定模型名
自动路由的候选池会变化,固定某个模型做回归只能验证模型本身,不能验证真实产品路径。更合理的做法是保留两组测试:固定模型基准用于定位能力变化;自动档位回归用于验证路由系统。
每次发布报告都应该回答:各任务层选择了什么、为什么切换、成功率与成本怎么变、最差5%的任务发生了什么。不要只给一个平均得分。
对测试工程师意味着什么
过去我们测负载均衡,关心请求分到哪台机器;现在测模型路由,除了可用性,还要关心请求分给了哪种能力、花了多少钱、执行了什么行为。
下一步可以从20条真实任务开始,给每条标注风险、允许档位、成本上限和业务断言。三档分别跑一遍,你会很快发现:所谓自动选择的质量,不在于它总能挑到“最强模型”,而在于它能为不同任务挑到足够可靠、可解释、付得起的模型。