摘要:
一个 Agent 真正跑起来以后,会产生大量判断:
该调用哪个 Tool?加载哪个 Skill?哪些上下文值得保留?这次操作有没有风险?执行结果需不需要人工检查?
过去,这些问题很多都交给 LLM。
但 Jev 这类 System One Model 出现以后,一个新的 Agent 架构开始值得关注:
LLM 继续负责复杂推理,但高频、明确的判断任务,可以单独拆出一层。
这可能会直接影响未来 Agent Harness 的设计。
一、今天的 Agent,其实让 LLM 管得太多了
很多人理解 Agent,会把注意力放在:
模型多强、Tool 有多少、Skill 做得好不好。
但真正把 Agent 跑到生产环境,会发现另一个问题:
一次任务里面,LLM 被调用得太频繁了。
比如用户说:
帮我测试一下这个网站的登录功能。
Agent 可能要连续判断:
```text id="38owho"
用户到底想干什么?
↓
应该加载哪个 Skill?
↓
应该调用 Playwright 还是其他工具?
↓
哪些页面信息值得放进上下文?
↓
当前结果是否异常?
↓
是否继续执行?
↓
最终结果是否可信?
这里真正需要复杂推理的,其实没有那么多。

大量问题只是:

**分类、路由、评分和判断。**

但今天很常见的做法是:

每碰到一个问题,就调用一次 LLM。

于是 Agent Harness 慢慢变成:

```text id="v17bj7"
判断一次
→ LLM

路由一次
→ LLM

验证一次
→ LLM

过滤一次
→ LLM
功能当然可以跑。
问题是:
延迟、成本和不确定性也跟着不断叠加。
二、Jev 提出了另一种拆法
TypeSafe 在 2026 年 9 月发布 Jev 时,把它定义成一种 System One Model:
输入程序状态,直接输出类型化决策、概率和置信度,而不是生成一段自由文本。([TypeSafe AI][1])
例如:
```text id="j1qzhr"
应该调用哪个 Tool?
Playwright:91%
HTTP Client:6%
Search:2%
Other:1%
程序不需要再等模型生成:

```json id="cqontz"
{
  "reason": "...",
  "tool": "playwright"
}
再解析 JSON、校验 Schema、提取字段。
而是直接根据判断结果继续执行。
这意味着 Agent Harness 里可能出现一个新的分层:
LLM 负责“想”,Jev 负责大量快速“选”。
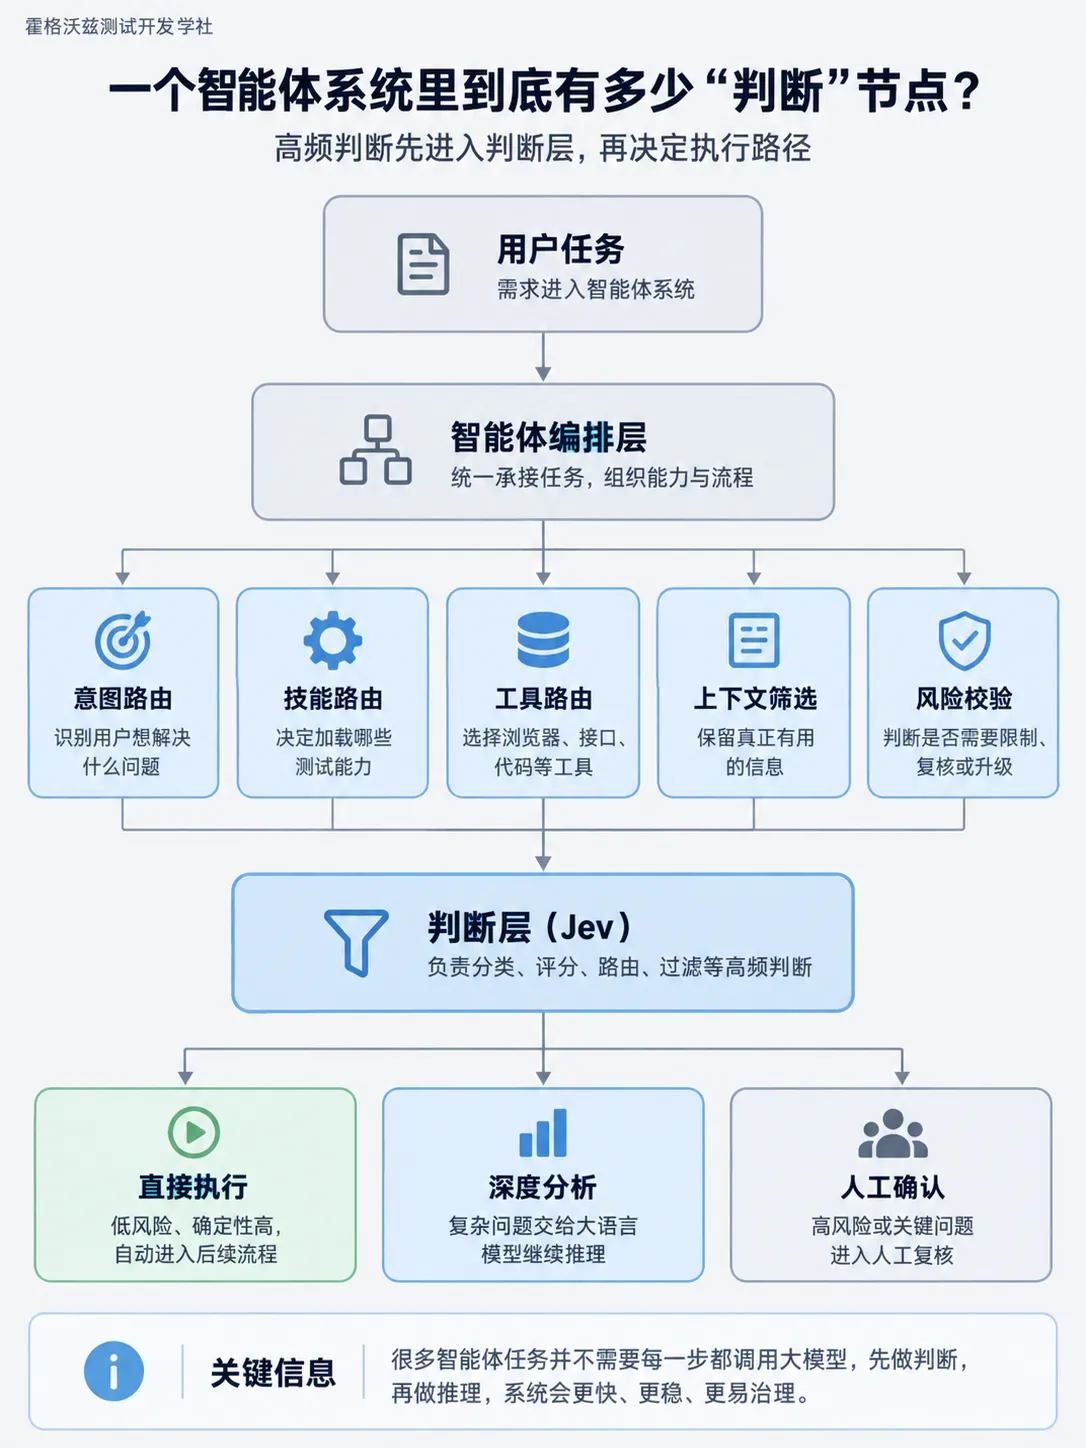
原来 Agent Harness 里面,本身就存在大量判断型工作。
三、第一类:Tool Routing
这是最直接的场景。
一个 Agent 可能同时拥有:
```text id="agbi74"
Playwright
数据库
HTTP API
搜索
Python
文件系统
用户来了一个任务,到底调用谁?

过去常见的方法是给 LLM 一堆 Tool Description:

> 请根据用户需求选择最合适的工具。

工具少的时候没什么问题。

但当 Agent 开始挂:

几十个 Tool、几十个 MCP、几十个 Skill,

路由本身就开始变成一个独立问题。

这时候可以先经过判断层:

```text id="n612u2"
用户需求
↓
Tool 分类与评分
↓
候选 Tool
↓
Agent 执行
LLM 不需要每次从几十个工具里重新理解一遍。
这其实也是 Harness 很重要的一项职责:
缩小模型当前需要面对的选择空间。
四、第二类:Skill Routing
Skill 也是一样。
未来一个企业 Agent 很可能不是拥有 3 个 Skill,
而是:
30 个、
100 个,
甚至更多。
比如一个测试 Agent 可能有:
```text id="pqbwvp"
Web 测试 Skill
App 测试 Skill
接口测试 Skill
SQL 检查 Skill
日志分析 Skill
性能测试 Skill
安全测试 Skill
用户说一句:

> 帮我看看为什么今天支付接口测试失败这么多。

真正需要先解决的是:

**加载哪些能力?**

如果一开始把所有 Skill 都塞进上下文,

上下文会越来越重。

如果全部让 LLM动态选择,

路由本身又会不断消耗推理资源。

所以未来可能越来越常见:

```text id="enq5jw"
用户任务
↓
快速判断
↓
筛出 2~3 个 Skill
↓
交给 LLM 深度执行
这其实就是把:
“能力发现”
和:
“能力使用”
拆开。
五、第三类:Context Filtering
这个问题可能比 Tool Routing 更重要。
现在做 Agent,越来越多人会遇到:
不是上下文不够,而是上下文太多。
一个复杂任务可能同时存在:
用户历史对话、
文件、
RAG 检索结果、
Tool 返回、
Agent Memory、
执行轨迹……
如果全部塞给模型:
上下文会越来越长。
但真正对当前一步有用的信息,可能只占很少一部分。
于是 Harness 需要不停判断:
这段内容到底值不值得继续留在 Context 里?
例如:
```text id="i8t3qn"
RAG 检索 100 条
↓
相关性判断
↓
留下 10 条
↓
进入 LLM
这种任务不一定需要一个强模型写一大段分析。

它需要的是:

**大量、快速、低成本的相关性判断。**

TypeSafe 官方目前也把 Jev 的典型应用定义为 classify、route、score、extract、branch 等软件内部决策。([TypeSafe AI][1])

这也是为什么我认为:

**Jev 真正可能影响的不是聊天机器人,而是 Agent 基础设施。**

---

## 六、第四类:Guardrail

Agent 越来越强以后,还有一个绕不开的问题:

**什么事情可以让它直接做?**

比如:

读取网页,

风险很低。

删除文件,

风险就不一样。

修改数据库,

风险更高。

发送邮件,

还涉及外部影响。

于是执行之前,需要判断:

```text id="hh1f77"
允许自动执行

需要二次确认

需要人工审批

禁止执行
这本质上也是一个决策节点。
当然,真正明确的安全边界依然应该写成规则。
例如:
```text id="eho6wp"
禁止删除生产数据库
这种事情就不应该交给 AI 判断。

但现实世界里还有大量灰度问题:

规则 + 判断模型 + 人工确认,

可能会比:

**“全都让 LLM 自己判断”**

更容易控制。

---

## 七、第五类:Agent Trace Review

这个场景对测试工程师尤其重要。

Agent 执行结束以后:

谁来判断这一轮到底有没有问题?

TypeSafe 这次公开的 Workflow Eval 里,就专门设计了一个 **Agent Trace Observability**。

输入包括:

Agent 的指令、完整对话、Tool Call、工具返回结果、最终回答以及用户反馈。

系统最后并不是生成一篇长报告,

而是直接决定:

```text id="tyf7jr"
自动关闭

人工检查

优先检查

创建 Issue

路由处理

立即通知值班人员
其中还会先检查不可逆操作权限、任务完成情况以及用户是否满意,再由程序决定下一步动作。([Evals][2])
这个例子很值得测试工程师关注。
因为未来:
Agent Trace 很可能就是新的“自动化测试结果”。
以前我们看:
```text id="7e51vk"
Pass / Fail
以后可能需要看:

```text id="0kyml5"
正常执行

静默失败

越权操作

结果异常

需要人工复核
Agent 测试会比传统自动化测试复杂很多。
八、未来 Agent Harness 可能会变成五层
如果把前面的能力放到一起,一个比较有意思的 Agent 架构开始出现。
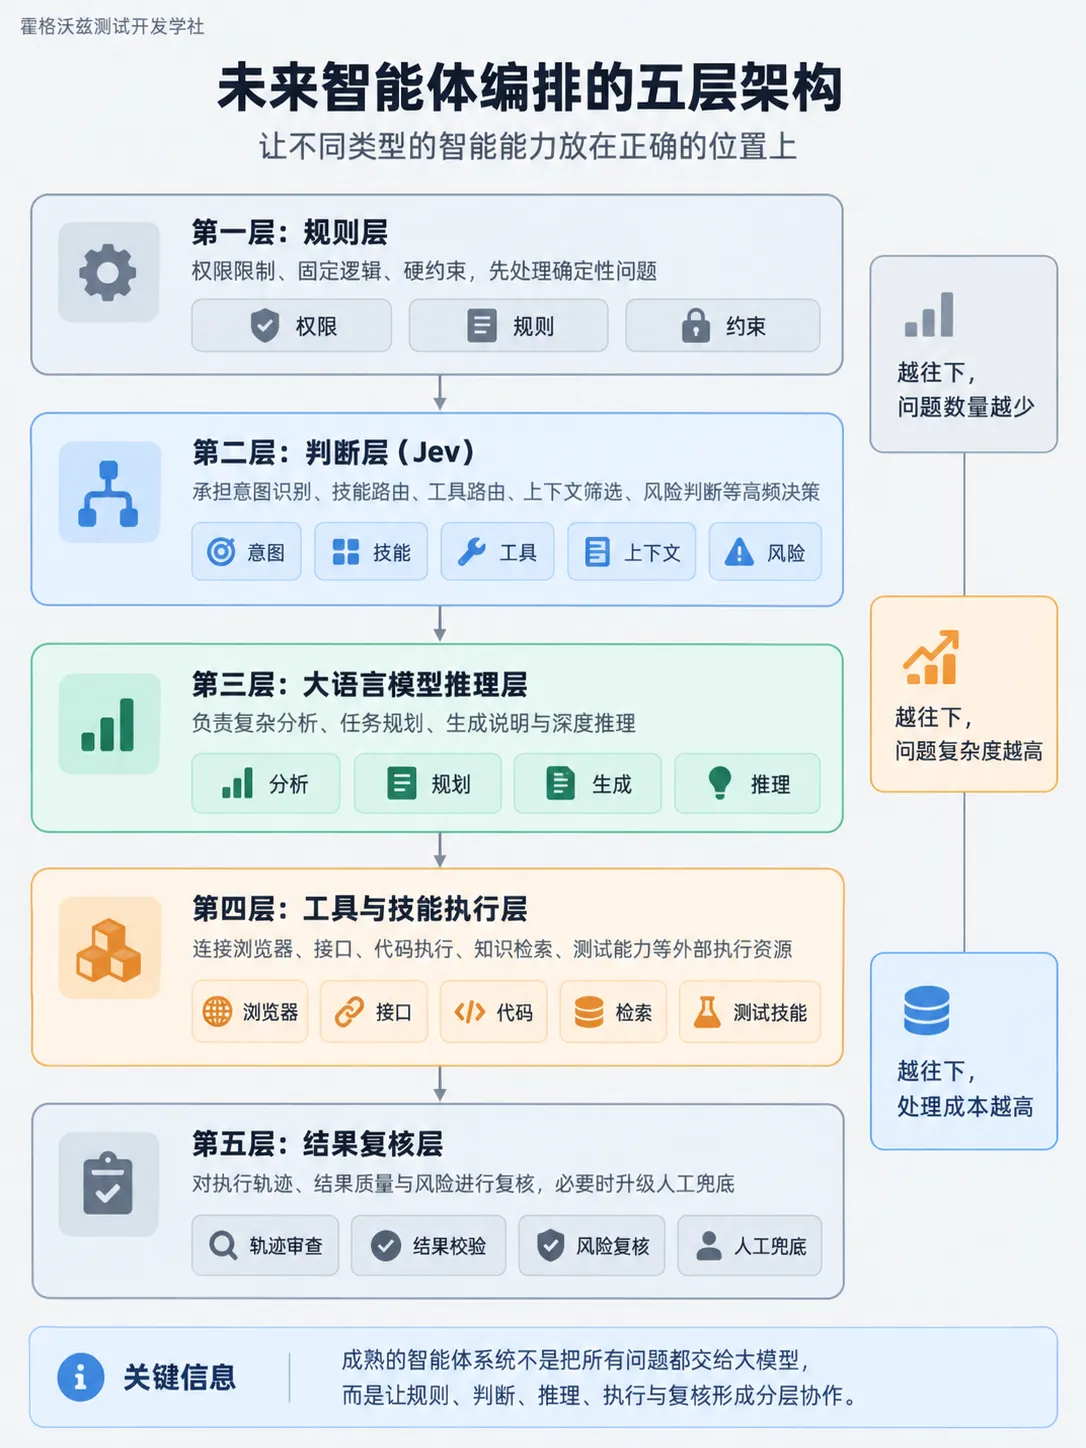
这里最关键的变化是:
LLM 不再是 Agent 里的唯一智能组件。
它可能只是其中最强的“慢思考层”。
周围还有:
规则、
路由器、
判断模型、
工具、
评测模型、
人工审批。
Agent Harness 真正要做的,是把这些能力组织起来。
九、为什么测试开发工程师尤其需要关注?
因为一旦 Agent 架构这样变化,
测试对象也会跟着变化。
过去测试一个 Agent,我们可能重点看:
最终答案对不对?
以后显然不够。
还要测试:
- Skill 有没有路由对?
- Tool 有没有选错?
- Context 有没有误删关键数据?
- Guardrail 有没有漏判?
- 高风险操作有没有正确升级?
- Trace Review 有没有把异常任务自动关闭?
Agent 的 Bug 很可能不再发生在:
“模型回答错了。”
而是发生在:
“前面的某一个判断节点选错了。”
这其实给测试开发提出了一个新的问题:
如何测试整个 Agent 决策链?
写在最后
Jev 现在还是一个非常新的产品,TypeSafe 也明确标记它仍处于 Early Access 阶段。([TypeSafe AI][1])
所以现在讨论:
Jev 会不会成为 Agent 标配?
还太早。
但它提出的问题很值得关注:
一个 Agent 里面,真的所有智能任务都应该交给 LLM 吗?
未来的答案很可能是:
不是。
确定的问题交给规则。
高频判断交给 Decision Model。
复杂问题交给 LLM。
执行交给 Tool 和 Skill。
最后再通过 Harness 把整个过程组织、观测和测试起来。
所以 Agent Harness 接下来真正竞争的,
可能不只是:
“能接多少模型、多少 MCP。”
而是:
能不能把不同类型的智能,放到正确的位置上。
而这件事,
对 Agent 开发者重要,
对测试开发工程师同样重要。