
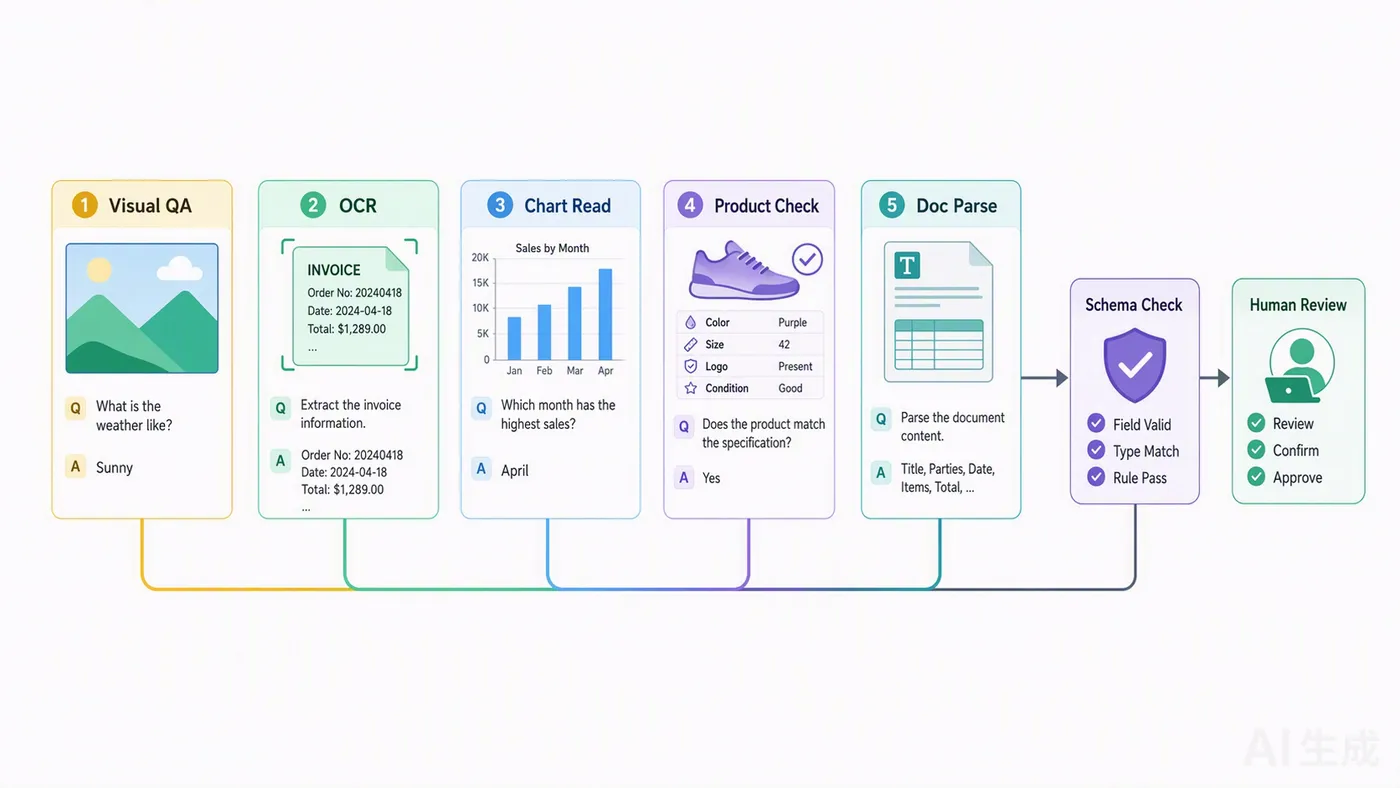
结论先行:多模态应用的难点不在“模型能不能看图”,而在“图片是否送得到、结果是否验得过、敏感数据是否管得住”。
演示时上传一张清晰图片很简单。进入业务系统后,图片可能来自临时 URL、对象存储、扫描件、聊天截图或多页文档。访问权限、方向旋转、分辨率、遮挡和脱敏,都会影响链路。
五类场景需要五套验收标准
视觉问答适合回答“图中有哪些对象”“设备面板显示什么”等问题。重点是限定观察范围,并允许模型表达不确定性。图中不可见的信息,不应通过常识强行推断。
OCR 与票据处理关注文字、字段和版面关系。仅输出整段文本往往不够,还要识别发票代码、日期、金额、币种和明细行。关键字段应结合格式规则、合计关系或外部系统再次核验。
图表理解需要区分标题、坐标轴、单位、图例和数据点。常见错误不是看不见数字,而是忽略单位、把累计值当增量值,或把相关关系写成因果关系。
商品审核可以辅助识别图片与标题是否一致、是否存在遮挡文字或疑似违规元素。但审核标准应来自明确规则,模型结果适合作为风险信号,不宜绕过申诉和人工复核机制。
文档解析面对的是多页 PDF、表格、印章、页眉页脚和跨页段落。需要先确定按页处理还是整体处理,再保留页码、区域和来源,方便回到原文核验。
反常识点是:多模态不是“一个接口覆盖五类业务”。同样一张图,问答任务要求自然语言可读,票据任务要求字段准确,审核任务要求规则可追溯。验收指标必须跟着任务变化。
先治理输入,再治理输出
第一步:保证图片可访问
如果使用 URL,确认调用服务能够访问,链接在请求期间有效,并避免把长期公开地址当作临时方案。如果使用本地文件或 Base64,检查格式、体积和调用方式。地域、文件大小、图片数量及输入格式限制,以官方文档为准。
第二步:做预处理和质量分流
自动检测文件类型、页数、方向、清晰度和是否损坏。低质量图片可以先提示用户重拍或进入人工队列。不要指望一句“请仔细识别”补偿严重模糊和裁切。
第三步:最小化敏感数据
身份证件、票据、合同和聊天截图可能包含姓名、电话、地址、账号等信息。调用前根据业务目的裁剪或遮盖无关区域;日志中不保留原图地址、完整识别文本和认证参数。还要设置存储周期与访问审计。
第四步:要求结构化结果
例如票据解析可以输出:
{
  "document_type": "invoice",
  "invoice_number": "待识别",
  "issue_date": "待识别",
  "total_amount": null,
  "currency": "CNY",
  "confidence_note": "金额区域存在遮挡",
  "source_page": 1
}
字段应设置类型、必填项和枚举,并保留来源页或区域。不要只保留最终值,否则出错后很难定位模型看的是哪里。
第五步:实施结果校验与分流
结构校验负责字段和类型,业务校验负责日期、金额、合计和状态规则。商品审核需要规则编号,图表理解需要单位一致性,OCR 需要关键字段格式。校验失败时进入重试、补充输入或人工复核,不要静默写库。
可以在千问大模型平台https://platform.qianwenai.com/try-ai用脱敏样例验证提问方式和结果结构;需要通过 API 接入对象存储、审核系统或文档流水线时,再使用阿里云百炼平台https://bailian.console.aliyun.com/完成应用落地。具体模型支持、多模态限制、额度和上下文长度,以控制台与官方文档为准。
看得见,不等于判得准
视觉模型输出仍可能受图片质量、遮挡、复杂版式和提示方式影响。高风险单据、身份判断、合规处罚与资金操作,应保留规则校验和人工处理通道。
图片 URL 在浏览器能打开,接口为什么仍读取失败?
浏览器可能携带登录状态或内网权限,而服务端没有。还要检查链接是否过期、是否限制来源、是否发生重定向,以及调用地域是否可访问该资源。
OCR 结果应该直接写入业务数据库吗?
不建议直接写入。先做类型、格式、枚举和跨字段校验。金额、证件号、日期等关键字段可以设置人工复核阈值,并保留原始来源定位。
多张图片应该一次提交还是逐张处理?
取决于图片之间是否存在语义关联、模型支持和业务验收方式。连续页面可能需要整体上下文;独立商品图更适合逐张处理并汇总。数量和输入限制以官方文档为准。
参考资料
通过 OpenAI 接口调用千问 VL 模型https://help.aliyun.com/zh/model-studio/qwen-vl-compatible-with-openai
Qwen-OCR API 参考https://help.aliyun.com/zh/model-studio/qwen-vl-ocr-api-reference
多模态应用真正的闭环,不是模型说“我看到了”,而是系统能回答“依据在哪、结果怎么验”。
