越来越多企业把 Agent 从 Demo 推入生产环境,但 Agent 的不可预测性、长程推理黑箱、工具调用风险,让传统的日志与监控手段越来越不够用。
为了让更多企业看清 Agent 上线后的真实运行状态、建立可评估与可优化的工程闭环,我们于 8-9 月在北京、上海、深圳三城发起 「Agent 评估与优化 · Close the Loop」 的系列开发者沙龙,集中分享我们在 Agent 观测、审计、评估、实验回测、优化等方面的实践。
此外,我们尝试通过这种方式对企业 Agent 的落地现状做一个基本的摸底。总体上,呈现出需求强烈、基建薄弱、认知体系化不够的特点。比如,超过六成受访者已进入 POC 或生产阶段,大家推理质量提升、Skills 沉淀、审计可追溯的诉求却非常强烈;但对完整 trajectory 观测、自动化评估、数据回灌闭环的掌握度仍然很低,能拿到完整 trajectory 的仅 13.4%;优化的北极星指标、评估基建还未完全建立起来;另外,由于评估和优化依赖平台方和业务方共同参与,如何进行组织分工是最优解,也是大家讨论非常多的。
本文对 700+ 的调研数据,进行汇总和分析,希望对提升企业 Agent 建设质量,有所帮助。
数据说明: 700+ 的调研数据来自三场线下活动的报名问卷,仅作为参会群体的画像研究。
核心结论
1. Agent 治理能力还未跟上
约六成受访者已进入 POC 或生产阶段,但真正规模化生产的不足 5%。市场已经从“做 Demo”转向“上生产”,但大规模治理的能力尚未跟上。
2. 观测是第一个拦路虎
近半数受访者没有专门观测工具,四成仍在用日志 / print 人工拼调用链,能拿到完整 trajectory 的仅 13.4%。没有轨迹,评估与优化都缺乏事实依据。
3. 评估仍以人工和经验驱动为主
43.4% 靠人肉抽查或用户反馈,仅 6.9% 实现完整线上评估 + A/B 数据驱动发版。Agent 质量的判断仍高度依赖主观经验。
4. 优化闭环远未形成,但需求旺盛
52.6% 完全没有数据回灌闭环,仅 2.8% 已有数据飞轮。与此同时,81.7% 希望提升推理质量,78.1% 希望把经验沉淀为可复用 Skills。
5. 审计合规是普遍且迫切的约束
94.2% 的业务有或预见有审计要求,但 36.2% 有要求却还没能力落地。可追溯不是未来问题,而是当前 Agent 进入生产前的真实瓶颈。
调研分类与解读
1. 受访者画像
岗位构成、Agent 所处阶段和主流技术栈,决定了后续观测、评估、优化需求的差异性,也决定了 Close the Loop 系列活动必须同时服务开发者、架构师和产品决策者三类人群。
Q1:您的岗位是?
了解参会者的角色构成,判断内容应同时覆盖工程深度与业务视角。
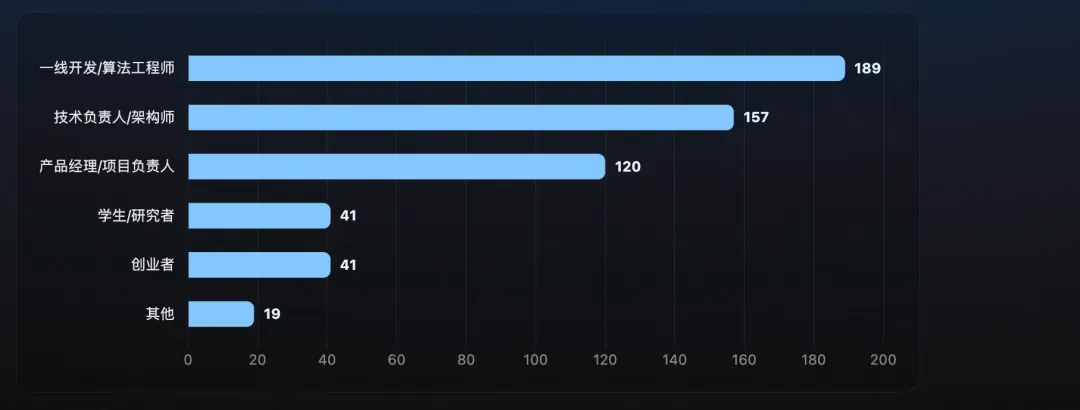
解读: 工程师与架构师合计占比超过 60%,说明活动受众以技术决策者和执行者为主;产品经理/项目负责人占 21%,显示 Agent 项目已经开始从实验室走向业务侧立项。学生/研究者与创业者各占 7%,意味着社区中仍有大量早期探索者。
Q2:您的 Agent 目前处于哪个阶段?
识别 Agent 落地的成熟度分布,区分学习、POC、生产与规模化四个阶段。
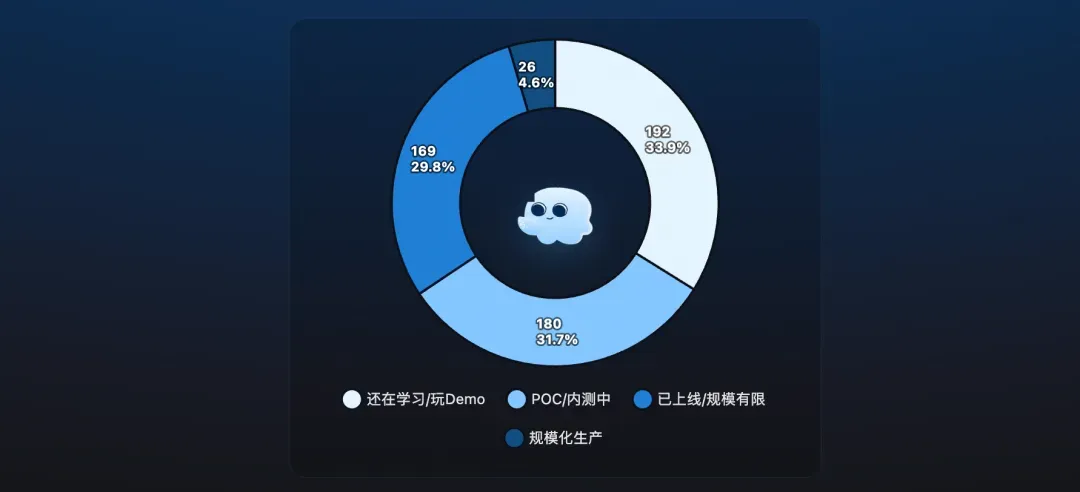
解读: 34% 仍处于学习/ Demo 阶段,但 66% 已经进入 POC 或生产,Agent 从概念验证到真实落地的窗口已经打开。值得注意的是,真正规模化生产的仅占 4.6%,说明从“能跑”到“能管”仍缺少成熟范式。
Q3:您主要用什么框架 / 平台构建 Agent?(多选)
框架生态高度分散,LangChain 与基础大模型直接调用位居前列。
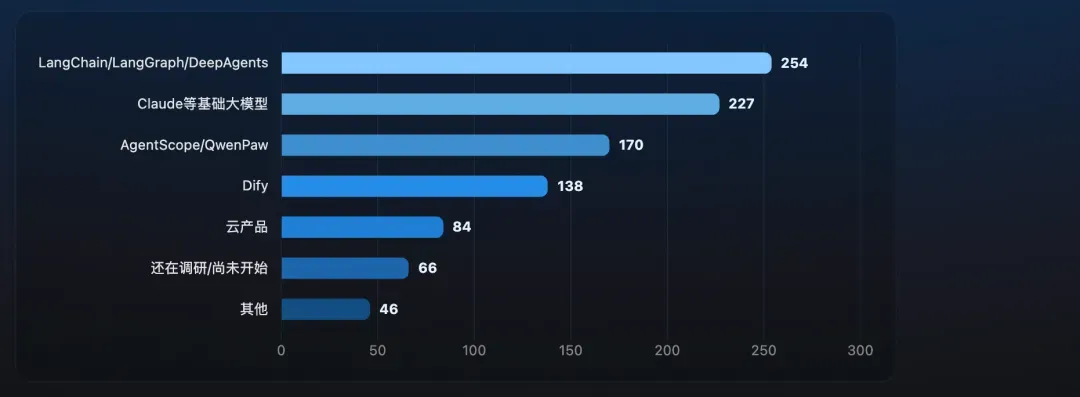
解读: LangChain 生态与基础大模型直接调用双峰并立,说明市场既有“框架派”也有“模型原生派”。AgentScope / QwenPaw 这类 Agentic 框架占比 30%,增长较迅速,12% 仍在调研,Agent 呈现构建碎片化、多源 Agent 管理需求增多的趋势。
2. 观测 Observe
只有先看清 Agent 的完整运行轨迹,才能定位问题、量化表现、形成评估与优化的事实依据。这部分揭示了当前从业者如何排查线上故障、使用什么工具,以及距离完整 trajectory 观测还有多远。
Q12:线上 Agent 出问题时,您现在怎么定位?
反映当前问题定位手段的成熟度,人工拼调用链仍是主流。
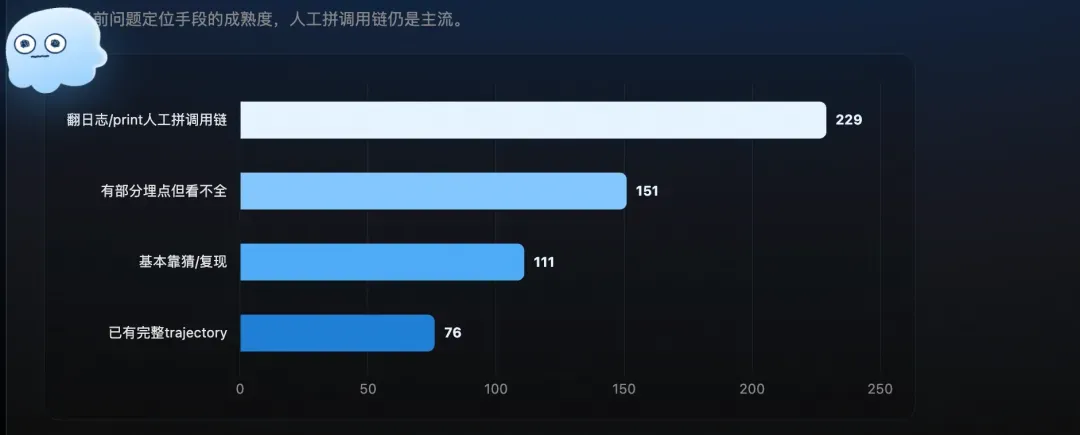
解读: 40.4% 仍在用最原始的日志/ print 拼调用链,19.6% 基本靠猜或复现,意味着近六成团队缺乏可视化轨迹。仅有 13.4% 拿到完整 trajectory,这是 AgentOps 成熟度最直观的短板。没有轨迹,评估和优化都缺乏共同事实基础。
Q13:您在用哪些可观测工具?
接近半数没有专门工具,开源方案与自建 APM 占一定份额。
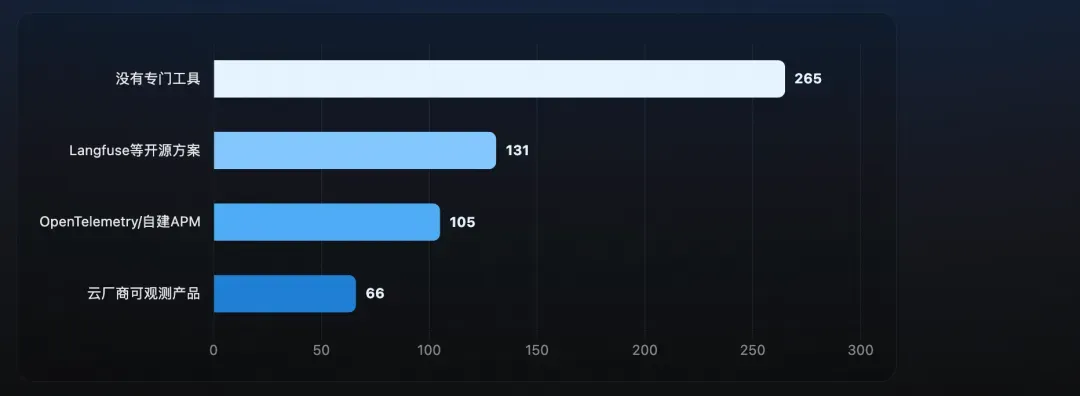
解读: 46.7% 没有专门工具,与 Q12 中近六成团队定位手段落后相互印证。开源方案占 23%,自建 APM 占 18.5%,说明先行者已经在填补空白,但缺少统一标准;云厂商可观测产品渗透率仅 11.6%,存在较大增长空间,开箱即用成为工具或平台型产品的核心竞争力。
3. 审计 Audit
审计与可追溯是 Agent 进入生产环境的硬约束,尤其在金融、政企、医疗等关键行业。这个分类衡量合规需求的真实强度与落地能力之间的落差,Agent 上线之后必须解决“可解释、可回放、可追责”。
Q15:您的业务对 Agent 的可审计 / 可追溯有要求吗?
合规压力显著高于落地能力,已上线团队“有要求没落地”的比例最高。
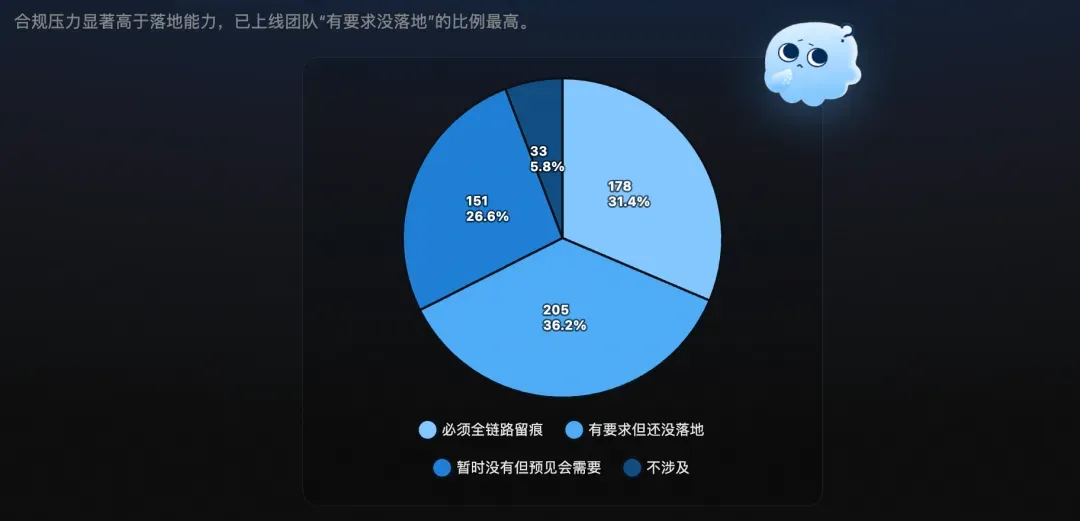
解读: 审计需求渗透率高达 94.2%,其中 36.2%“有要求但还没落地”,是最典型的“想要但做不到”。已强制全链路留痕的仅占 31.4%。这说明可追溯不是未来问题,而是当前 Agent 进入生产前的真实瓶颈。
4. 评估 Evaluate
评估是判断 Agent 是否更好的标尺。这部分对比了人工经验驱动与数据驱动两种评估模式,展示指标体系的普及程度,以及自动化评估和 A/B 实验在当前的渗透率。
Q17:您现在如何判断 Agent 回答“够好”?
评估方式仍以人工为主,数据驱动发版者极少。
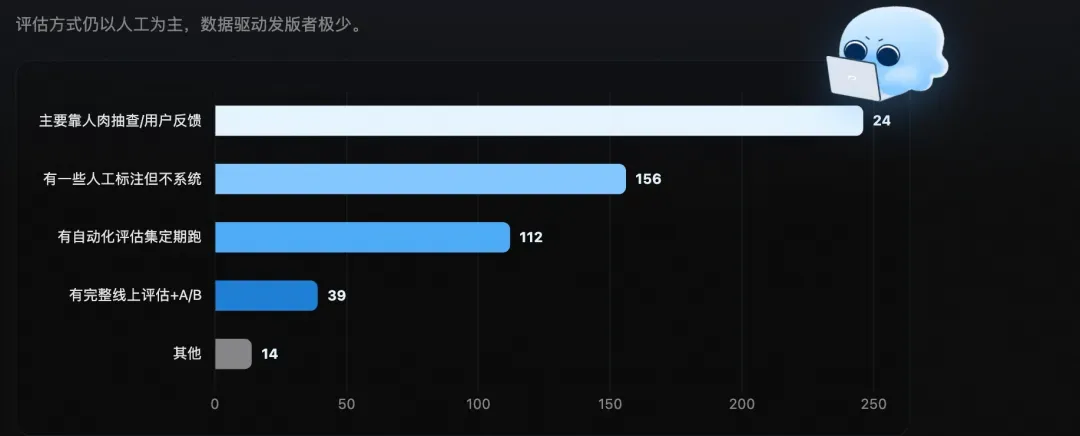
解读: 人工驱动评估合计占比 70.9%,自动化评估仅占 19.8%,完整线上评估 + A/B 数据驱动发版仅 6.9%。这与 Q10 中 31.4% 已上线形成明显落差:大量 Agent 已经上线,却依然靠人肉判断质量。这种状态风险高、不可持续,也解释了为什么“Agent-as-a-Judge”和数据驱动发版会成为下一阶段热点。
Q18:您关注 / 用过哪些评估指标?(多选)
任务完成率、工具调用准确率最受关注,近三成尚未建立指标体系。
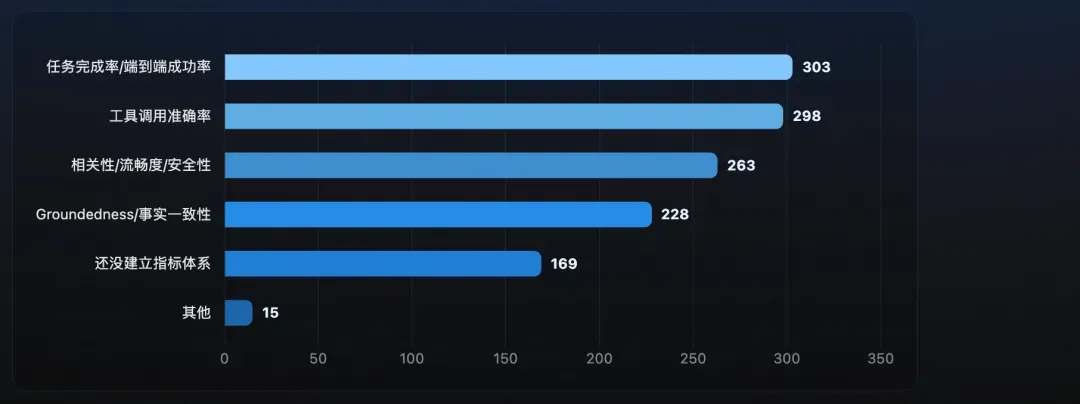
解读: 任务完成率与工具调用准确率是最受关注的硬指标,合计超过半数受访者关注。近三成(29.8%)尚未建立指标体系,说明有指标意识和有指标体系之间存在断层。事实一致性占比 40.2%,反映 RAG / 工具调用场景下对幻觉控制的重视。
5. 优化 Optimize
优化是 Close the Loop 的最终目标。这个分类关注团队是否已经形成数据回灌闭环,以及他们希望通过 Agent 进化解决哪些核心痛点,从推理质量、知识沉淀到成本与迭代效率。
Q20:您有没有建立“数据回灌 → 持续优化”的闭环?
优化闭环整体薄弱,超过半数完全没有闭环。
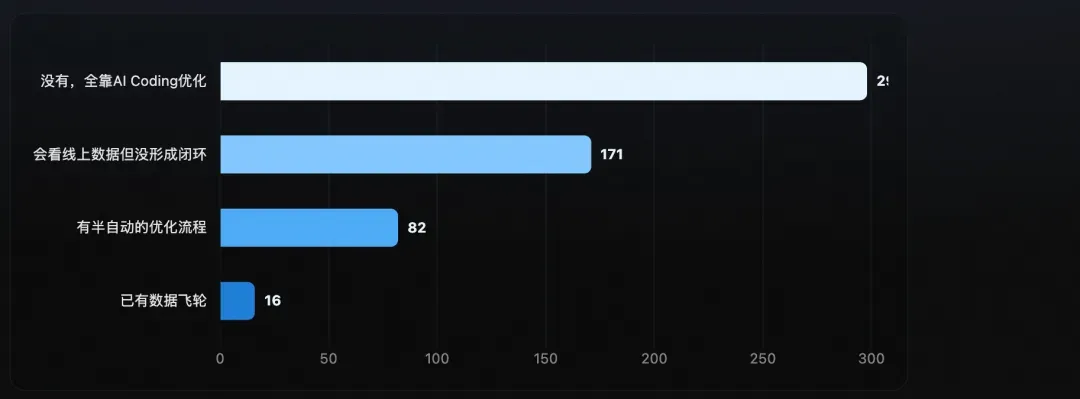
解读: 52.6% 完全没有闭环,30.2% 会看线上数据但没闭环,合计 82.8% 的优化仍停留在人工或半人工阶段。仅有 2.8% 建成数据飞轮。优化闭环是当前 Agent 工程化的最大洼地,也意味着谁能把“线上数据 → 评估 → 实验 → 回测 → 发版”串成可配置 Pipeline,谁就能占据下一轮竞争高地。
Q21:您希望通过进化,提升什么?(多选)
推理质量与 Skills 沉淀是最高优先级诉求,成本与迭代周期也高度关注。
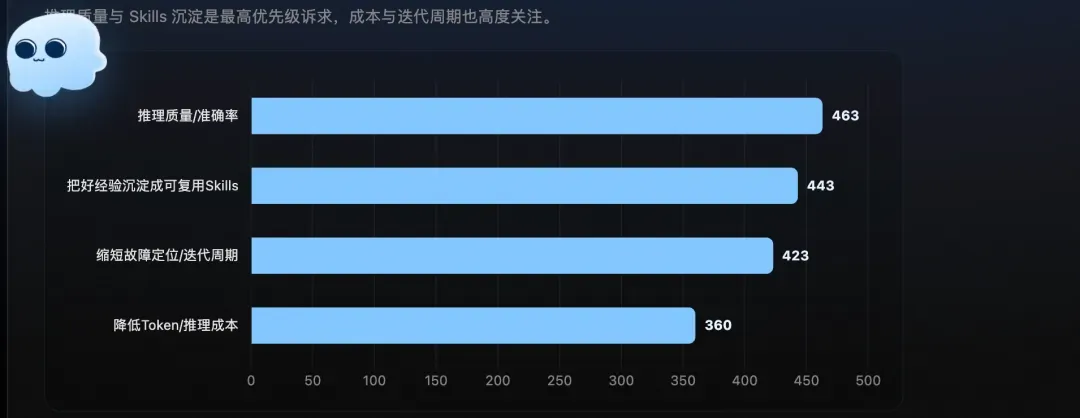
解读: 四项诉求均获得超过六成受访者选择,说明优化需求旺盛且多元。推理质量(81.7%)与 Skills 沉淀(78.1%)位居前两位,反映团队既追求单次效果提升,也追求组织能力沉淀。降低成本(63.5%)与缩短迭代周期(74.6%)同样是规模化生产的刚性诉求,与 Q20 中闭环薄弱形成供需错配。
综合判断
综合全部数据,可以把当前 Agent 市场概括为:需求强烈、基建薄弱、认知体系化不够的特点。
- 从建设阶段看: 多数团队已经跨过尝鲜期,Agent 进入真实业务场景只是时间问题。但 POC 到规模化生产之间隔着一套完整的工程化体系。
- 从观测能力看: 没有统一 trajectory,问题定位靠猜、靠日志、靠复现,直接拖累故障排查效率和迭代速度。
- 从评估能力看: 指标体系意识已经觉醒(超过七成受访者关注任务完成率、工具准确率等硬指标),但工程化评估和自动化门禁远未普及。
- 从优化能力看: 团队普遍希望把经验沉淀为 Skills、提升推理质量、缩短迭代周期,但缺少把“线上数据 → 评估 → 实验 → 回测”串起来的平台与流程。
- 从审计合规看: 这是 Agent 进入金融、医疗、政企等关键行业的硬门槛。当前有要求没落地的状态,意味着合规能力将成为下一阶段产品竞争的关键差异化点。
上海站回顾和 PPT 下载
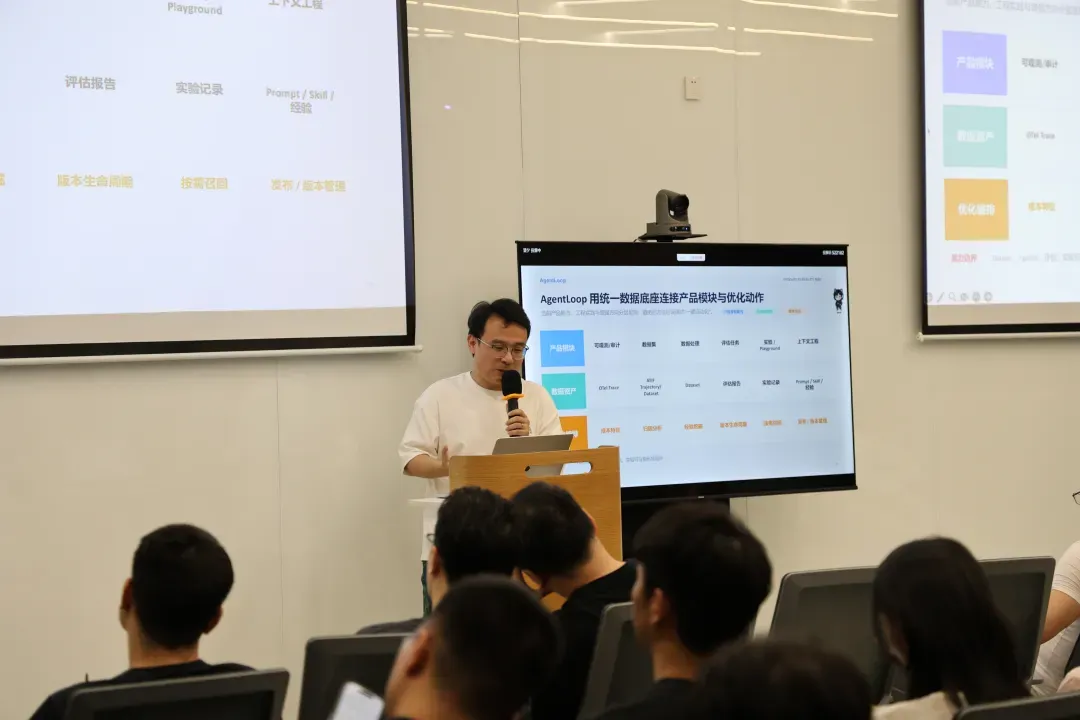
议题一:Agent 优化全链路:把每一次真实运行变成下一次改进的证据
讲师:阿里云智能 AgentLoop 研发工程师,刘航(望夕)
Agent 进入生产环境后,真正的竞争力能持续证明每一轮都变好。本议题提出一条由七个环节组成的可验证优化链路:数据接入统一 Trace 口径,观测从全局趋势下钻到异常 Step 的原始证据,数据集冻结样本让评估可复现,数据处理把原始调用链组装为可评估轨迹,评估不仅打分还要指出哪里错、为什么、谁来改,实验通过同样本 A/B 保证唯一变量,优化则在 Agent 侧与平台侧选择最小改动杠杆。贯穿全链路的是质量、效率、成本、安全四类指标,运行结果与用户反馈再回流样本池,形成持续进化的闭环。经验(Experience)也被纳入统一管理:从事实解析、模式挖掘、质量 Gate 到匹配召回与效果回写,确保每一条经验都有来源、有边界、可退出。
议题二:Skill 质量提升与资产沉淀:AI 时代的 SKU 运营实践
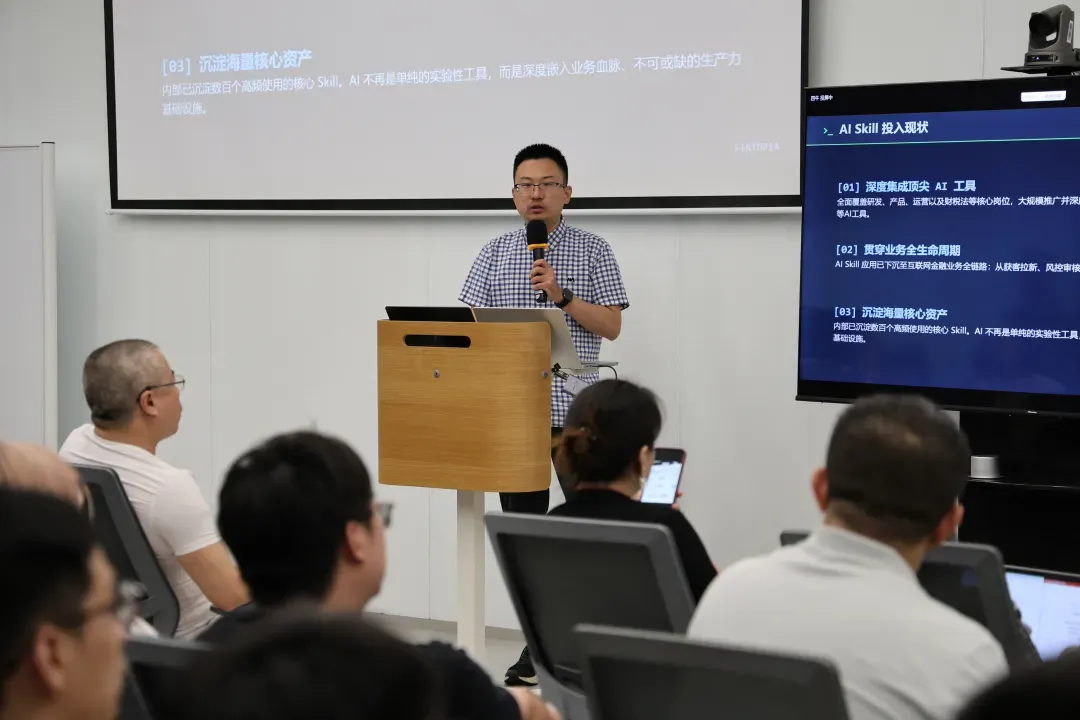
讲师:瓴岳科技研发工程师,钟雨
分享了瓴岳科技的 SkillOps 实践:把 Skill 当作可发现、可衡量、可迭代的战略资产,通过“模型广场 + MCP 广场 + Skill 广场 + Plugin 广场”四位一体的 AI 基建,让 Skill 在团队间流转。Skill 生命周期被拆解为发现、创建、发布、数据采集与加工、评测、迭代六个阶段:发现阶段优先复用已有 Skill;创建阶段一键生成 Prompt、配置、测试与文档;发布阶段通过 Git 仓库自动上架;采集阶段借助 AgentLoop 的 Loongsuite 采集器在用户无感的情况下捕获调用数据并做 Skill 归因;评测阶段基于真实数据集做 with_skill / without_skill 离线实验,从功能正确性、能力增益、Token 成本三个维度量化效果;迭代阶段针对失败集中场景进行预标注与人工审阅,生成高可信数据集后优化下一版本。
使用者零门槛复用,开发者拥有真实数据仪表盘,管理者则将散落工具沉淀为企业级核心 AI 资产库。
议题三:LangChain Agent Engineering:从原型到生产的 ADLC 实践
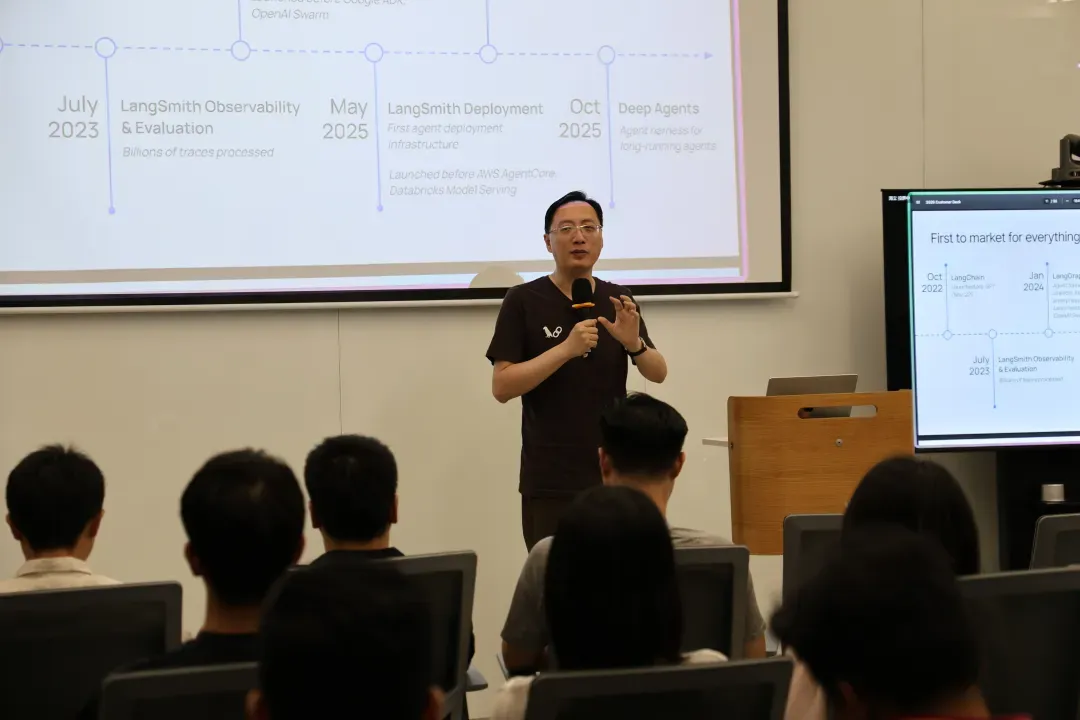
讲师:LangChain Ambassador,张海立
Agent 是一种新的软件工程问题:非确定性输出、行为不可见、传统测试无法衡量质量、长任务基础设施不足。Agent Engineering 就是把这种非确定性系统迭代为可靠体验的学科,核心生命周期是 Build → Observe → Evaluate → Deploy。LangSmith 作为 Agent Engineering Platform,向下连接 LangGraph 运行时、LangChain 框架与 Deep Agents harness,向上提供可观测、评估、部署与无代码构建能力。
与传统 APM 不同,Agent 可观测性以 Trace 为 truth source,需要捕获 prompt-response 对、多轮上下文、工具调用与推理步骤;Insights Agent 可自动发现使用模式与错误模式,在线评估可持续监控质量、安全与格式合规。评估侧支持离线数据集回归、LLM-as-judge、人工标注队列以及 Playground 中的 prompt A/B 测试;部署侧提供一键发布、Agent Registry、Assistants API 和 LangSmith Studio。整套栈保持模型、工具与数据库的开放中立,避免厂商锁定,让企业可以在不同基础设施间灵活替换。
动手实操
基于 AgentLoop 跑通 Qoder + PawBench 评估与优化闭环
AgentLoop 研发工程师黄小龙(易星尘)带领大家基于 Qoder 和 PawBench 体验“Coding Agent 执行 → Trace 采集 → 数据集加工 → Agent 评估”的完整链路。
实操以 PawBench 的 T036、T063 两题为固定样本,先跑 baseline 再注入 fact_extraction_exactness 经验跑 experience,通过 Loongsuite Pilot 把 Qoder 轨迹上报到 AgentLoop;随后创建基于 PawBench GT 准确率的 Agent 评估器,并通过 Pipeline 把 GT、input、output 与完整 agent_trajectory 组合为评估 Dataset,最终在 AgentLoop 产品页面完成批量评估,对比经验注入前后的效果差异。
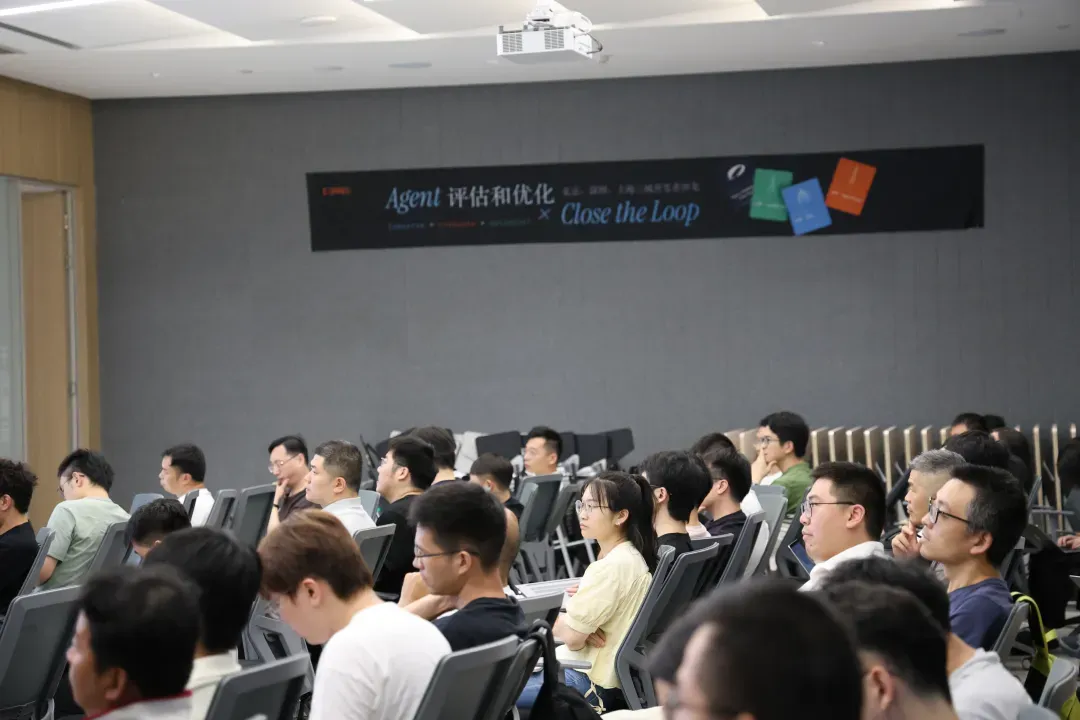
现场精彩瞬间
北京站和深圳站 PPT 下载
北京站 PPT 下载:
关注「阿里云云原生」公众号,后台回复:Loop0821
免费获得北京站讲师 PPT 合辑
深圳站 PPT 下载:
关注「阿里云云原生」公众号,后台回复:0831
免费获得深圳站讲师 PPT 合辑