引言
日前,2026 年 VLDB 会议在美国波士顿召开。阿里云 PolarDB-IMCI 团队联合清华大学、上海交通大学提出了在线自适应查询分流框架 AQD(Online Adaptive Query Dispatcher)。相关论文《AQD: Online Adaptive Query Dispatcher for HTAP Databases》被 VLDB 2026 收录。
AQD解决了以 PolarDB-IMCI 为代表的行列混合架构中一个关键问题:当一条 SQL 到来时,系统应该将它分发到行存引擎,还是列存引擎?这个决策会直接影响查询延迟、系统吞吐和资源利用率。
传统方法通常依赖优化器估计代价和固定阈值进行判断:代价超过阈值则走列存,否则留在行存。这种方法实现简单、开销较低,但在实际负载中容易受到查询模式变化、统计信息误差、并发压力和资源状态波动的影响,难以持续保持最优分流效果。
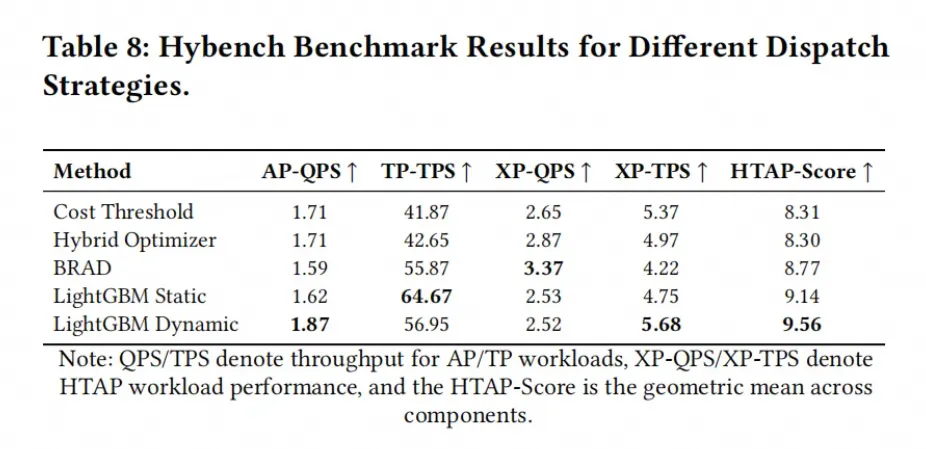
AQD 则是在优化器已有信息的基础上,结合查询计划特征、真实执行反馈和运行时资源状态,动态判断查询更适合由行存还是列存执行。论文实验显示,相比传统基于代价阈值的分流策略,AQD 在高并发场景下可将平均查询延迟降低 90% 以上,并在 HyBench 测试中取得 9.56 的综合得分,相比代价阈值方法提升 15%,相比SOTA方法 BRAD(2024年VLDB论文方法) 提升 9%。
核心结论:在真实 HTAP 场景中,行列分流不仅需要判断单条查询在哪个引擎上更快,也需要持续感知负载变化和行列引擎之间的资源状态,来实现更优性能的查询分流。
AQD 总体架构:从查询级判断到负载级调节
在离线阶段,AQD 从 PolarDB-IMCI 的 MySQL 优化器中提取查询计划特征,收集查询在行存和列存两侧的真实执行延迟,并训练 LightGBM 模型学习查询级分流规律。该模型用于给出基础分流判断:从查询计划特征来看,这条 SQL 更可能适合由行存还是列存执行。但离线模型并不能完全覆盖真实系统中的动态变化。因此AQD 会持续接收真实执行反馈,对离线模型进行轻量级残差修正,结合负载迁移情况和资源利用情况对最终分流结果进行动态调节。AQD 在保持用户透明性的同时,将离线学习、在线纠偏和资源感知调节嵌入到 PolarDB-IMCI 的查询路由链路中,特征提取和模型推理合计仅带来约 500 微秒的单查询开销。
离线学习:构建查询级分流基线
AQD 首先通过离线训练建立查询级分流基线。也就是说,在不考虑线上负载波动和资源竞争的情况下,系统先学习一条 SQL 从查询计划本身来看,更适合由行存还是列存执行。
为了刻画查询本身的执行特征,AQD 从 PolarDB-IMCI 的 MySQL 优化器中提取查询计划信息,如数据规模、索引使用情况、选择率、Join 结构复杂度,以及是否包含聚合或大范围扫描等。
AQD 通过 SHAP 特征分析方法从一百余个特征中筛选出 32 个关键特征,在降低特征维度的同时保持预测效果。
AQD 通过将同一条查询分别在行存和列存引擎上执行,并记录两侧真实延迟,获得大量训练数据。基于查询计划特征和真实执行延迟,AQD 训练一种梯度决策树 LightGBM 模型作为查询级分流模型,输出一个连续分数st,其符号表示更倾向于哪一侧引擎,绝对值反映模型判断的置信度。
在线学习:基于执行反馈修正分流偏差
在真实 HTAP 系统中,最优分流决策会受到负载变化、数据分布变化、并发压力和机器状态波动的影响。因此,AQD 在离线模型之外进一步引入在线学习机制,根据真实执行反馈持续修正分流策略。
AQD 将 LightGBM 的基线分数与在线修正项合并,得到新的性能分数。这样,LightGBM 负责提供稳定的查询级初始判断,LinTS-Delta 负责根据线上反馈对该判断进行轻量修正,使 AQD 能够在保持低开销的同时适应动态负载。
根据 CPU/内存状态调节资源均衡
AQD 在性能分数之外进一步引入资源调节机制,会持续监控行存和列存两侧的 CPU、内存使用情况,并将当前资源状态与目标资源状态进行比较。如果行存引擎的资源使用已经高于目标水平,系统会适当提高后续查询分发到列存的倾向;如果行存引擎资源使用低于目标水平,则可以适当增加行存侧的查询分流比例。最终,AQD 将性能分数与资源调节分数融合,得到最终分流分数。通过这一资源调节机制,AQD 将行列分流从单条查询的性能判断扩展到系统层面的负载调节。它不仅关注“这条查询在哪个引擎上更快”,也关注“当前系统是否适合继续把查询分发到该引擎”。
实验结果
论文从查询级预测、在线负载漂移、并发执行和 HyBench 综合指标等维度对 AQD 进行了评估。实验配置和数据规模详见论文原文第五章。整体结果表明,AQD 的收益主要来自三方面:更准确的单查询分流判断、更强的动态负载适应能力,以及更好的 HTAP 整体性能。
首先,离线 LightGBM 模型能够更准确地识别一条查询适合行存还是列存。在 15 个数据集的单数据集测试中,LightGBM 在 14 个数据集上取得最低平均延迟;在跨数据集测试中,模型也保持了较好的泛化能力。这说明 AQD 学到的不是某个固定数据集上的规则,而是查询计划特征与行列执行性能之间更稳定的关系。相比传统代价阈值方法,AQD 尤其能够改善那些容易被固定阈值误判的“困难查询”。
其次,在线 AQD 在负载变化和高并发场景下表现更稳定。论文设计了多阶段 workload drift 实验,覆盖 OLAP 饱和、OLTP 突发、TP/AP 比例变化、数据规模漂移、混合竞争和内存压力等场景,用来模拟真实 HTAP 系统中的负载波动。实验结果显示,LightGBM Dynamic 在不同阶段都能保持较低延迟,相比代价阈值、Hybrid Optimizer 和 BRAD 等方法更稳定。在 200 到 1000 并发查询的实验中,LightGBM Dynamic 相比传统代价阈值方法将平均查询延迟降低 90% 以上,整体完成时间(makespan)也明显下降。这说明在线残差学习和资源调节能够有效缓解高并发下错误分流被排队效应放大的问题。
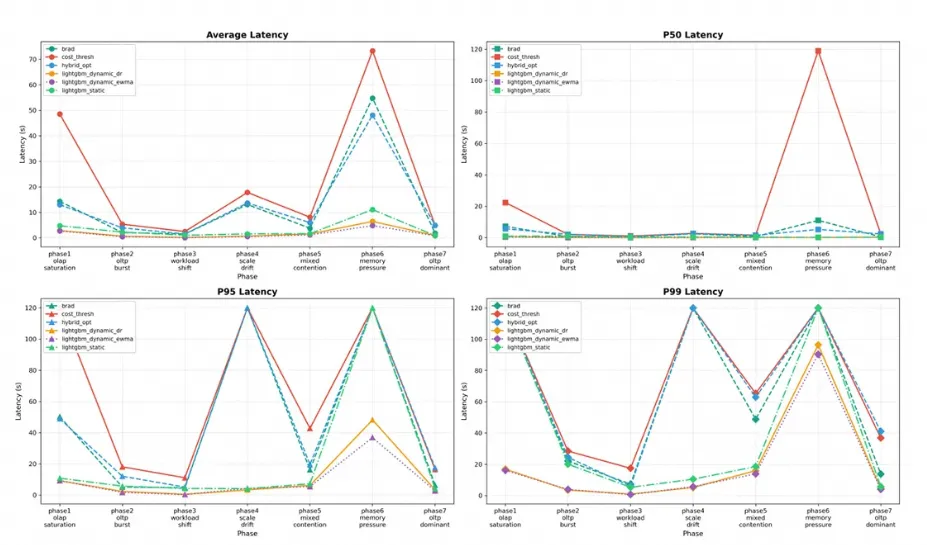
最后,AQD 在 HyBench 综合测试中取得了更好的整体表现。LightGBM Dynamic 的 HTAP-Score 达到 9.56,高于代价阈值方法的 8.31,也高于代表性方法 BRAD 的 8.77。这表明 AQD 并不是只优化某一类查询,而是在 TP、AP 和混合负载之间取得了更好的平衡。总体来看,离线学习提升了查询级判断准确性,在线纠偏增强了负载适应能力,资源调节则避免行存或列存一侧长期过载,三者共同带来了 AQD 在动态 HTAP 场景下的性能收益。
总结
AQD 面向双引擎 HTAP 数据库中的行列分流问题,提出了一种结合离线学习、在线反馈和资源感知调节的自适应查询分流框架。实验结果表明,AQD 在查询级预测、负载漂移和 HyBench 综合指标上均取得了较好的效果。相比传统代价阈值分流策略,AQD 在高并发场景下显著降低了平均查询延迟和整体执行时间,并在 HyBench 上取得更高的 HTAP-Score。这说明,在真实 HTAP 场景中,行列分流不仅需要判断单条查询在哪个引擎上更快,也需要持续感知负载变化和行列引擎之间的资源状态。AQD 的思路不仅适用于 PolarDB-IMCI,也为更多双引擎 HTAP 数据库系统中的智能查询调度提供了参考。