一、前言
我记得刚开始学习大模型开发时,会陷入了一个误区:拼命钻研提示词技巧,却忽略了最核心的底层逻辑。也总觉得大模型回答不准、容易失忆、长篇对话跑偏、复杂任务翻车,是Prompt写得不够好,后来才发现,绝大多数情况,问题根本不在“怎么提问”,而在“给模型看什么、怎么管理信息”。
同样的模型、同样的问题,有人实现流畅连贯的超长对话、精准的知识库问答、稳定的智能体任务,有人却频繁出现上下文溢出、信息丢失、逻辑混乱。核心差距就在于是否掌握上下文工程。如果说提示词工程是教模型“怎么做事”,那上下文工程就是管控模型的“全部信息输入与记忆体系”,是大模型落地应用的底层基石。不同于零散的调参、改提示词,上下文工程是一套系统化、可落地、可复用的方法论,核心围绕窗口管理、消息编排、记忆压缩、检索增强四大核心策略展开。不管是做AI对话机器人、企业知识库问答,还是智能体自动化任务,这套体系都是刚需。
二、读懂上下文工程
1. 核心定义与价值
1.1 上下文工程核心定义
一套系统性设计、调度、优化大模型推理阶段全部信息状态的工程方法论,核心目标是在模型有限的Token预算内,最大化信息利用率,保障模型输出精准、稳定、高效。简单来说,就是大模型的“信息管家”和“内存管理器”。
1.2 与提示词工程的区别
接触的不深很容易会混淆提示词工程和上下文工程,这里做一个通俗的区分,帮大家彻底理清边界:
- 提示词工程聚焦单次对话的指令优化,解决的是“这句话怎么写模型才懂”的问题,偏向单点、静态的优化;
- 上下文工程聚焦整场对话、全量输入信息的生命周期管理,解决的是“海量信息怎么筛选、排序、压缩、加载”的问题,是全局、动态的系统优化。
1.3 无上下文工程的痛点
在大模型实际落地中,模型的所有认知、推理、回答,完全依赖输入的上下文信息。模型本身没有独立长期记忆,不会主动筛选有效信息,也无法自主规避冗余、冲突内容。如果没有上下文工程的管控,随着对话变长、知识库内容增多,必然会出现三大核心问题:
- 上下文窗口溢出:超出模型Token上限,直接截断内容,导致关键信息丢失;
- 信息冗余干扰:大量无效对话、重复内容占用窗口,稀释有效信息,让模型判断失误;
- 关键信息遗忘:长篇对话中早期核心内容被后置信息覆盖,模型出现前后回答矛盾、逻辑断裂问题。
1.4 上下文工程核心价值
它不再靠人工微调Prompt碰运气,而是用标准化策略,实现上下文信息的有序流转、高效利用,让大模型在超长对话、复杂问答、智能体任务中,始终保持稳定、精准的输出效果,这也是企业级大模型应用和个人简单应用的核心区别。
2. 核心技术体系框架
上下文工程不是单一技术,而是一套完整的技术体系,全程围绕四大核心模块闭环运转,覆盖上下文信息从加载、整理、优化到复用的全生命周期,各模块能力分工清晰、层层递进:
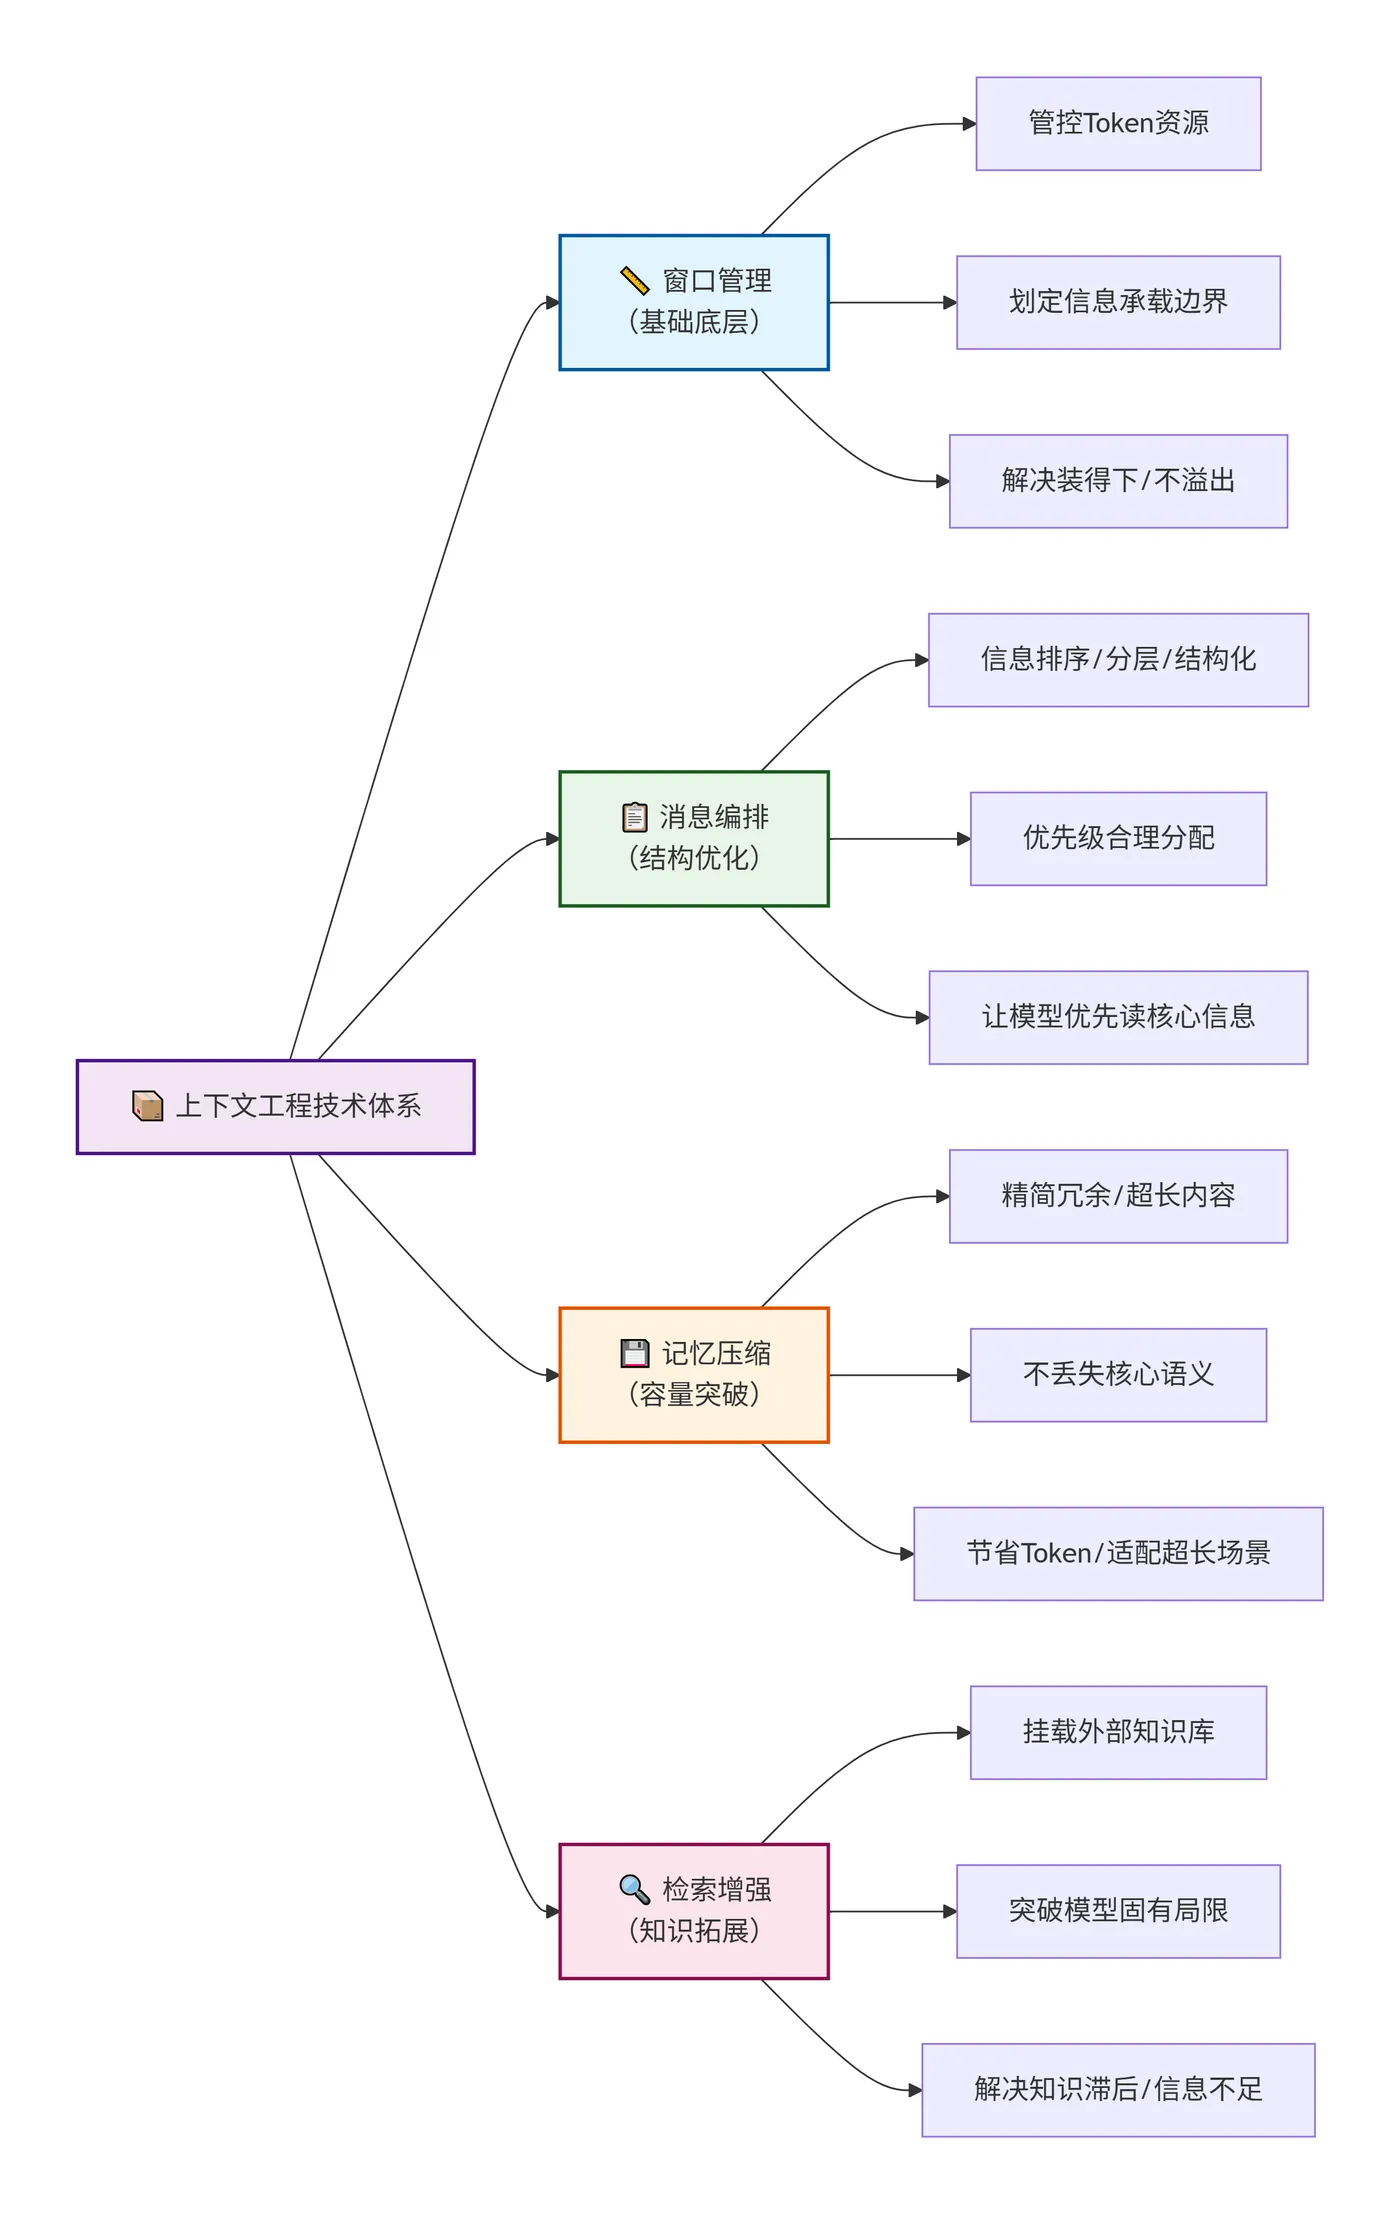
- 上下文窗口管理(基础底层):核心职责是管控模型的Token资源,划定信息承载边界,解决“装得下、不溢出”的问题,是所有上下文优化的前提,所有后续策略都必须基于窗口规则展开。
- 消息编排策略(结构优化):聚焦信息结构优化,在窗口容量范围内,对对话消息、指令、知识内容进行排序、分层、结构化整理,解决“信息有序、优先级合理”的问题,让模型优先读取核心有效信息。
- 记忆压缩技术(容量突破):针对超长文本、冗余对话,在不丢失核心语义的前提下精简内容,解决“信息太多、承载不足”的问题,高效节省Token资源,适配超长交互场景。
- 检索增强策略(知识拓展):突破模型固有知识和对话记忆的局限,动态挂载外部知识库信息,解决“信息不足、知识滞后”的问题,让模型具备实时、专业的知识输出能力。
四大模块构成上下文工程完整骨架,初学者无需死记硬背,只需牢记核心落地逻辑:先管容量、再理结构、再做精简、最后补全知识。
三、上下文窗口管理
1. 窗口核心原理
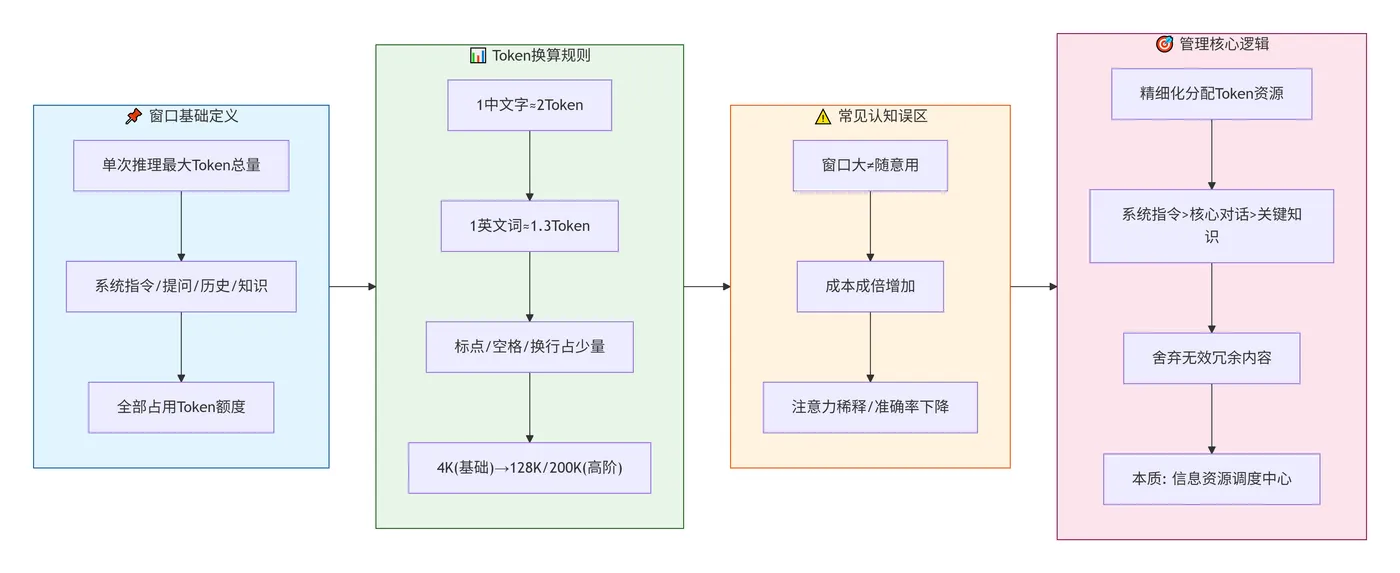
上下文窗口基础定义:
- 大模型的上下文窗口,本质是模型单次推理能够接收的最大Token总量;
- 所有输入的系统指令、用户提问、历史对话、外部知识,全部都会占用Token额度,是模型接收信息的唯一载体。
Token通俗换算规则:
- 通用换算标准:1个中文汉字约等于2个Token,1个英文单词约等于1.3个Token,标点符号、空格、换行都会占用少量Token。
- 主流模型窗口差异极大,基础模型3.5仅4K窗口,仅能承载数千字内容,高阶模型支持128K、200K超大窗口,可直接加载整本书、完整文档。
常见认知误区:
很多人认为超大窗口可随意使用,无需管理上下文,这是致命错误。工程落地中,窗口大小绝不等于可用容量:
- 窗口越大,模型推理成本越高、响应速度越慢,算力资源消耗成倍增加;
- 超大窗口塞满冗余信息后,会出现注意力稀释问题,模型无法精准抓取关键信息,回答准确率大幅下降。
窗口管理核心逻辑
- 窗口管理的核心从来不是“填满窗口”,而是精细化分配Token资源。
- 将有限的窗口额度优先分配给系统指令、核心对话、关键知识,主动舍弃无效冗余内容;
- 实现Token利用率最大化,本质是大模型信息的“资源调度中心”。
2. 主流窗口管理策略
在应用实践中,四类主流窗口管理策略由简到繁、适配不同业务场景:
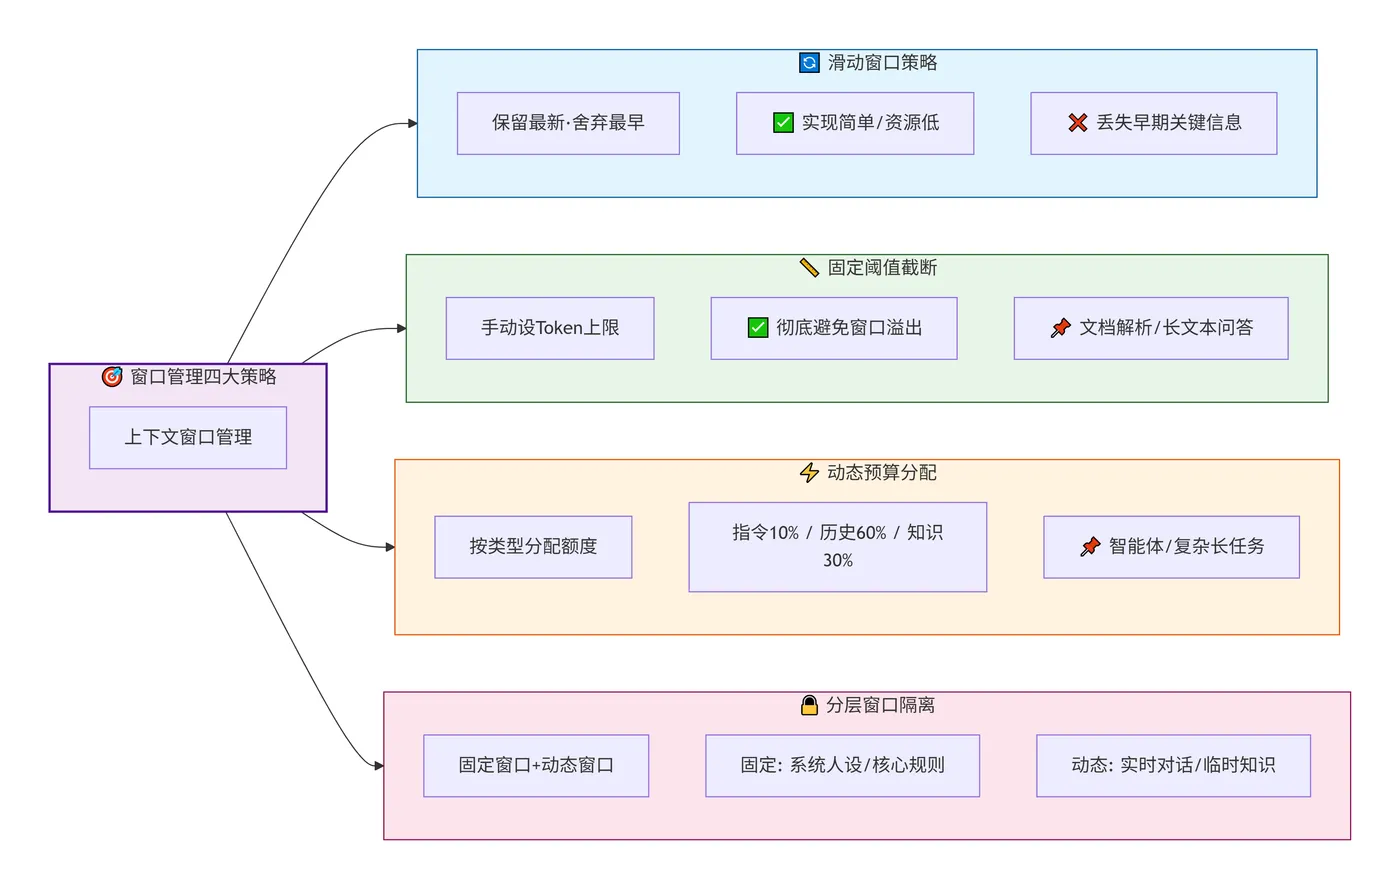
滑动窗口策略(基础通用):
- 核心逻辑为“保留最新、舍弃最早”,通过设定固定消息条数或Token阈值,超出上限时自动删除早期历史对话,仅保留近期交互。
- 优势是实现简单、资源消耗低,适配日常聊天、简单问答;
- 缺点是会丢失早期关键信息,不适合长期关联的复杂任务。
固定阈值截断策略(精准控容):
- 手动设置Token上限阈值,实时监测上下文总Token量,超限时自动截断头部或尾部内容。
- 相比滑动窗口管控更精准,可彻底避免窗口溢出报错,适合文档解析、长文本问答等固定场景。
- 实操需优先截断闲聊内容,保留核心业务信息。
动态预算分配策略(企业级核心):
- 对不同类型上下文分配固定Token额度,互不抢占资源,例如系统指令占10%、历史对话占60%、检索知识占30%。
- 可彻底解决信息优先级混乱问题,保障核心指令和关键知识始终有充足窗口空间,适配智能体、复杂业务问答、多轮长任务场景。
分层窗口隔离策略(定制化必备):
- 将窗口分为固定窗口和动态窗口,固定窗口永久留存系统人设、核心规则、业务底线等关键信息,绝不被截断;
- 动态窗口承载实时对话、临时知识,可自由删减更新。
- 完美解决“核心规则被覆盖、后期对话跑偏”问题,多用于定制化AI助手、企业专属问答系统。
3. 示例:窗口管理策略实践
示例演示滑动窗口上下文管理:先按中文2Token/字、英文1.3Token/词估算每条消息开销,再从最新消息往前累计裁剪——保留system指令和近期对话轮次,超出上限的早期历史自动丢弃,确保多轮对话在有限的LLM上下文窗口内稳定运行。
import math
# 简易模拟Token计算(中文2Token/字,英文1.3Token/词)
def calc_token_count(text: str) -> int:
    cn_chars = len([c for c in text if '\u4e00' <= c <= '\u9fff'])
    en_words = len(text.split()) - cn_chars
    return math.ceil(cn_chars * 2 + en_words * 1.3)
# 滑动窗口上下文裁剪:保留最新N轮对话,控制总Token不超限
def slide_window_clip(messages: list, max_token: int = 2048) -> list:
    """
    messages: 对话消息列表 [{"role":"user","content":""}, ...]
    max_token: 上下文窗口最大Token上限
    """
    total_token = 0
    # 从后往前遍历,保留最新对话
    new_messages = []
    for msg in reversed(messages):
        token = calc_token_count(msg["content"])
        if total_token + token <= max_token:
            new_messages.append(msg)
            total_token += token
        else:
            break
    # 恢复正序
    return list(reversed(new_messages))
# 测试用例
if __name__ == "__main__":
    test_msgs = [
        {"role": "system", "content": "你是专业的AI助手,回答简洁精准。"},
        {"role": "user", "content": "讲解什么是上下文工程?"},
        {"role": "assistant", "content": "上下文工程是大模型信息系统化管理方法论。"},
        {"role": "user", "content": "窗口管理有哪些策略?"}
    ]
    max_tok = 1500
    print(f"上下文窗口上限:{max_tok} Token\n")
    # 第1步:逐条估算 Token
    print("--- 第1步:逐条估算 Token ---")
    for i, msg in enumerate(test_msgs):
        tok = calc_token_count(msg["content"])
        print(f"  消息{i}: [{msg['role']}] {msg['content'][:30]}... -> {tok} Token")
    print("  [说明] 中文按2 Token/字、英文按1.3 Token/词估算,模拟真实tokenizer行为")
    # 第2步:滑动窗口裁剪
    print(f"\n--- 第2步:从后往前滑动窗口裁剪(上限={max_tok})---")
    total = 0
    kept = []
    for msg in reversed(test_msgs):
        tok = calc_token_count(msg["content"])
        if total + tok <= max_tok:
            kept.append(msg)
            total += tok
            print(f"  保留[{msg['role']}]: {msg['content'][:30]}... ({tok} Token) -> 累计 {total}/{max_tok}")
        else:
            print(f"  丢弃[{msg['role']}]: {msg['content'][:30]}... ({tok} Token) -> 超限,停止")
            break
    print("  [说明] 从最新消息往前保留,优先保留近期对话,超出上限的历史消息被裁切")
    print(f"\n最终保留 {len(kept)}/{len(test_msgs)} 条消息,总 Token={total}")
    print("  [说明] 保留system指令+最近几轮对话,丢弃早期历史,保证窗口不超限")

输出结果:
上下文窗口上限:1500 Token
--- 第1步:逐条估算 Token ---
消息0: [system] 你是专业的AI助手,回答简洁精准。... -> 11 Token
消息1: [user] 讲解什么是上下文工程?... -> 9 Token
消息2: [assistant] 上下文工程是大模型信息系统化管理方法论。... -> 15 Token
消息3: [user] 窗口管理有哪些策略?... -> 8 Token
[说明] 中文按2 Token/字、英文按1.3 Token/词估算,模拟真实tokenizer行为
--- 第2步:从后往前滑动窗口裁剪(上限=1500)---
保留[user]: 窗口管理有哪些策略?... (8 Token) -> 累计 8/1500
保留[assistant]: 上下文工程是大模型信息系统化管理方法论。... (15 Token) -> 累计 23/1500
保留[user]: 讲解什么是上下文工程?... (9 Token) -> 累计 32/1500
保留[system]: 你是专业的AI助手,回答简洁精准。... (11 Token) -> 累计 43/1500
[说明] 从最新消息往前保留,优先保留近期对话,超出上限的历史消息被裁切
最终保留 4/4 条消息,总 Token=43
[说明] 保留system指令+最近几轮对话,丢弃早期历史,保证窗口不超限
四、消息编排策略
1. 编排核心逻辑
1.1 消息编排的本质
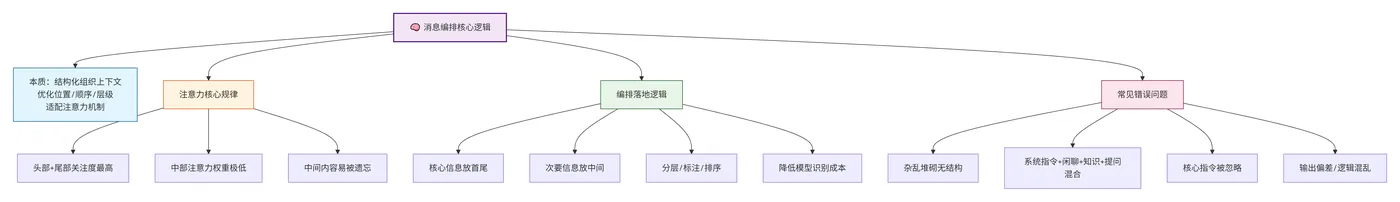
了解窗口容量后,消息编排是提升模型回答精度的关键。其本质是结构化组织上下文信息,优化信息位置、顺序、层级,适配大模型专属的注意力机制,让有限窗口内的信息发挥最大价值。
1.2 大模型注意力核心规律
核心特性:模型对上下文头部信息和尾部信息关注度最高,中间内容注意力权重极低,极易被忽略。简单来说,首尾内容会被重点读取,中间内容大概率被遗忘。
1.3 编排核心落地逻辑
基于注意力规律,形成固定编排思路:将最高优先级的核心信息放在首尾,次要辅助信息放置中间,同时对杂乱消息分层、标注、排序,降低模型信息识别成本。如果说窗口管理是管控“容量”,消息编排就是优化“结构”。
1.4 常见错误问题
常见错误会杂乱堆砌消息,将系统指令、历史闲聊、业务知识、用户提问混为一体,无结构、无顺序,导致模型注意力被无效内容分散,核心指令和关键知识被忽略,最终输出结果偏差、逻辑混乱。标准化编排可彻底规避此类问题。
2. 落地编排技巧
根据经验总结整理了可直接落地、高性价比的消息编排技巧,覆盖绝大多数大模型应用场景,简单易操作、优化效果显著:
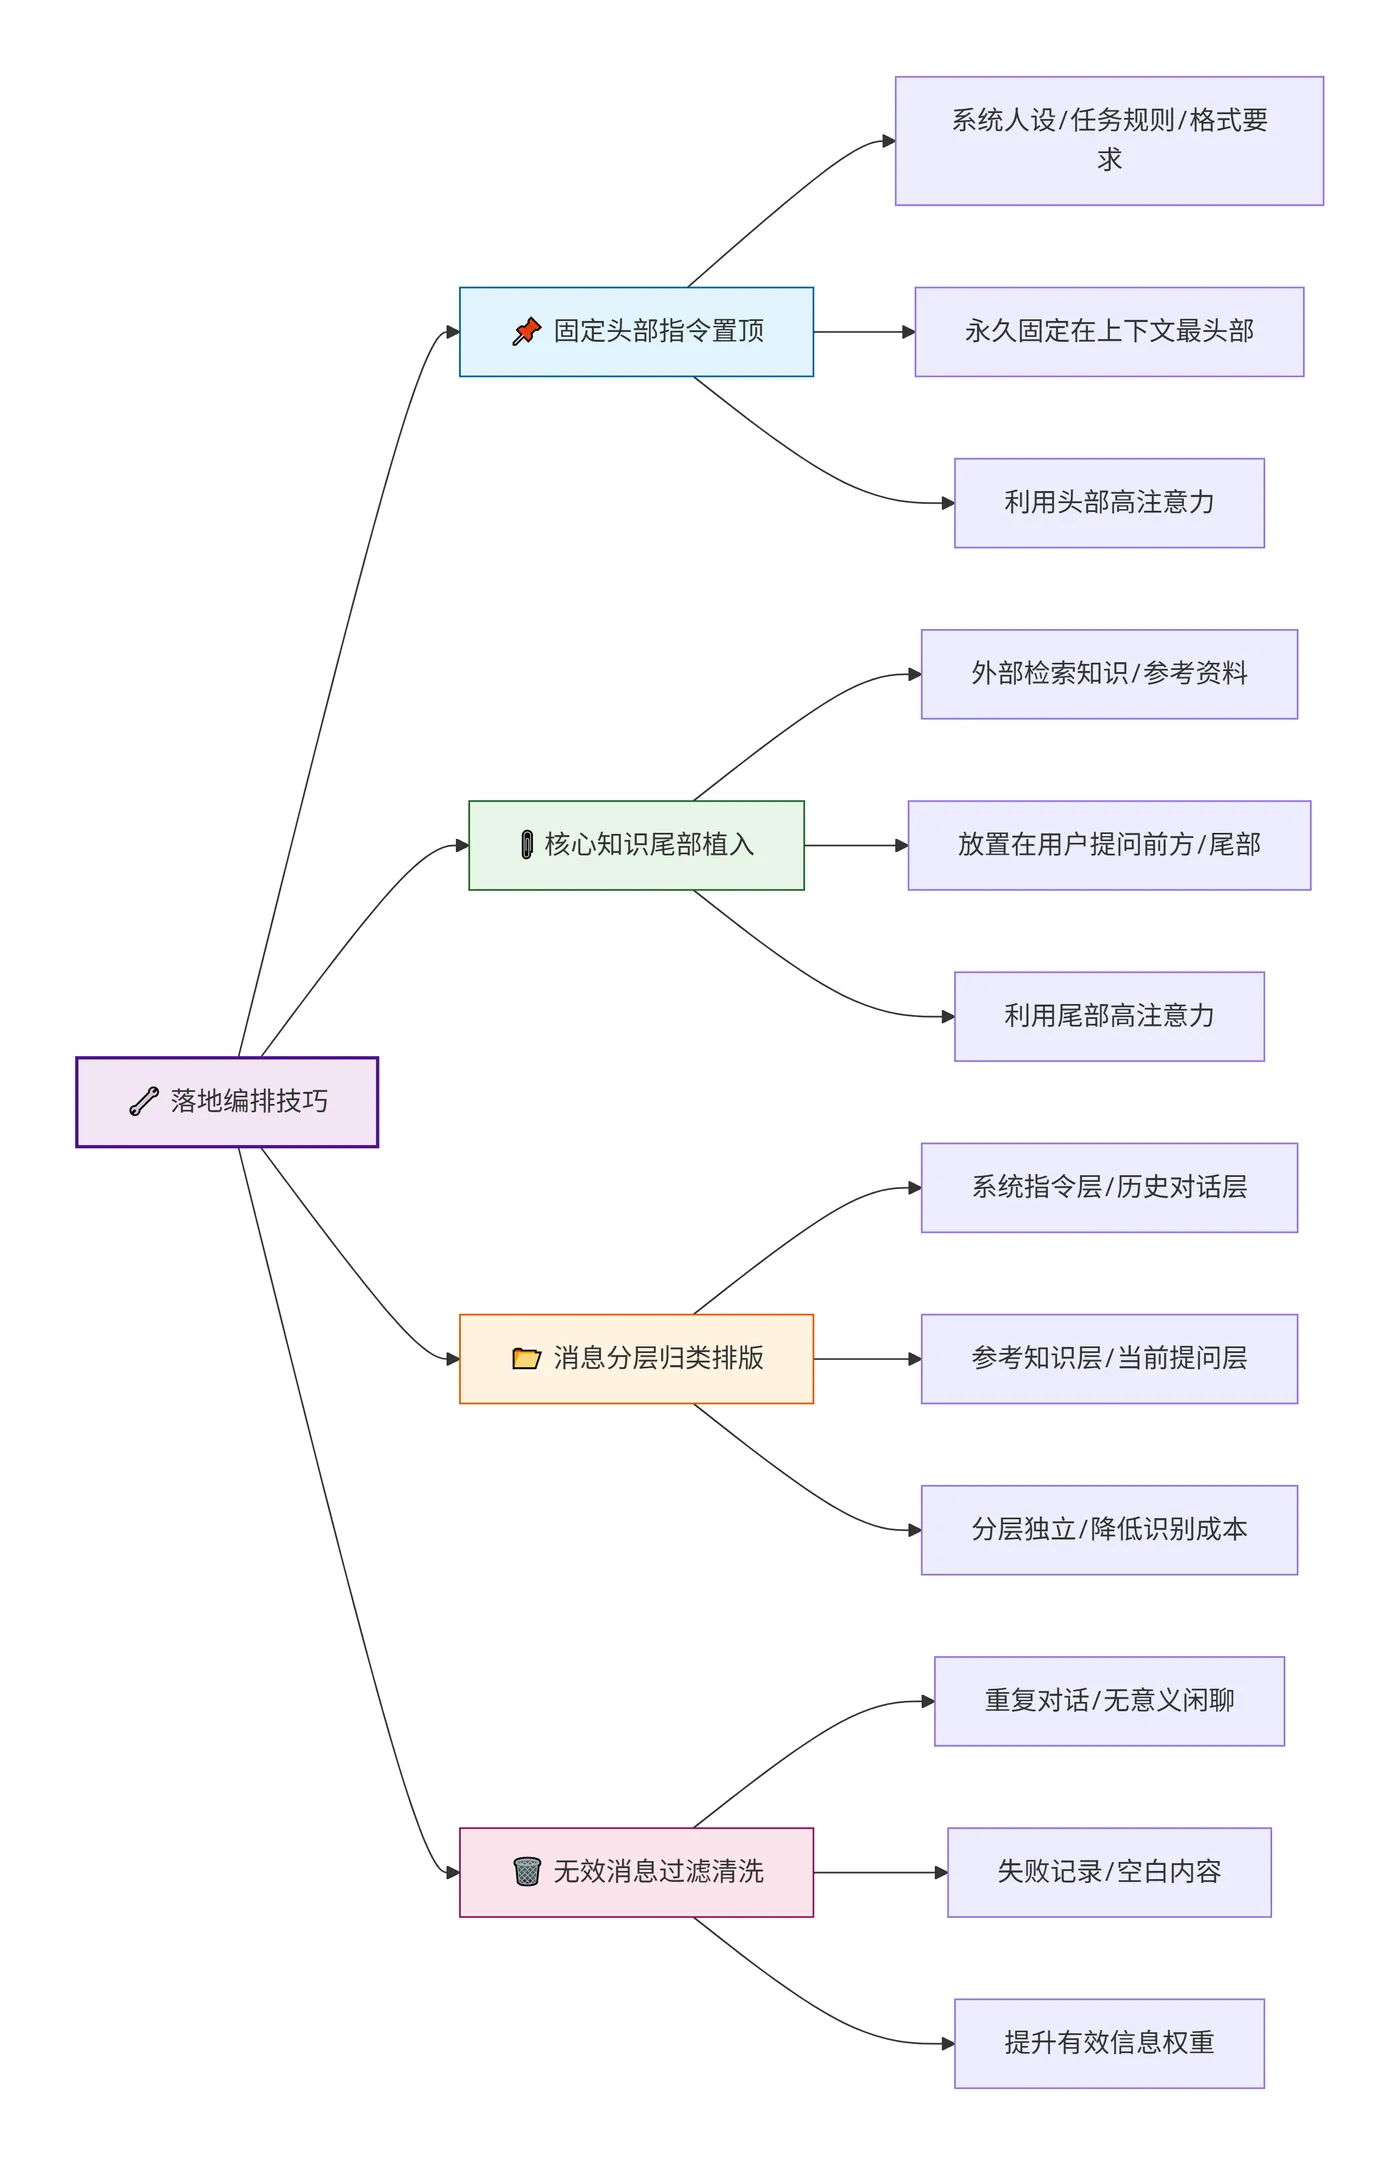
- 固定头部指令置顶:将系统人设、任务规则、输出格式、禁忌要求等核心指令,永久固定在上下文最头部,不随对话更新变动。依托头部高注意力特性,保证模型全程遵守规则,杜绝后期对话跑偏、格式混乱,是所有编排策略的基础。
- 核心知识尾部植入:将本次问答对应的外部检索知识、专属参考资料,统一放置在用户提问前方、上下文尾部位置。利用尾部高注意力优势,让模型优先读取本次任务专属知识,结合问题精准作答,大幅提升回答专业性。
- 消息分层归类排版:摒弃杂乱堆砌,统一分为四层结构:系统指令层、历史核心对话层、参考知识层、当前用户提问层,各层级独立区分、简单标注。结构化排版能大幅降低模型识别成本,快速区分规则、历史、知识与当前任务。
- 无效消息过滤清洗:编排前优先过滤重复对话、无意义闲聊、失败交互记录、空白内容等无效信息。避免无效内容占用窗口、分散注意力,以极低操作成本提升有效信息权重,是高收益的基础优化手段。
多轮复杂对话可采用优先级排序规则,优先级排序:系统规则>核心历史对话>实时参考知识>普通闲聊内容,高优先级信息永久保留、优先展示,低优先级信息按需删减,保障上下文全程有效。
3. 示例:标准化消息编排
示例演示标准化消息编排:先过滤空消息等无效历史,再按"system指令(置顶)→有效历史(居中)→参考资料(尾部植入)→用户提问(末尾)"四层结构组装上下文,利用LLM对首尾注意力偏好的特性,让关键约束和知识落在最佳信息位置。
def message_arrange(system_prompt: str, history: list, reference_text: str, query: str) -> list:
    """
    标准化消息编排
    :param system_prompt: 固定系统指令(置顶)
    :param history: 历史对话
    :param reference_text: 检索参考知识(尾部植入)
    :param query: 当前用户问题
    :return: 结构化排序后的上下文消息
    """
    # 1. 过滤无效闲聊、空消息
    valid_history = [
        msg for msg in history
        if msg["content"].strip() and len(msg["content"]) > 2
    ]
    # 2. 固定层级:系统指令 - 有效历史 - 参考知识 - 用户提问
    messages = [{"role": "system", "content": system_prompt}]
    messages.extend(valid_history)

    # 3. 尾部植入核心参考知识
    if reference_text.strip():
        messages.append({"role": "system", "content": f"本次参考资料:{reference_text}"})

    messages.append({"role": "user", "content": query})
    return messages
# 测试
if __name__ == "__main__":
    sys_prompt = "你是大模型技术博主,用通俗语言解答技术问题。"
    history_msgs = [
        {"role": "user", "content": "什么是消息编排?"},
        {"role": "assistant", "content": "是优化上下文结构的技术。"},
        {"role": "user", "content": "  "} # 无效空消息,会自动过滤
    ]
    ref_text = "消息编排核心是利用大模型首尾注意力偏好,结构化排序信息。"
    user_query = "消息编排有哪些落地技巧?"
    print(f"原始历史消息:{len(history_msgs)} 条\n")
    # 第1步:过滤无效消息
    valid = [m for m in history_msgs if m["content"].strip() and len(m["content"]) > 2]
    print("--- 第1步:过滤无效消息 ---")
    for i, msg in enumerate(history_msgs):
        is_valid = msg["content"].strip() and len(msg["content"]) > 2
        status = "保留" if is_valid else "淘汰"
        print(f"  消息{i}: [{msg['role']}] '{msg['content']}' -> {status}")
    print(f"  过滤后:{len(valid)} 条有效历史")
    print("  [说明] 空消息和过短内容被剔除,避免干扰模型输出质量")
    # 第2步:层级编排
    final_msgs = message_arrange(sys_prompt, history_msgs, ref_text, user_query)
    print(f"\n--- 第2步:四层结构化编排 ---")
    layers = [
        ("置顶层", f"[system] {sys_prompt[:40]}..."),
        ("历史层", f"{len(valid)} 条有效对话"),
        ("知识层", f"[system] 参考资料: {ref_text[:30]}..."),
        ("提问层", f"[user] {user_query}"),
    ]
    for name, desc in layers:
        print(f"  {name}: {desc}")
    print("  [说明] 利用LLM首尾注意力偏好:system指令置顶引导行为,参考资料尾部植入加强召回,历史居中保持连贯")

输出结果:
原始历史消息:3 条
--- 第1步:过滤无效消息 ---
消息0: [user] '什么是消息编排?' -> 保留
消息1: [assistant] '是优化上下文结构的技术。' -> 保留
消息2: [user] ' ' -> 淘汰
过滤后:2 条有效历史
[说明] 空消息和过短内容被剔除,避免干扰模型输出质量
--- 第2步:四层结构化编排 ---
置顶层: [system] 你是大模型技术博主,用通俗语言解答技术问题。...
历史层: 2 条有效对话
知识层: [system] 参考资料: 消息编排核心是利用大模型首尾注意力偏好,结构化排序信息。...
提问层: [user] 消息编排有哪些落地技巧?
[说明] 利用LLM首尾注意力偏好:system指令置顶引导行为,参考资料尾部植入加强召回,历史居中保持连贯
五、记忆压缩技术
1. 压缩场景与意义
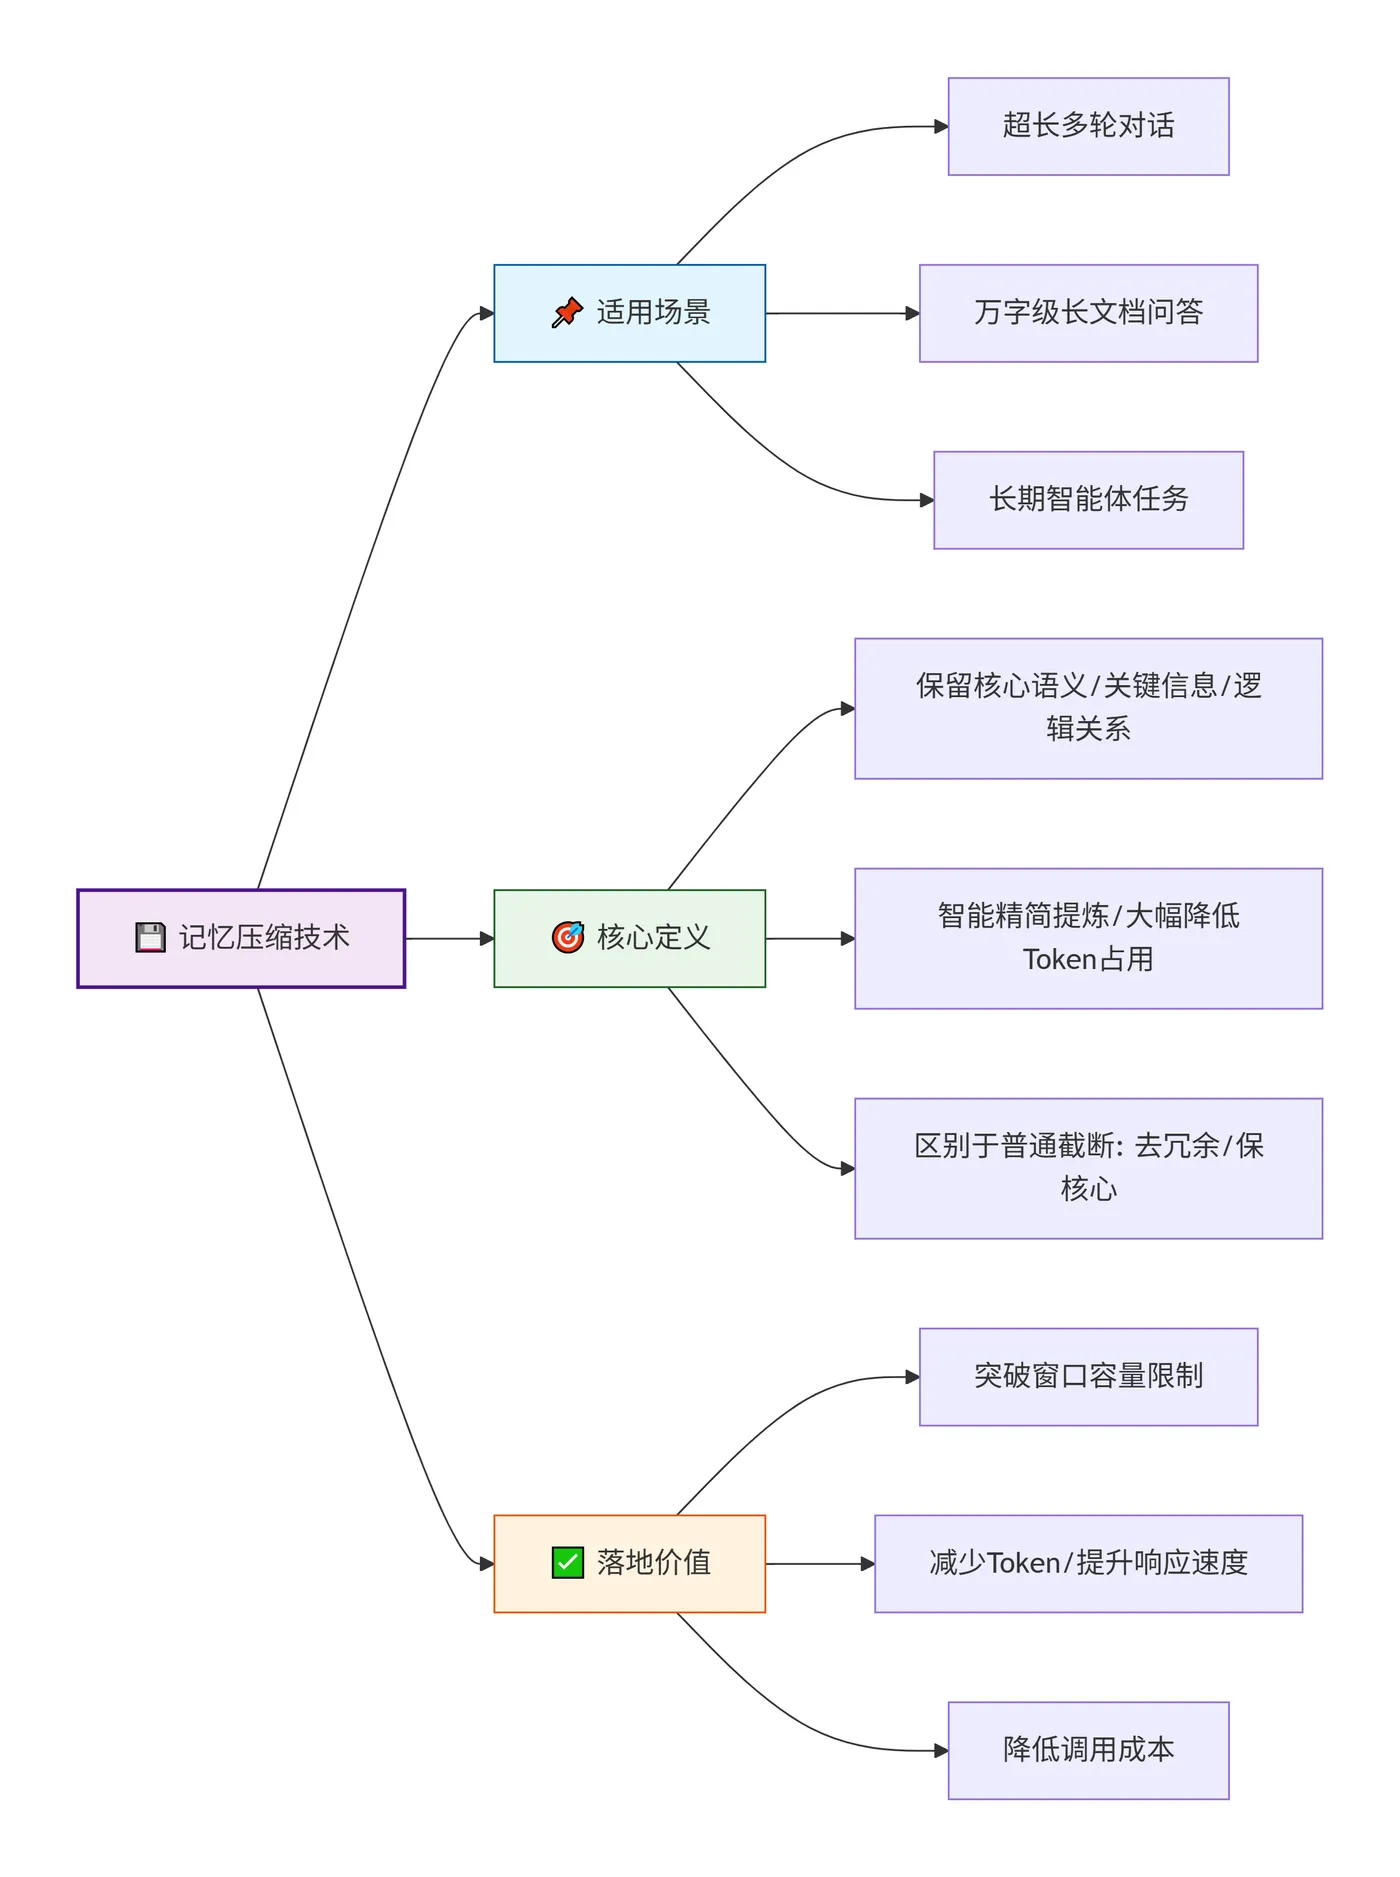
技术适用场景:
- 窗口管理、消息编排仅能解决上下文“有序、不溢出”的基础问题;
- 在超长多轮对话、万字级长文档、长期智能体任务场景中,有效信息体量过大,窗口容量无法完全承载,此时必须依靠记忆压缩技术突破容量限制。
记忆压缩核心定义:
- 记忆压缩是在完全保留核心语义、关键信息、逻辑关系的前提下,对长文本、历史对话、冗余知识进行智能精简提炼,大幅降低Token占用的优化技术。
- 它与普通文本截断有本质区别:普通删减是粗暴截段、易丢关键信息,记忆压缩是去冗余、保核心,兼顾精简性与完整性。
技术落地必要性:
- 记忆压缩是超长对话机器人、长文档问答、智能体长期任务的必备能力。
- 无压缩能力的模型应用,仅能支撑短对话、简单任务,一旦交互变长、文档篇幅增大,就会出现信息丢失、逻辑断裂、窗口溢出等问题,无法支撑企业级复杂场景。
核心落地价值:
- 突破窗口容量限制,适配超长业务场景;
- 大幅减少上下文Token数量,降低模型推理计算量,有效提升接口响应速度;
- 同时减少大模型调用成本,兼顾用户体验与业务成本。
2. 主流压缩实践策略
实际应用中主流记忆压缩策略分为轻量、中阶、高阶三个等级,适配不同精度与场景需求,可循序渐进落地:
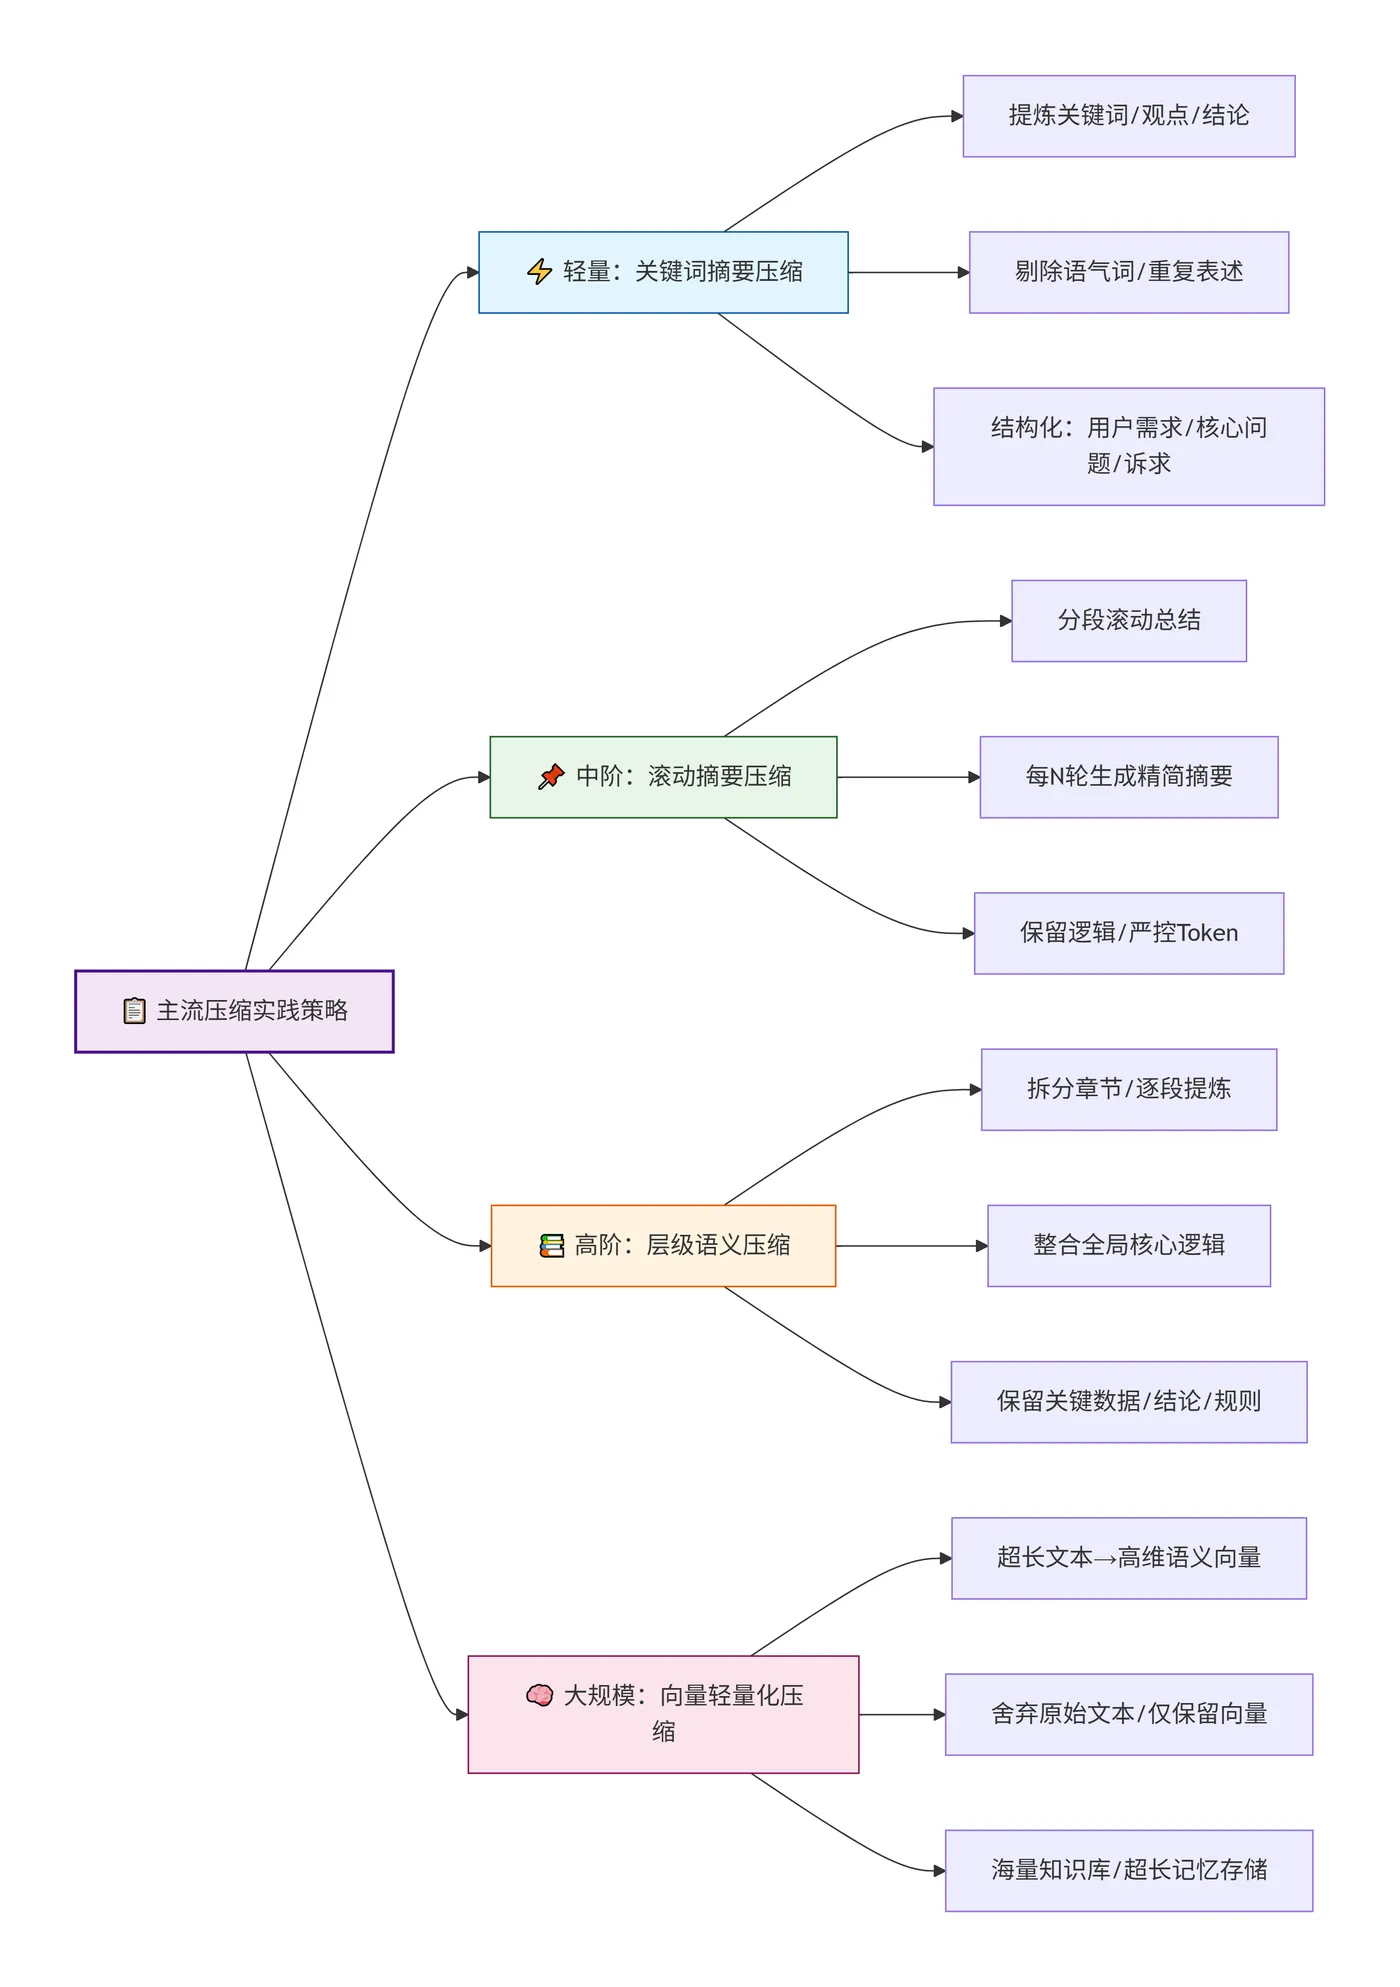
关键词摘要压缩(轻量通用):
- 适配日常对话、短文本精简,核心是提炼核心关键词、观点、结论,剔除语气词、重复表述、无效修饰语句。
- 可将冗长对话精简为结构化内容:“用户需求:XX;核心问题:XX;诉求:XX”,速度快、零成本,适合轻量场景。
滚动摘要压缩(中阶常用):
- 专为长期多轮对话设计,是工程落地主流策略。
- 核心逻辑为分段滚动总结对话,每N轮交互生成一次精简摘要,替代原始冗长记录,持续更新摘要、舍弃明细内容;
- 全程保留完整对话逻辑与关键信息,严控Token体量,彻底解决长期对话失忆、溢出问题。
层级语义压缩(高阶高精度):
- 适配万字长文档、企业业务资料、合同、技术文档等高精度场景。
- 先拆分全文章节结构,逐段提炼主旨,再整合全局核心逻辑;
- 精准保留关键数据、规则、结论,删除冗余论证、重复案例、无效铺垫,压缩精度极高,不丢失专业核心信息。
向量轻量化压缩(大规模高阶):
- 结合向量技术的规模化方案,将超长文本转化为高维语义向量,舍弃原始文本,仅保留向量用于语义匹配检索。
- 极致节省Token资源,适合海量知识库、超长历史记忆的长期存储与调用,是大型大模型应用的核心压缩方案。
核心压缩原则:所有压缩策略必须优先保留指令规则、核心数据、用户关键诉求、业务结论,仅删减修饰、重复、铺垫类冗余内容,严禁为了精简牺牲语义准确性。
3. 示例:滚动摘要记忆压缩
示例演示滚动摘要记忆压缩:当对话轮数超过阈值时,将远期历史提炼为一条系统摘要消息,近期对话原样保留,在保持上下文连贯性的同时大幅降低Token消耗,适用于多轮对话的长会话场景。
def rolling_compress_dialogue(history: list, compress_interval: int = 4) -> list:
    """
    滚动摘要压缩对话记忆
    :param history: 完整历史对话列表
    :param compress_interval: 每N轮压缩一次
    :return: 压缩后的精简对话
    """
    # 不足轮次不压缩
    if len(history) < compress_interval:
        return history

    # 截取需要压缩的历史记录
    need_compress = history[:-compress_interval]
    keep_latest = history[-compress_interval:]
    # 极简智能摘要(工程轻量化方案,可替换大模型摘要接口)
    summary_content = "历史对话总结:用户主要咨询上下文工程相关技术,包含窗口管理、消息编排基础问题。"
    summary_msg = {"role": "system", "content": summary_content}
    # 压缩后 = 历史摘要 + 最新完整对话
    return [summary_msg] + keep_latest
# 测试
if __name__ == "__main__":
    interval = 4
    # 模拟8轮长对话
    long_history = [{"role": "user", "content": f"问题{i}"} for i in range(8)]
    print(f"原始对话轮数:{len(long_history)},压缩间隔:每{interval}轮\n")
    # 第1步:判断是否需要压缩
    print(f"--- 第1步:判断是否触发压缩 ---")
    print(f"  历史轮数 {len(long_history)} >= 压缩间隔 {interval} -> 触发压缩")
    print("  [说明] 超过指定轮数时自动触发,避免上下文持续膨胀")
    # 第2步:拆分近期保留 vs 远期压缩
    recent = long_history[-interval:]
    old = long_history[:-interval]
    print(f"\n--- 第2步:拆分历史 ---")
    print(f"  远期历史(需压缩): 前 {len(old)} 轮 -> {[m['content'] for m in old]}")
    print(f"  近期历史(保留):   后 {len(recent)} 轮 -> {[m['content'] for m in recent]}")
    print("  [说明] 近期4轮完整保留保证连贯,远期4轮压缩为摘要节省Token")
    # 第3步:压缩结果
    res = rolling_compress_dialogue(long_history)
    print(f"\n--- 第3步:压缩结果 ---")
    print(f"  压缩前: {len(long_history)} 条消息")
    print(f"  压缩后: {len(res)} 条消息 (摘要1条 + 近期{len(recent)}条)")
    for msg in res:
        print(f"  [{msg['role']}] {msg['content'][:50]}{'...' if len(msg['content'])>50 else ''}")
    print("  [说明] 远期对话被提炼为一条摘要消息替代,近期对话原样保留,大幅降低Token消耗")

输出结果:
原始对话轮数:8,压缩间隔:每4轮
--- 第1步:判断是否触发压缩 ---
历史轮数 8 >= 压缩间隔 4 -> 触发压缩
[说明] 超过指定轮数时自动触发,避免上下文持续膨胀
--- 第2步:拆分历史 ---
远期历史(需压缩): 前 4 轮 -> ['问题0', '问题1', '问题2', '问题3']
近期历史(保留): 后 4 轮 -> ['问题4', '问题5', '问题6', '问题7']
[说明] 近期4轮完整保留保证连贯,远期4轮压缩为摘要节省Token
--- 第3步:压缩结果 ---
压缩前: 8 条消息
压缩后: 5 条消息 (摘要1条 + 近期4条)
[system] 历史对话总结:用户主要咨询上下文工程相关技术,包含窗口管理、消息编排基础问题。
[user] 问题4
[user] 问题5
[user] 问题6
[user] 问题7
[说明] 远期对话被提炼为一条摘要消息替代,近期对话原样保留,大幅降低Token消耗
六、检索增强策略
1. 检索增强核心价值
前置技术局限:
- 窗口管理、消息编排、记忆压缩三大策略,仅能对模型已有、对话存量的上下文信息进行优化整理;
- 无法解决模型固有短板:训练数据存在时间截止、无实时信息、缺少专属行业知识,存在天然知识盲区。
检索增强核心定义:
- 检索增强(RAG)是上下文工程对接外部知识的核心入口;
- 核心逻辑为:不依赖模型固有训练知识,提前构建专属知识库,用户提问时,从外部库中检索高相关精准内容,注入上下文窗口,辅助模型推理作答,相当于为大模型配备专属实时参考书。
技术体系定位:
- RAG并非独立技术,而是上下文工程的核心闭环模块。
- 所有检索得到的外部知识,都会参与后续的窗口分配、消息编排、记忆压缩,与前三大策略联动互补,拓展模型信息边界,完善整个上下文体系。
核心落地优势:
- 对比传统模型微调,检索增强优势突出:无需重新训练模型、落地成本极低、知识迭代灵活、支持实时更新。
- 可快速接入企业产品资料、行业专业文档、实时新闻、个人专属笔记,让模型具备专属专业问答能力。
2. 检索增强实践流程
检索增强的完整实践落地流程分为四大核心步骤,全程贴合上下文工程体系,逻辑清晰、可直接应用:
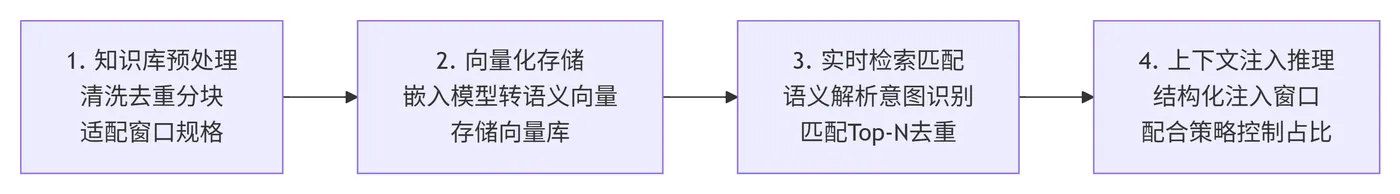
知识库预处理:
- 对原始文档、资料、文本进行清洗,去除无效内容、重复信息、乱码与多余格式,再进行合理文本分块。
- 分块大小需适配模型窗口规格,避免单块内容过长溢出或过短碎片化,保障后续检索内容精准、适配上下文加载规则。
向量化存储:
- 将拆分完成的文本块,通过嵌入模型转换为高维语义向量,统一存储在向量数据库中。
- 向量可精准捕捉文本深层语义,实现语义匹配检索,即便用户提问与原文表述不同、语义相近,也能精准匹配对应知识,效果远超传统关键词检索。
实时检索匹配:
- 用户发起提问后,系统先对问题做语义解析与意图识别,生成对应检索向量,在向量数据库中匹配相似度最高的Top-N文本块;
- 同时完成内容去重、无效信息过滤,筛选出与当前问题高度匹配的优质参考知识。
上下文注入推理:
- 将筛选后的精准知识,按照标准化消息编排规则结构化注入上下文窗口;
- 结合系统指令、历史对话、用户实时问题,让模型基于完整、精准的上下文信息推理作答。
- 同时配合窗口管理策略,控制检索知识Token占比,避免挤占核心指令与对话空间。
高阶优化联动:实际落地中可结合记忆压缩技术,对检索到的长文本知识进行轻量化精简,仅保留与当前问题强相关的核心内容,进一步优化上下文质量,大幅提升模型回答精准度,实现四大模块完整闭环。
3. 示例:轻量化RAG检索增强
示例实现轻量化RAG检索增强:先用固定窗口切分知识文档(overlap防断裂),再用字符集交集/并集比计算问题与分块的相似度,无需嵌入模型即可检索TopK最相关片段,适合快速原型和轻量级检索场景。
import numpy as np
# 1. 文本分块(适配上下文窗口)
def text_chunk_split(text: str, chunk_size: int = 200, overlap: int = 20) -> list:
    chunks = []
    start = 0
    while start < len(text):
        end = start + chunk_size
        chunks.append(text[start:end])
        start = end - overlap
    return chunks
# 2. 简易相似度计算(替代嵌入模型,新手友好)
def calc_similarity(a: str, b: str) -> float:
    set_a, set_b = set(a), set(b)
    return len(set_a & set_b) / max(len(set_a), len(set_b))
# 3. 检索增强主流程
def rag_retrieve(question: str, doc_text: str, top_k: int = 2) -> str:
    # 文档分块
    chunks = text_chunk_split(doc_text)
    # 相似度匹配
    score_list = [(chunk, calc_similarity(question, chunk)) for chunk in chunks]
    # 取TopK高相关内容
    top_chunks = sorted(score_list, key=lambda x: x[1], reverse=True)[:top_k]
    # 拼接参考知识
    return "\n".join([c[0] for c in top_chunks])
# 测试落地
if __name__ == "__main__":
    # 企业专属知识库文本
    knowledge = "上下文工程包含四大核心模块:窗口管理负责Token资源管控;消息编排优化信息结构;记忆压缩突破窗口限制;检索增强拓展知识边界。四大模块层层递进,构成完整落地体系。"
    user_q = "上下文工程有哪些核心模块?"
    chunk_size, overlap, top_k = 200, 20, 2
    print(f"用户提问:{user_q}")
    print(f"文档长度:{len(knowledge)} 字符\n")
    # 第1步:文本分块
    chunks = text_chunk_split(knowledge, chunk_size, overlap)
    print(f"--- 第1步:文本分块 (chunk_size={chunk_size}, overlap={overlap}) ---")
    for i, c in enumerate(chunks):
        print(f"  分块{i}: {c}...")
    print(f"  共 {len(chunks)} 个分块")
    print("  [说明] 文档按固定窗口切分,相邻分块有重叠避免语义断裂")
    # 第2步:相似度匹配
    print(f"\n--- 第2步:字符集重叠相似度匹配 ---")
    score_list = [(chunk, calc_similarity(user_q, chunk)) for chunk in chunks]
    for chunk, score in score_list:
        print(f"  相似度={score:.3f} | {chunk[:40]}...")
    print("  [说明] 用字符集合交集/并集计算相似度,无需嵌入模型,适合轻量级场景")
    # 第3步:TopK筛选
    top_chunks = sorted(score_list, key=lambda x: x[1], reverse=True)[:top_k]
    print(f"\n--- 第3步:Top{top_k} 筛选与拼接 ---")
    for rank, (chunk, score) in enumerate(top_chunks, 1):
        print(f"  Top{rank}: 相似度={score:.3f} | {chunk}")
    ref_knowledge = "\n".join([c[0] for c in top_chunks])
    print(f"\n最终参考知识:{ref_knowledge}")
    print("  [说明] 取最相关片段作为检索增强的上下文,注入LLM prompt中补充领域知识")

输出结果:
用户提问:上下文工程有哪些核心模块?
文档长度:81 字符
--- 第1步:文本分块 (chunk_size=200, overlap=20) ---
分块0: 上下文工程包含四大核心模块:窗口管理负责Token资源管控;消息编排优化信息结构;记忆压缩突破窗口限制;检索增强拓展知识边界。四大模块层层递进,构成完整落地体系。...
共 1 个分块
[说明] 文档按固定窗口切分,相邻分块有重叠避免语义断裂
--- 第2步:字符集重叠相似度匹配 ---
相似度=0.132 | 上下文工程包含四大核心模块:窗口管理负责Token资源管控;消息编排优化信息结构...
[说明] 用字符集合交集/并集计算相似度,无需嵌入模型,适合轻量级场景
--- 第3步:Top2 筛选与拼接 ---
Top1: 相似度=0.132 | 上下文工程包含四大核心模块:窗口管理负责Token资源管控;消息编排优化信息结构;记忆压缩突破窗口限制;检索增强拓展知识边界。四大模块层层递进,构成完整落地体系。
最终参考知识:上下文工程包含四大核心模块:窗口管理负责Token资源管控;消息编排优化信息结构;记忆压缩突破窗口限制;检索增强拓展知识边界。四大模块层层递进,构成完整落地体系。
[说明] 取最相关片段作为检索增强的上下文,注入LLM prompt中补充领域知识
七、总结
大模型应用的核心竞争力,从来不在于花哨的单点Prompt技巧,而在于系统化的上下文工程能力。Prompt工程仅能实现单次对话的单点优化,而上下文工程是全局体系化赋能,是大模型稳定、高效、精准落地的底层核心支撑。


四大上下文工程模块层层递进、互补闭环,构成完整的大模型信息管理体系:
- 上下文窗口管理:管控Token资源,筑牢信息承载基础,解决“装得下”的问题;
- 消息编排策略:优化信息结构层级,适配模型注意力,解决“读得懂”的问题;
- 记忆压缩技术:精简冗余信息,突破窗口容量瓶颈,解决“装得多、不遗忘”的问题;
- 检索增强策略:拓展外部知识边界,补齐模型能力短板,解决“答得准、跟得上”的问题。
当下大模型落地日趋成熟,单纯的提示词优化已无法满足企业级业务需求,上下文工程已成为AI开发、模型优化、智能体搭建的必备核心能力。未来大模型应用的竞争,本质是上下文调度能力与信息优化能力的竞争。理解透了上下文工程,才能真正驾驭大模型,让AI能力稳定落地、高效赋能各类业务场景。
如果初学无需急于上手高阶复杂策略,可循序渐进迭代落地,稳步搭建标准化体系:

- 第一步:做好窗口基础管控,规避溢出问题、优化Token资源分配;
- 第二步:规范消息编排结构,梳理上下文层级,优化模型注意力匹配度;
- 第三步:接入基础记忆压缩,适配超长对话、长文本场景;
- 第四步:落地检索增强能力,接入专属知识库,拓展模型专业能力。