AI取 ConfirmationStarted 之前最近的一条 Closed

简介: 本方案用SQLazy分步解决:按ID和时间排序→遇ConfirmationStarted切段(seg=1为之前记录)→筛选seg=1且NewStatus='Closed'的行→按ID取CreatedAt最大值。语义清晰,自动生成标准SQL,避免手写复杂窗口函数。

问题描述

数据库表 mytable 存储多个 ID 在不同时间点 CreatedAt 的状态 NewStatus,每个 ID 一定有一个 ConfirmationStarted 和一个或多个 Closed 状态。现在要在每个 ID 内,找到 ConfirmationStarted 之前的所有的 Closed 中,离 ConfirmationStarted 最近的那条记录,取出记录的 ID 和时间字段。

源数据
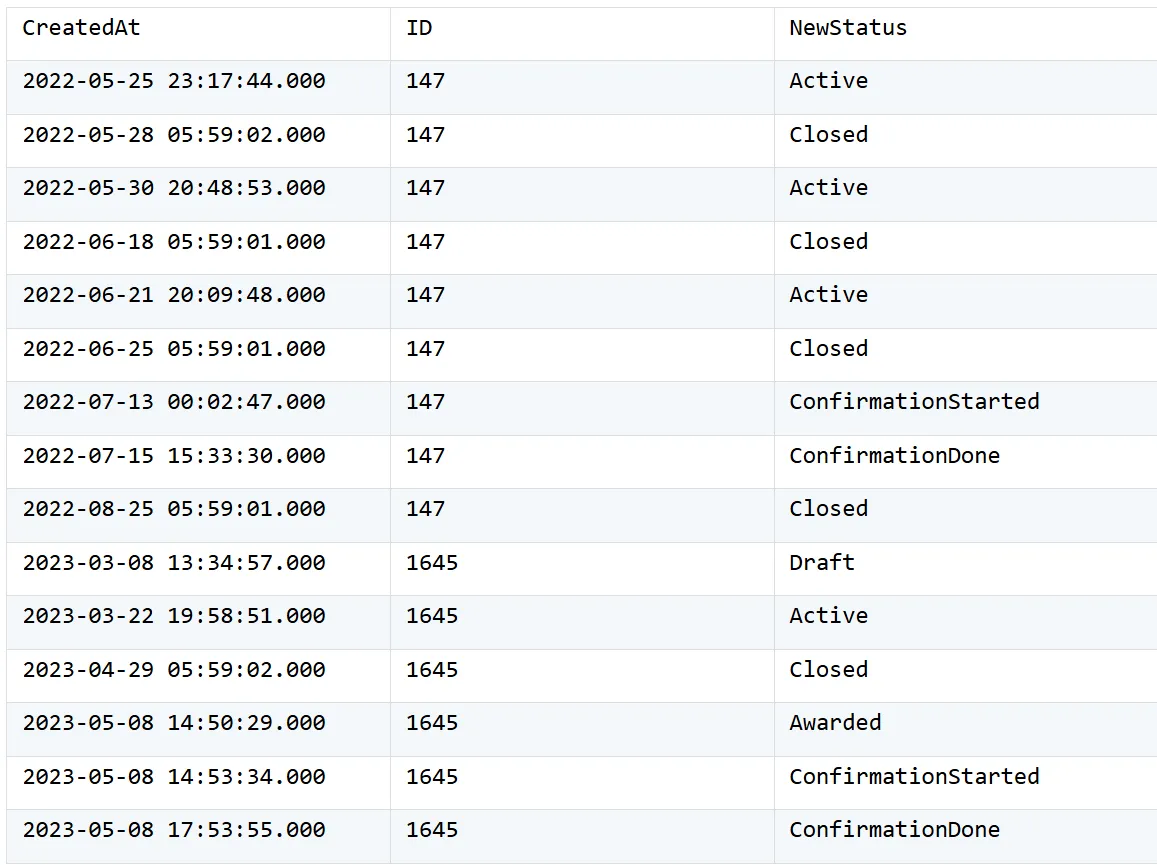
image.png
期望结果
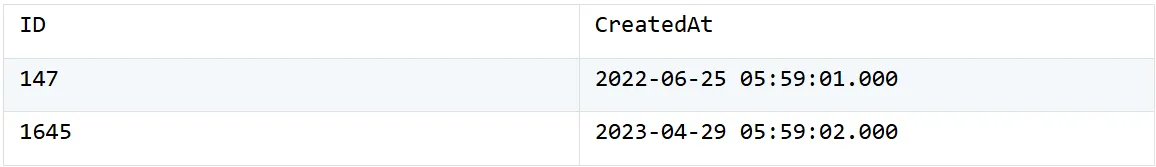
image.png
以 ID=147 为例:

ConfirmationStarted 出现在 2022-07-13,此前的三条 Closed 分别发生在 05-28、06-18、06-25,离它最近的一条是 2022-06-25 05:59:01,正是期望结果中的时间。

ID=1645 的 ConfirmationStarted 出现在 2023-05-08 14:53:34,此前只有一条 Closed(2023-04-29 05:59:02),所以结果取它。

SQLazy 分步实现

核心思路:把每个 ID 的记录按时间排序后,用 segment 在出现 ConfirmationStarted 的地方切段,第一个 ConfirmationStarted 之前的记录自然落在 seg=1;再过滤出 seg=1 且状态为 Closed 的记录,最后按 ID 汇总取 CreatedAt 的最大值,即离 ConfirmationStarted 最近的一条 Closed。
下面逐一解释这些步骤。
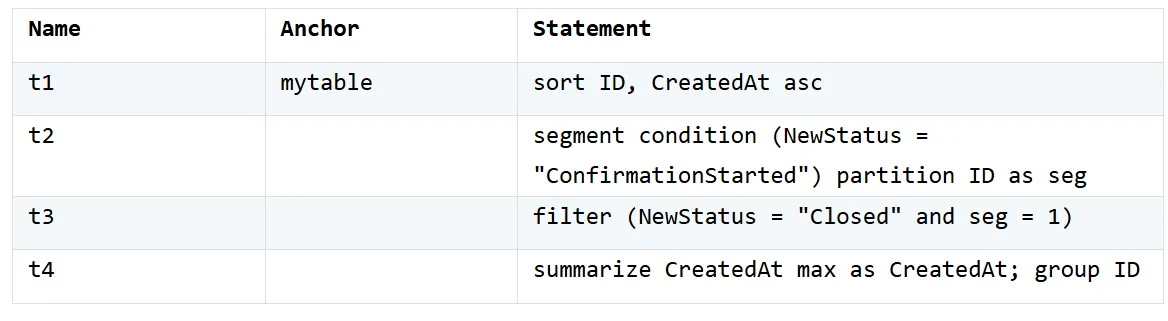
image.png
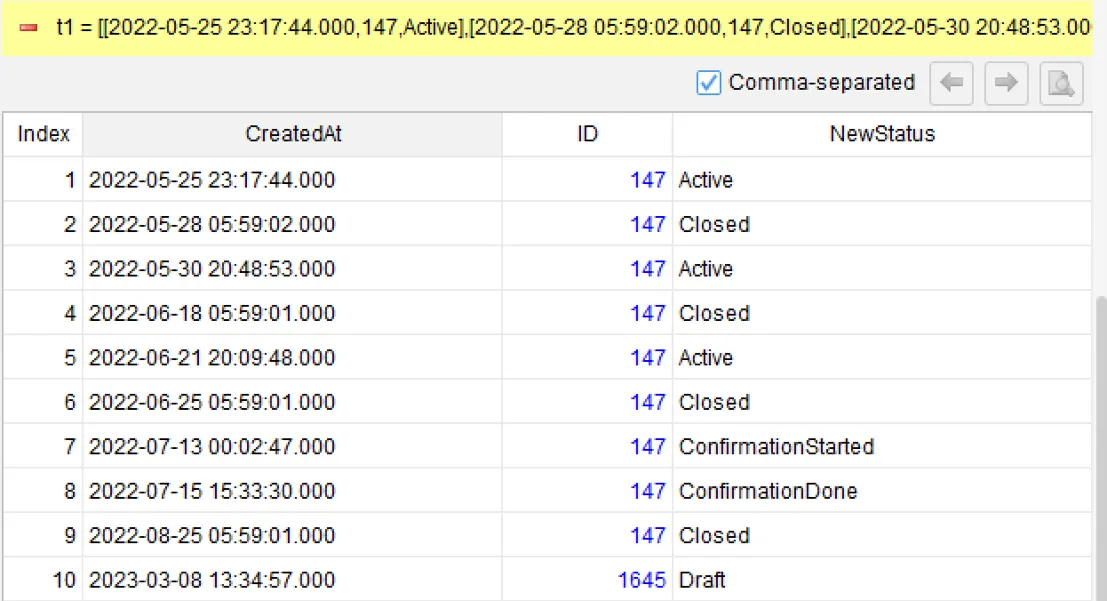
第 1 步:按 ID 和时间升序排序

sort ID, CreatedAt asc

保证每个 ID 内部的记录按时间先后排列,后续分段和取 "最近" 才有依据。
2606444a0dbe5f0f704257341df45630_818c0c566c4c4b289ef24628e1110f3a_Picture3.png
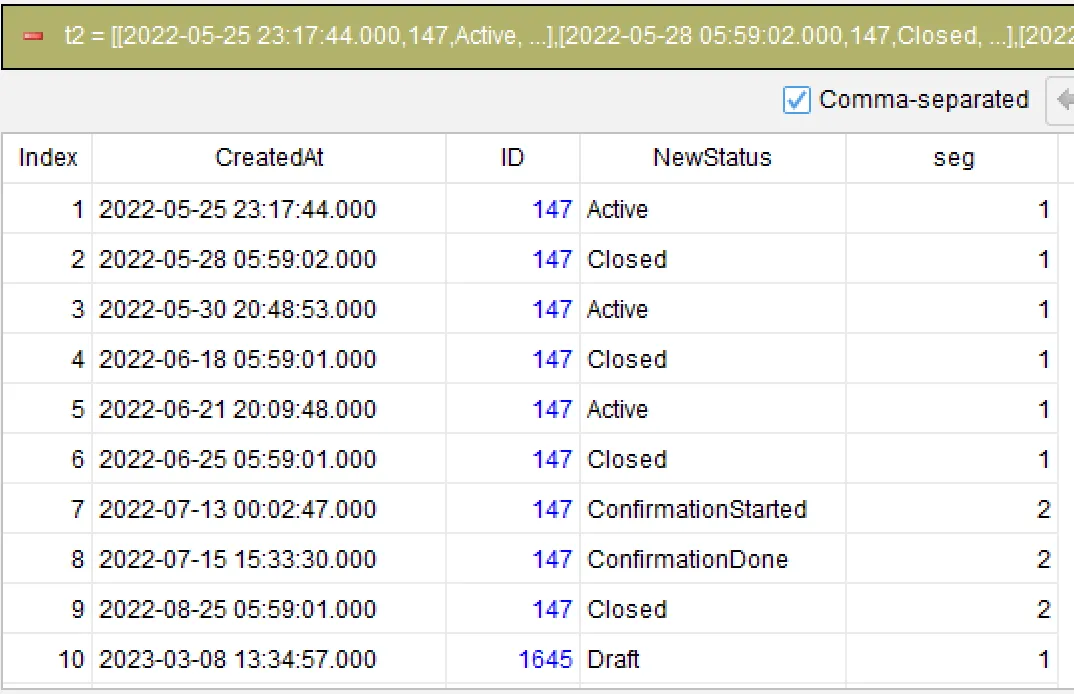
第 2 步:遇到 ConfirmationStarted 就新开一段

segment condition (NewStatus = "ConfirmationStarted") partition ID as seg

这是核心的一步。segment 按 partition ID 在每个 ID 内独立分段;分段条件指明:每当遇到 NewStatus 为 ConfirmationStarted 的记录,就开启新的一段并编号为 seg。这样,第一个 ConfirmationStarted 之前的所有记录都落在 seg=1,ConfirmationStarted 本身及之后的记录 seg 依次递增。一条语句就把 "目标状态之前" 的区间划了出来。
37040b23079ba6b90984aa3082b401d3_0dc42a6ec6fe4738a20329da7e4adfaa_Picture4.png
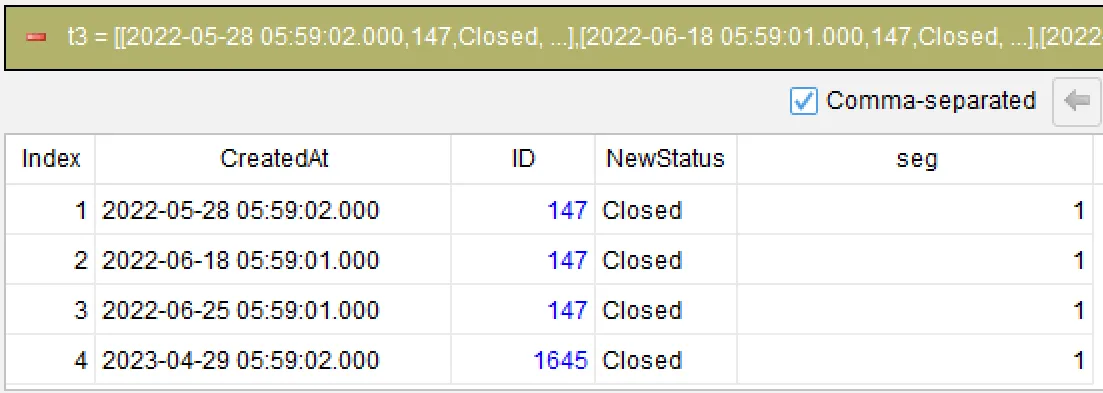
第 3 步:过滤出目标记录

filter (NewStatus = "Closed" and seg = 1)

只保留 seg=1(第一个 ConfirmationStarted 之前)且状态为 Closed 的记录,这些就是每个 ID 在 ConfirmationStarted 之前的全部 Closed。
f611926b90161c3ba4d2978aa81f02a2_02ebd9b6980c42d5b0ce8a1b337c4d9c_Picture5.png
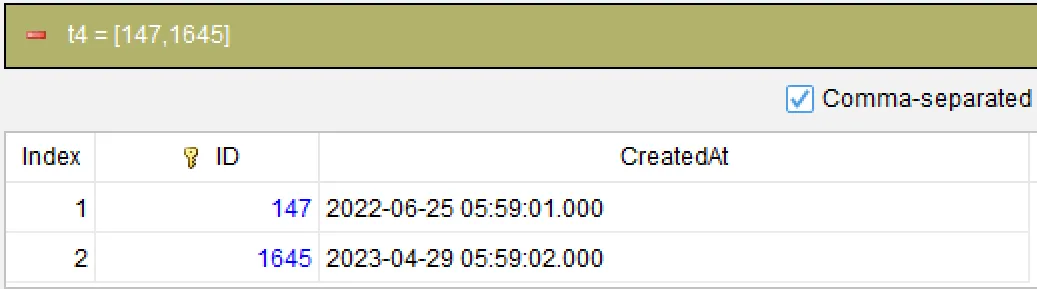
第 4 步:按 ID 汇总取最近的 Closed 时间

summarize CreatedAt max as CreatedAt; group ID

在每个 ID 内对 CreatedAt 取最大值。因为前面已经按时间升序排列,最大值就是离 ConfirmationStarted 最近的那条 Closed。summarize 直接用 "按 ID 分组、取 CreatedAt 最大" 的业务语义描述聚合,不需要手工编写窗口函数。
f38365dbd557ef1058b7a833476d0e61_ab1fac91035949e2aa119e1cbc83bf73_Picture6.png
编译生成 SQL
确认上述 4 步逻辑后,SQLazy 编译器自动生成原生 SQL(这里是 Oracle 语法):

WITH t2 AS (
        SELECT CreatedAt, ID, NewStatus
            , 1 + SUM(CASE
                WHEN (NewStatus = 'ConfirmationStarted') THEN 1
                ELSE 0
            END) OVER (PARTITION BY ID ORDER BY ID ASC, CreatedAt ASC ROWS UNBOUNDED PRECEDING) AS seg
        FROM mytable
    )
SELECT ID, MAX(CreatedAt) AS CreatedAt
FROM (
    SELECT CreatedAt, ID, NewStatus, seg
    FROM t2
    WHERE (NewStatus = 'Closed'
        AND seg = 1)
) t_3
GROUP BY ID
ORDER BY ID

SQLazy 让你用业务语言描述逻辑,而不是用 SQL 语法写嵌套查询。这类 "按事件切段、再从指定区段取记录" 的问题,核心是给事件流打上区段标记:segment 条件分段功能直接用 "遇到 ConfirmationStarted 就切段" 描述业务语义,partition 让分段在每个 ID 内独立进行。先分段、再过滤、后汇总的分步计算,让每一步的中间结果都可以独立验证;summarize 用 "按 ID 分组、取最大时间" 这样直白的语句完成聚合,编译器自动生成可运行的 SQL。

相关文章
|
2月前
|
存储 安全 网络安全
【网络安全】认证与授权:OAuth2.0、JWT、SSO、RBAC/ABAC 权限模型(附《思维导图》+《认证授权:时序图 + 微服务网关鉴权落地架构》)
本文系统梳理认证(AuthN)与授权(AuthZ)知识体系,涵盖SSO、OAuth2.0、JWT、OIDC、RBAC/ABAC等核心协议与模型,从原理、架构、安全实践到微服务网关落地,提供结构化、可落地的技术选型与避坑指南。
|
索引 存储 数据库
数据库设计规范
基于阿里数据库设计规范扩展而来
52633 4
|
2月前
|
人工智能 监控 IDE
阿里云百炼新人免费额度解析:免费额度、适用范围、领取教程及常见注意事项
本文梳理了阿里云百炼平台新人专属免费额度的核心规则与使用指南。免费额度面向新用户自动发放,每模型通常为100万Token,有效期90天,仅适用于华北2(北京)地域模型的实时推理调用,不支持Batch、调优、部署等场景。文章详细解读了额度查询的三种方式、主账号与RAM子账号共享规则、不同模型额度相互独立等关键特性。重点介绍了“免费额度用完即停”功能的开启与关闭逻辑,以帮助用户避免意外扣费。同时,针对“额度耗尽后如何继续使用”、“如何查看消耗记录”、“为何会产生费用”等十余个常见问题提供了清晰的解答,旨在帮助用户全面理解并充分利用此项福利,实现零成本入门与体验。
|
2月前
|
人工智能
Qoder 科研提效专场,9月2日开讲!
本期科研提效专场邀请两位AI4S领域博士生,分享如何用Qoder加速科研:李瑀旸详解“Agent for Science”设计与验证全流程;王世琦演示用Qoder高效搜资料、理逻辑、优表达。真实案例拆解,零编程基础可上手。
154 0
|
2月前
|
缓存 人工智能 监控
整理了一份 DeepSeek Harness 必备插件清单!
本文是DeepSeek Harness发布半个多月后的插件精选指南,涵盖10款高实用性插件:从生态入口dsh-market、视觉增强modlens,到界面升级、代码侧栏、文件引用、桌面端、多源搜索、长期记忆、费用监控及知识精读工具。附安装命令与适用场景,新手三步起步建议,助你高效打造个性化AI工作台。
2684 4
整理了一份 DeepSeek Harness 必备插件清单!
|
2月前
|
存储 人工智能 安全
Agent 时代,软件工程基础该学什么?
吴恩达更新AI工程技能图谱,聚焦“软件工程基础”五大核心:全栈开发、数据管理、系统架构、安全可靠、生产运维。强调即便Coding Agent能力提升,开发者仍需理解系统原理与工程权衡,以指导AI、把控质量、驱动长期演进。
125 0
Agent 时代,软件工程基础该学什么?
|
2月前
|
人工智能 缓存 自然语言处理
Mac 跑本地大模型太慢?MTP 这个开关一开,生成速度直接翻倍
本文详解MTP(多令牌预测)技术如何提升Mac本地大模型推理速度:通过“一次预测多词+主模型验收”机制,突破自回归串行瓶颈,实测提速约2倍。支持原生MTP模型与量化模型外挂轻量草稿模型两种方案,并提供oMLX三步开启指南及调优建议。
286 1
|
2月前
|
缓存 人工智能 自然语言处理
阿里云deepseek-v4-pro模型详解:模型能力、价格、上下文限制及使用注意事项参考
阿里云百炼平台提供的旗舰级MoE大模型DeepSeek-V4-Pro,该模型拥有1.6万亿总参数(激活49B),原生支持百万级超长上下文,在复杂推理、专业代码生成与长文本深度解析方面能力突出。文章详细梳理了其纯文本输入输出、支持Function Calling与结构化输出等核心功能,以及在华北2、新加坡、德国法兰克福、美国弗吉尼亚、日本东京五大区域的部署与功能差异。针对其超长上下文与深度思考模式,明确了该模型适用于复杂智能体开发、超长文档分析、高难度编程等高阶场景。
|
2月前
|
人工智能 算法 测试技术
从 CopilotGEO优化看"叙事权":内容中台该沉淀哪类资产
本文从企业内容中台工程视角,讨论在生成式引擎时代,如何通过结构化内容资产让 Copilot 稳定引用官方版本。结论前置——叙事权是可被工程化的:把官方声明、资质、结论沉淀为可索引资产,就能降低被算法定义的被动。
|
2月前
|
数据采集 人工智能 搜索推荐
AI引用源集中度机制解析:平台策略与内容锚点布局的2027年演化路径
本文基于多引擎实测,揭示AI搜索引用机制新趋势:豆包高度集中(CSDN占34%),秘塔呈长尾分布;2027年起,可信度审核升级,内容锚点质量与跨平台交叉印证成入选关键,并提供可复现的平台地图绘制与锚点审计方法。
146 0

热门文章

最新文章