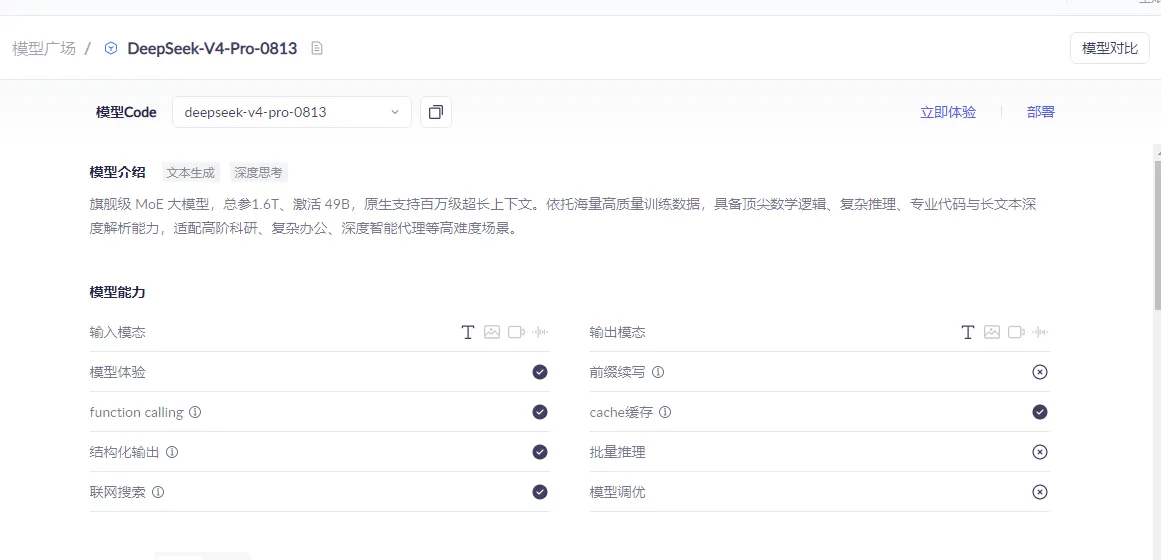
DeepSeek-V4-Pro属于阿里云旗舰级 MoE 大模型,总参1.6T、激活 49B,原生支持百万级超长上下文。依托海量高质量训练数据,具备顶尖数学逻辑、复杂推理、专业代码与长文本深度解析能力,适配高阶科研、复杂办公、深度智能代理等高难度场景。以下是对阿里云DeepSeek-V4-Pro模型的全面、专业且结构化介绍:
一、阿里云 DeepSeek-V4-Pro 模型介绍
DeepSeek-V4-Pro 是由深度求索(DeepSeek)研发、通过阿里云百炼平台提供的旗舰级混合专家(MoE)大语言模型。该模型具备以下核心特征:
- 超大规模参数架构:总参数量达 1.6 万亿(1.6T),其中每次推理激活参数约 490 亿(49B);
- 原生支持百万级超长上下文:最大上下文长度为 1,000,000 tokens,可一次性处理整本长篇小说或大型技术文档;
- 训练数据高质量:依托海量高质量语料,在数学逻辑、复杂推理、专业代码生成及长文本深度解析方面表现顶尖;
- 服务部署方式灵活:既可通过阿里云百炼平台以 API 形式调用,也支持在人工智能平台 PAI 上进行私有化一键部署;
- 推理服务由阿里云百炼提供,具备高可用性、自动扩缩容与负载均衡能力。
注意:该模型为纯文本模型,仅支持 Text 输入与输出,不支持图像或多模态输入。
二、阿里云 DeepSeek-V4-Pro 模型能力介绍
1. 华北2(北京)
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Text | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 支持 | 联网搜索 | 支持 |
| 前缀续写 | 不支持 | 上下文缓存 | 支持 |
| 批量推理 | 不支持 | 模型调优 | 不支持 |
2. 新加坡
部署范围:国际
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Text | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 支持 | 联网搜索 | 支持 |
| 前缀续写 | 不支持 | 上下文缓存 | 支持 |
| 批量推理 | 不支持 | 模型调优 | 不支持 |
3. 德国(法兰克福)
部署范围:全球
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Text | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 支持 | 联网搜索 | 不支持 |
| 前缀续写 | 不支持 | 上下文缓存 | 支持 |
| 批量推理 | 不支持 | 模型调优 | 不支持 |
4. 美国(弗吉尼亚)
部署范围:全球
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Text | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 支持 | 联网搜索 | 不支持 |
| 前缀续写 | 不支持 | 上下文缓存 | 支持 |
| 批量推理 | 不支持 | 模型调优 | 不支持 |
5. 日本(东京)
部署范围:全球
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Text | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 支持 | 联网搜索 | 支持 |
| 前缀续写 | 不支持 | 上下文缓存 | 支持 |
| 批量推理 | 不支持 | 模型调优 | 不支持 |
6. 推理模式与思考机制
- 默认启用 混合思考模式(Hybrid Reasoning Mode),模型在生成前会进行内部推理链(Chain-of-Thought)规划;
- 可通过
reasoning_effort参数调整推理强度(如high、max),适用于不同复杂度任务; - 思维链内容按输出 Token 计费。
7. 上下文与长度限制
| 参数 | 数值(tokens) |
|---|---|
| 最大上下文长度 | 1,000,000 |
| 最大输入长度 | 1,000,000 |
| 最大输出长度 | 393,216 |
三、阿里云 DeepSeek-V4-Pro 模型适用场景解析
基于其超长上下文、强推理与代码能力,DeepSeek-V4-Pro 特别适用于以下高阶场景:
1. 复杂智能体(Agent)开发
- 构建具备多步规划、工具调用(Function Calling)和自主决策能力的 AI Agent;
- 适用于科研自动化、企业工作流引擎、RPA 升级等场景。
2. 超长文档处理与分析
- 法律合同全文理解、财报深度解读、技术白皮书摘要;
- 支持上传整本 PDF/Word 文档进行问答与信息抽取(结合前端文件解析)。
3. 高难度编程与算法任务
- 生成复杂系统架构代码(如分布式后端、全栈应用);
- 数学建模、算法优化、LeetCode Hard 级题目解答。
4. 高精度知识问答与内容生成
- 学术写作辅助、专利撰写、技术方案设计;
- 在中文语境下对专业领域(金融、医疗、工程)问题具备较强理解力。
推荐客户:需快速构建 AI 智能体、处理长文本、执行复杂推理或高并发代码生成的企业与开发者团队。
四、阿里云 DeepSeek-V4-Pro 模型定价
定价按 输入 Token + 输出 Token 分别计费,具体价格因区域而异,且可能包含限时优惠。下面仅展示模型调用原价,不包含限时优惠等活动信息,请前往阿里云百炼平台:https://www.aliyun.com/product/bailian 查看活动优惠,目前登录可自动获得100万Tokens免费试用额度,下图所示:
1. 华北2(北京)
| 计费项 | 价格(元) | 单位 |
|---|---|---|
| 输入 | 12 | 每百万tokens |
| 输出 | 24 | 每百万tokens |
| 输入(缓存命中) | 1 | 每百万tokens |
2. 新加坡
部署范围:国际
| 计费项 | 价格(元) | 单位 |
|---|---|---|
| 输入 | 17.986 | 每百万tokens |
| 输出 | 35.972 | 每百万tokens |
| 输入(缓存命中) | 1.499 | 每百万tokens |
3. 德国(法兰克福)
部署范围:全球
| 计费项 | 价格(元) | 单位 |
|---|---|---|
| 输入 | 12 | 每百万tokens |
| 输出 | 24 | 每百万tokens |
| 输入(缓存命中) | 1 | 每百万tokens |
4. 美国(弗吉尼亚)
部署范围:全球
| 计费项 | 价格(元) | 单位 |
|---|---|---|
| 输入 | 12 | 每百万tokens |
| 输出 | 24 | 每百万tokens |
| 输入(缓存命中) | 1 | 每百万tokens |
5. 日本(东京)
部署范围:全球
| 计费项 | 价格(元) | 单位 |
|---|---|---|
| 输入 | 12 | 每百万tokens |
| 输出 | 24 | 每百万tokens |
| 输入(缓存命中) | 1 | 每百万tokens |
6. 官方说明要点
- 免费额度:百炼新用户可享 100 万免费 Token,自开通起 180 天内有效;
- 计费粒度:出账周期为分钟级,消费明细可在阿里云账单中心查看;
- 思考模式成本:思维链(CoT)内容计入输出 Token,可能显著增加费用。
7. 价格查询方式
- 官方渠道:具体单价请前往 阿里云百炼控制台 > 模型市场 > DeepSeek-V4-Pro 详情页 查看实时报价;
- 注意:文档中未公开具体数值,强调“以控制台显示的实际报价为准”。
8. 成本优化建议
- 启用 上下文缓存 减少重复上下文传输;
- 非生产环境优先使用 DeepSeek-V4-Flash 或蒸馏模型(如 DeepSeek-R1-Distill-Qwen-7B)以降低成本。
五、阿里云 DeepSeek-V4-Pro 使用 API 参考
该模型通过 阿里云百炼平台 提供标准化 API,兼容 OpenAI 接口规范。
1. OpenAI兼容
from openai import OpenAI
import os

client = OpenAI(
    # 如果没有配置环境变量,请用阿里云百炼API Key替换:api_key="sk-xxx"
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://llm-fltqd30d7x9rrh4v.cn-beijing.maas.aliyuncs.com/compatible-mode/v1",
)

messages = [{"role": "user", "content": "你是谁"}]
completion = client.chat.completions.create(
    model="deepseek-v4-pro-0813",  # 您可以按需更换为其它深度思考模型
    messages=messages,
    extra_body={"enable_thinking": True},
    stream=True
)
is_answering = False  # 是否进入回复阶段
print("\n" + "=" * 20 + "思考过程" + "=" * 20)
for chunk in completion:
    if not chunk.choices:
        continue
    delta = chunk.choices[0].delta
    if hasattr(delta, "reasoning_content") and delta.reasoning_content is not None:
        if not is_answering:
            print(delta.reasoning_content, end="", flush=True)
    if hasattr(delta, "content") and delta.content:
        if not is_answering:
            print("\n" + "=" * 20 + "完整回复" + "=" * 20)
            is_answering = True
        print(delta.content, end="", flush=True)
2. DashScope
import os
from dashscope import Generation
import dashscope
dashscope.base_http_api_url = 'https://llm-fltqd30d7x9rrh4v.cn-beijing.maas.aliyuncs.com/api/v1'

messages = [
    {"role": "system", "content": "You are a helpful assistant."},
    {"role": "user", "content": "你是谁?"},
]
response = Generation.call(
    # 若没有配置环境变量,请用百炼API Key将下行替换为:api_key = "sk-xxx",
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    model="deepseek-v4-pro-0813",
    messages=messages,
    result_format="message",
    # 开启深度思考
    enable_thinking=True,
)

if response.status_code == 200:
    # 打印思考过程
    print("=" * 20 + "思考过程" + "=" * 20)
    print(response.output.choices[0].message.reasoning_content)

    # 打印回复
    print("=" * 20 + "完整回复" + "=" * 20)
    print(response.output.choices[0].message.content)
else:
    print(f"HTTP返回码:{response.status_code}")
    print(f"错误码:{response.code}")
    print(f"错误信息:{response.message}")
3. 关键 API 能力说明
- Function Calling:通过
tools字段定义外部工具,模型可自主调用; - 结构化输出:设置
response_format.type = "json_object"并配合 JSON Schema 约束格式; - 上下文缓存:通过
cache_key显式复用历史上下文,降低延迟与成本; - 兼容 OpenAI 接口:支持
v1/chat/completions和v1/completions路径。
3. 调用入口与认证
- Endpoint:通过百炼控制台获取专属调用地址(区分地域);
- 认证方式:使用阿里云 AccessKey ID/Secret 进行签名认证;
- 错误排查:若返回 404,请确认 URL 是否包含
/v1/chat/completions后缀。
4. 可视化体验
- 可通过 Chatbox、Dify、Cherry Studio 等第三方客户端接入,无需编码即可测试。
2026年阿里云AI产品与云产品优惠权益参考:
AI 产品权益主要包括智启 AI 普惠权益,至高享 1亿+免费 tokens,加速 Al 应用落地;Token Plan 模型订阅计划,Qwen3.8-Max 首发尝鲜,限时加量 10 倍,夜间低至2折;千问办公,限时限量积分加倍,你的AI工作搭子,覆盖日常办公高频场景;万小智 AI 建站低至 15元/月,送.CN域名,送备案服务码;Night Plan 支持 Qwen 3.8-Max,夜间 5 折,Qwen/Meoo/TokenPlan 客户专享。而云产品权益主要有轻量应用服务器限时抢购2核2G38元/年;经济型e实例3.9折,通用算力型u2i实例3折,九代c9i、g9i、r9i等实例1年付6.4折起等优惠权益。详情可通过阿里云权益中心了解:https://www.aliyun.com/benefit
小结:DeepSeek-V4-Pro作为依托阿里云百炼平台落地的旗舰级MoE大语言模型,凭借1.6万亿总参数架构、百万级超长上下文与顶尖的数学逻辑、代码生成能力,为复杂智能体开发、超长文档深度解析等高阶场景提供了高可靠的算力底座。依托阿里云成熟的云服务能力,它既支持轻量化API快速接入,也可通过PAI平台完成私有化一键部署,开发者可根据业务的地域合规性、推理强度需求灵活调整参数配置,搭配上下文缓存等降本策略,在充分释放模型推理能力的同时控制投入成本,新用户还可领取百万级免费Tokens额度,零门槛完成复杂推理类应用的前期验证。