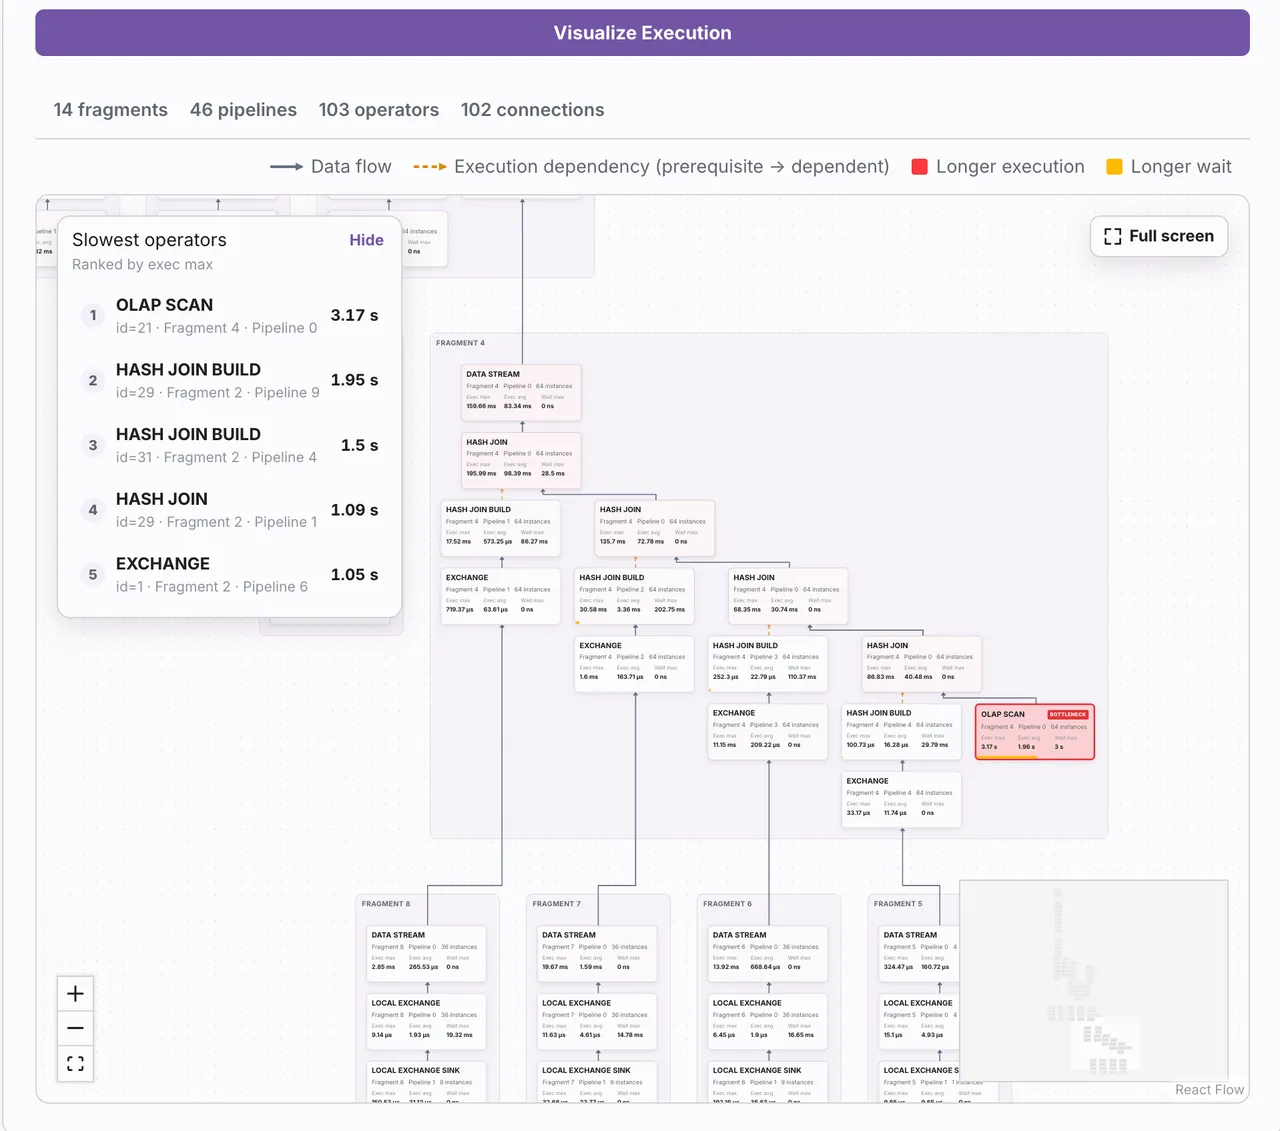
近日,Apache Doris 官网正式上线 Profile 诊断页面。用户上传 Profile 文件后,即可直观查看查询的逻辑执行计划、物理执行分片,并快速定位耗时节点。同时,系统支持生成从结论、证据链到行动建议的完整 AI 诊断报告。
本文将介绍支撑这一 AI 诊断能力的核心机制——Doris Skills 智能诊断体系的设计逻辑与实现路径。
一、Profile 排查中的常见误诊
在分布式数据库的性能排查中,通用 AI 模型常因缺乏内核经验知识而产生误判。以下为两个典型场景:
误诊场景 1:因果关系倒置
在某次耗时 13 秒的查询中,Profile 显示 EXCHANGE_OPERATOR 算子的 WaitForData0(等待数据)耗时达 11 秒:
Fragment 2 · EXCHANGE_OPERATOR (id=5)
  - ExecTime:              avg 12s41ms, max 12s388ms
  - WaitForData0:          11s903ms
  - RowsProduced:          1.02M
  - GetDataFromRecvrTime:  41.2ms
如果使用通用 AI 模型进行分析,很可能得出以下结论:EXCHANGE 算子等待数据 12 秒,占了绝大部分耗时,是主要瓶颈,建议提高并行度并检查 BE 之间的网络。
但实际上,WaitForData0 记录的是 Exchange 接收端等待上游发送数据的时间。真正耗时的是上游算子:HASH_JOIN_SINK_OPERATOR(Build 阶段耗时 11.8 秒)
误诊场景 2:指标语义混淆
在查看算子耗时时,HASH_JOIN_SINK_OPERATOR 的 ExecTime 累加值(sum)为 47.9 秒,远超查询总耗时 13 秒:
Fragment 1 · HASH_JOIN_SINK_OPERATOR (id=4)
  - ExecTime:              sum 47s912ms, avg 11s978ms, max 12s31ms
  - BuildTime:             11s844ms
  - BuildRows:             218,412,096
  - MemoryUsageHashTable:  9.62 GB
  - RuntimeFilterInfo:     RF000[in_or_bloom] <- fact_events.user_id
在没有经验知识的情况下,AI 可能会按 sum 排序,将并发度最高但实际运行顺畅的算子判定为最耗时节点。实际上,在多并发执行体系下,衡量实际阻塞时间应依据 max 值,而非并发任务的 sum 累加值。
从以上两个案例可以看出,一个简单的 Profile,可能导致两个误诊:
- HASH JOIN 耗时:被误诊为 EXCHANGE 的网络问题。
- 算子的实际耗时:被误诊为所有并发任务的累计耗时。
上述误诊表明:传统的文档知识库仅解决“数据库能力”的检索,而性能排查需要构建严谨的证据链推导。Doris Skills 即为此目的设计。
二、Doris Skills 的四大设计思考
Doris Skill 是一套基于 Apache Doris 内核行为构建的决策规则库,旨在将资深 DBA 的排查经验转化为工程化规则。以 doris-profile-reader 为例,其设计逻辑分为以下四个核心维度:
从计数器到证据效力
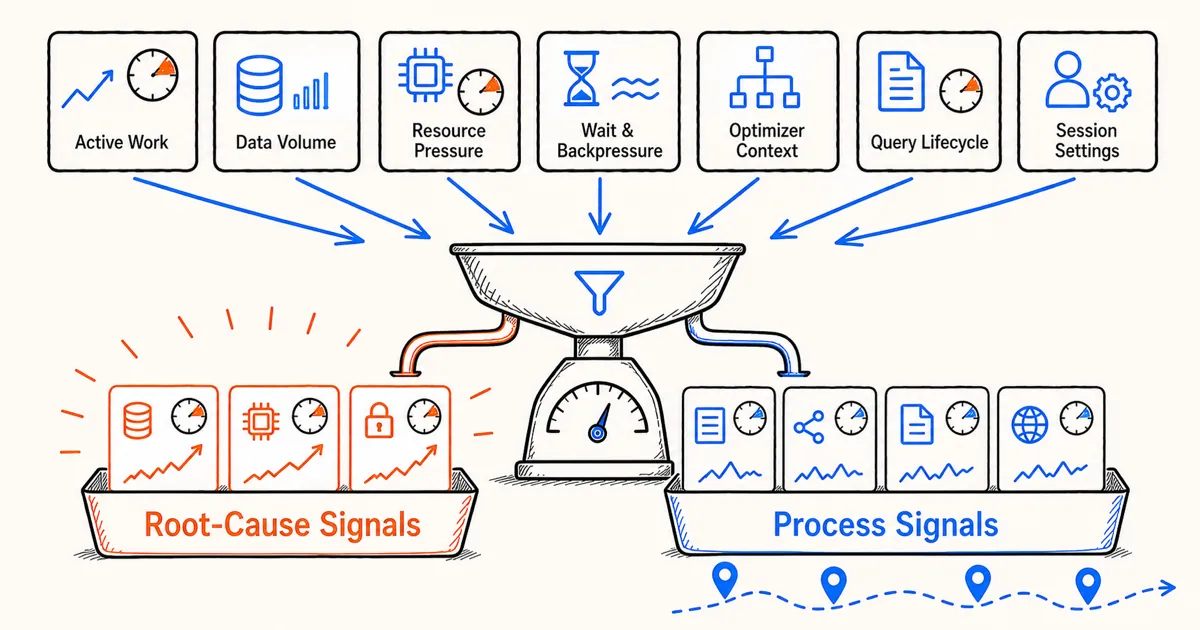
Profile 中包含数十至上百个计数器,但其诊断价值各异。例如,ExecTime 记录算子总耗时,而 WaitForData0 记录接收端等待上游发送数据的时间,两者相减才是算子自身的实际执行时间。
doris-profile-reader 将计数器划分为七大类,并进一步提炼为两大判定规则:
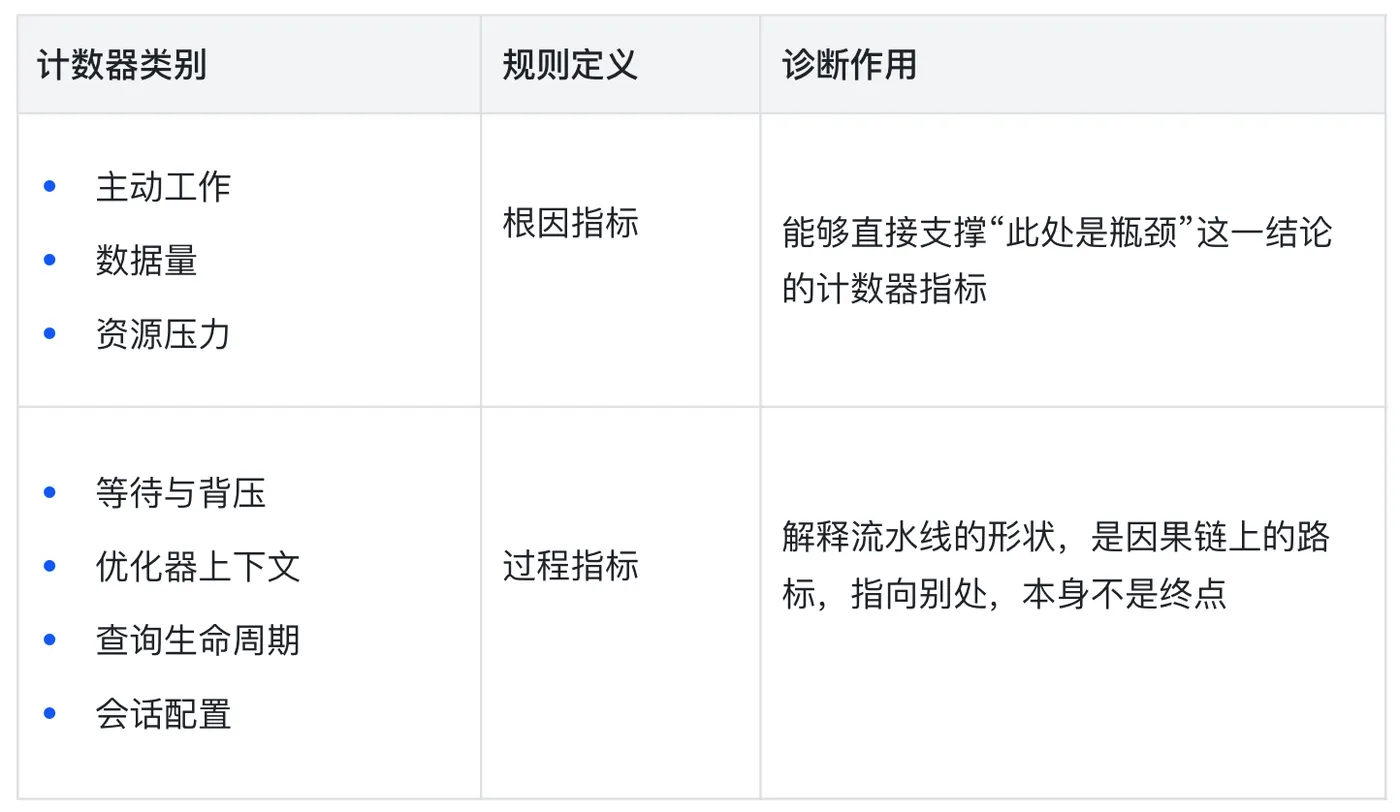
基于上述规则,时间计数器的分析优先级明确为:
主动计时器(主动工作) → 行数与字节数(数据量) → 数据倾斜(资源压力) → 队列与调度等待(等待与背压)
从运行时开销到计划形状
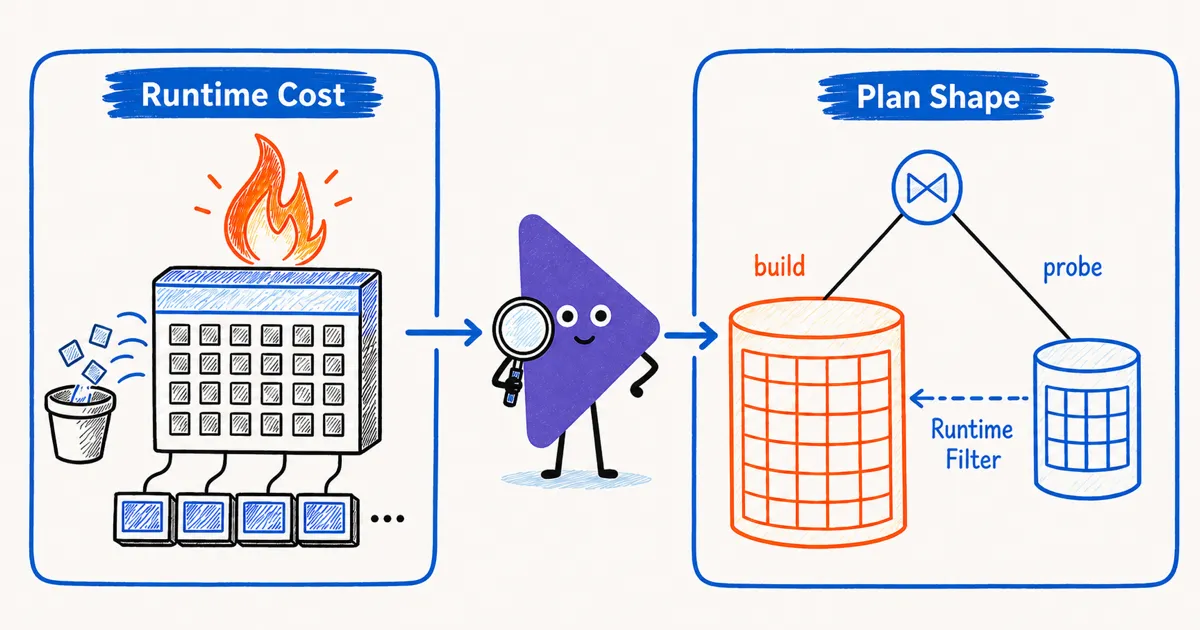
仅仅定位最耗时的算子容易导致诊断停留在表象。例如,哈希表构建耗时过高,根本原因往往是 Join 顺序不当(如将大表误置于 Build 侧)。若仅报告算子耗时,给出的优化建议只能是“增加内存”或“开启 Spill”,属于治标不治本。
对此,Skill 增加了针对 Join 执行计划形状的校验机制:
- 校验 Join 的 Build/Probe 侧划分;
- 校验 Runtime Filter 的生成与作用节点;
- 校验高选择性分支的优先计算顺序。
针对“为产出高过滤率 Runtime Filter 而导致源侧超大表扫描”等隐蔽误诊,Doris Skill 引入判例机制,将典型误诊场景转化为规则约束,从根源规避“推理合理但非根因”的建议。
从单点结论到完整调查
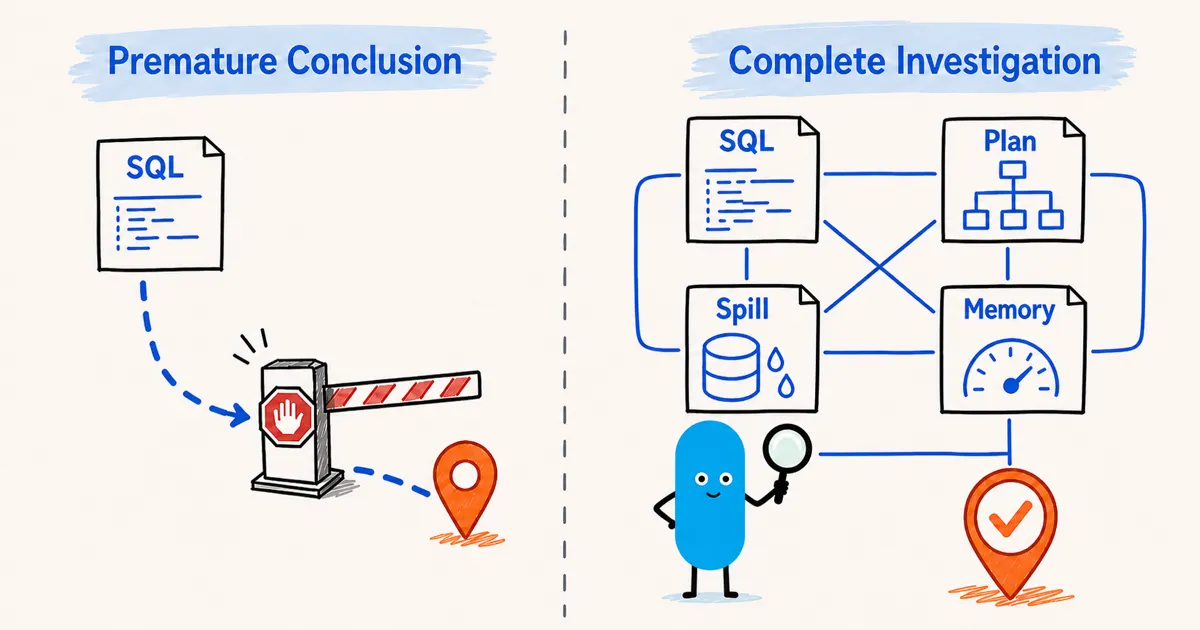
为防止 AI 在发现单一可疑点后即终止排查,Doris Skill 建立了强约束机制:在未完成指定前置校验前,禁止直接输出定性结论。例如:
- 未在 SQL 及物理计划中排查
SPLIT_BY_STRING或正则匹配等高 CPU 消耗表达式前,不得将慢 Insert 归因于“数据量过大”; - 未评估聚合状态大小、表达式物化、Spill 状态及内存上限前,不得将 OOM 简单归因于“Join 数据膨胀”。
通过规则强制补齐调查路径,确保证据链的严密性与完整性。
从分析正确到方案可信
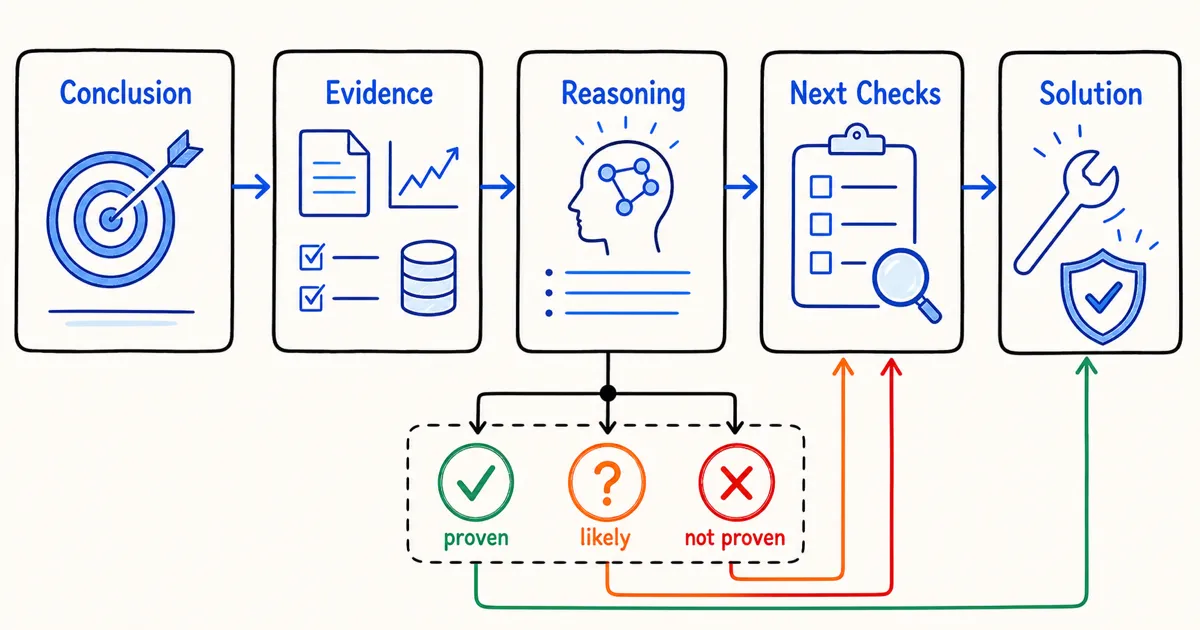
doris-profile-reader 统一采用严谨的标准格式输出结论:
Conclusion(结论) → Evidence(证据) → Reasoning(推理) → Next checks(下一步排查) → Solution(方案)
同时,在可信度控制方面,Doris Skill 采用一套保守而严谨策略:
- 显示标注:所有引用的计时指标均需显式标注类型及置信度等级(
proven/likely/not proven); - 分级输出:仅当 Profile 提供充分证据或精准匹配已知已知模式时,才输出确切修复方案;证据不足时,强制将建议下沉
Next checks,防止 AI 给出高确定性的误导建议。
三、结语
区分指标的证据效力、从运行时开销回溯计划形状、补齐严密的调查链路,以及严格控制结论置信度,构成了 doris-profile-reader 排查 Profile 的核心逻辑。其最终目标是将专家经验中的内核知识与边界条件,转化为 Agent 可稳定执行、且可在真实集群中验证的工程化规则。
目前,上述能力已在 apache/doris-skills 仓库开源,仓库包含以下核心模块:
doris-profile-reader: Profile 智能诊断与分析;doris-best-practices:覆盖表结构设计、容量规划与查询优化最佳实践;doris-architecture-advisor:基于业务工作负载提供架构选型与评估建议;doris-debug:覆盖查询、数据导入、Compaction、节点状态及物化视图等生产级故障排查。
上述 Skills 均采用开放的 Agent Skills 标准格式,适配多种 Agent 框架与运维工具。
安装与使用:
npx skills add apache/doris-skills