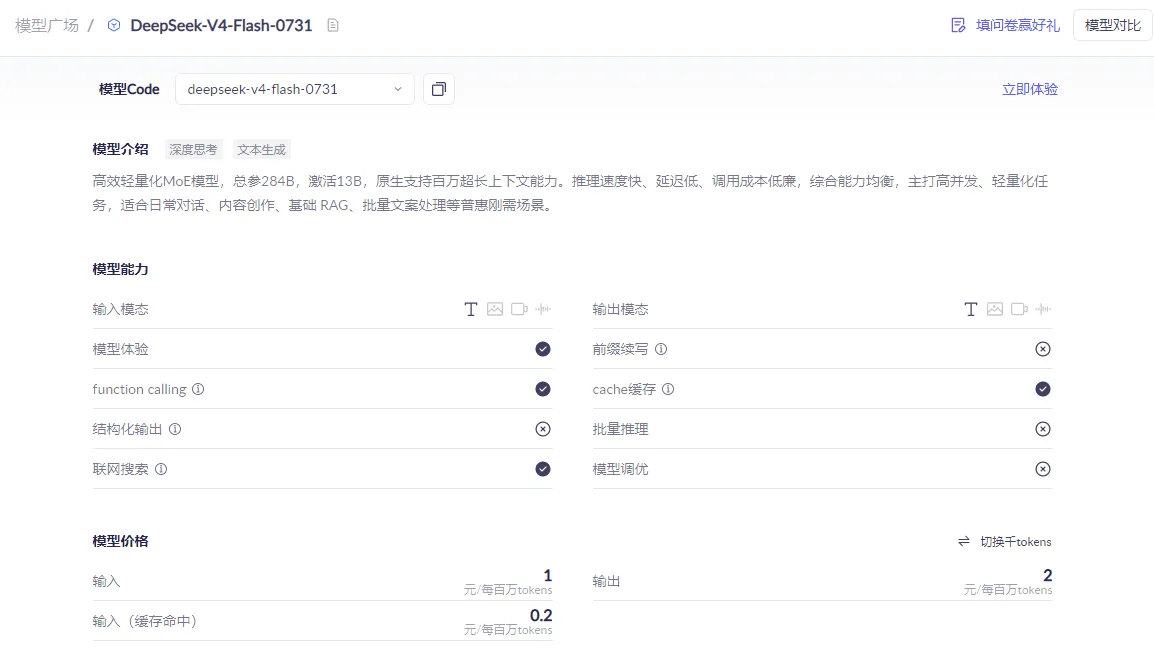
阿里云百炼deepseek-v4-flash模型是高效轻量化MoE模型,总参284B,激活13B,原生支持百万超长上下文能力。推理速度快、延迟低、调用成本低廉,综合能力均衡,主打高并发、轻量化任务,适合日常对话、内容创作、基础 RAG、批量文案处理等普惠刚需场景。该模型对应深度求索的 DeepSeek-V4-Flash 预览版(deepseek-v4-flash-preview),正式版请使用 deepseek-v4-flash-0731。
一、阿里云百炼 DeepSeek-V4-Flash 模型是什么?
DeepSeek-V4-Flash 是由深度求索(DeepSeek)研发、并通过 阿里云大模型服务平台百炼(Model Studio / Bailian) 提供推理服务的一款高效轻量化混合专家(MoE)大语言模型。
该模型包含两个主要版本:
- 预览版:
deepseek-v4-flash-preview - 正式稳定版(推荐使用):
deepseek-v4-flash-0731
此外,还存在面向国际区域优化的变体 deepseek-v4-flash-us,其能力与主版本一致,但部署节点位于美国等海外区域。
该模型由阿里云百炼平台托管,用户无需自行部署,可通过标准化 API 接口直接调用,支持 OpenAI 兼容协议,便于集成到现有 AI 应用生态中。
二、模型能力
1、华北2(北京)
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Text | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 不支持 | 联网搜索 | 支持 |
| 前缀续写 | 不支持 | 上下文缓存 | 支持 |
| 批量推理 | 不支持 | 模型调优 | 不支持 |
2、新加坡
部署范围:国际
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Text | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 不支持 | 联网搜索 | 支持 |
| 前缀续写 | 不支持 | 上下文缓存 | 支持 |
| 批量推理 | 不支持 | 模型调优 | 不支持 |
3、德国(法兰克福)
部署范围:全球
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Text | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 不支持 | 联网搜索 | 不支持 |
| 前缀续写 | 不支持 | 上下文缓存 | 支持 |
| 批量推理 | 不支持 | 模型调优 | 不支持 |
4、美国(弗吉尼亚)
部署范围:全球
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Text | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 不支持 | 联网搜索 | 不支持 |
| 前缀续写 | 不支持 | 上下文缓存 | 支持 |
| 批量推理 | 不支持 | 模型调优 | 不支持 |
5、日本(东京)
部署范围:全球
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Text | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 不支持 | 联网搜索 | 支持 |
| 前缀续写 | 不支持 | 上下文缓存 | 支持 |
| 批量推理 | 不支持 | 模型调优 | 不支持 |
三、上下文限制
| 参数 | 值 | 参数 | 值 |
|---|---|---|---|
| 最大输入长度 | 1000000 | 最大输出长度 | 393216 |
| 上下文长度 | 1000000 |
四、模型价格
本文仅展示模型调用原价,不包含限时优惠等活动信息,请前往阿里云百炼平台:https://www.aliyun.com/product/bailian 查看活动优惠。
1、华北2(北京)
| 计费项 | 价格(元) | 单位 |
|---|---|---|
| 输入 | 1 | 每百万tokens |
| 输出 | 2 | 每百万tokens |
| 输入(缓存命中) | 0.2 | 每百万tokens |
2、新加坡
部署范围:国际
| 计费项 | 价格(元) | 单位 |
|---|---|---|
| 输入 | 1.499 | 每百万tokens |
| 输出 | 2.998 | 每百万tokens |
| 输入(缓存命中) | 0.3 | 每百万tokens |
3、德国(法兰克福)
部署范围:全球
| 计费项 | 价格(元) | 单位 |
|---|---|---|
| 输入 | 1 | 每百万tokens |
| 输出 | 2 | 每百万tokens |
| 输入(缓存命中) | 0.2 | 每百万tokens |
4、美国(弗吉尼亚)
部署范围:全球
| 计费项 | 价格(元) | 单位 |
|---|---|---|
| 输入 | 1 | 每百万tokens |
| 输出 | 2 | 每百万tokens |
| 输入(缓存命中) | 0.2 | 每百万tokens |
5、日本(东京)
部署范围:全球
| 计费项 | 价格(元) | 单位 |
|---|---|---|
| 输入 | 1 | 每百万tokens |
| 输出 | 2 | 每百万tokens |
| 输入(缓存命中) | 0.2 | 每百万tokens |
五、限流
1、华北2(北京)
| 参数 | 值 |
|---|---|
| RPM(每分钟请求数) | 15000 |
| TPM(每分钟tokens) | 1,200,000 |
2、新加坡
部署范围:国际
| 参数 | 值 |
|---|---|
| RPM(每分钟请求数) | 10000 |
| TPM(每分钟tokens) | 1,200,000 |
3、德国(法兰克福)
部署范围:全球
| 参数 | 值 |
|---|---|
| RPM(每分钟请求数) | 15000 |
| TPM(每分钟tokens) | 1,200,000 |
4、美国(弗吉尼亚)
部署范围:全球
| 参数 | 值 |
|---|---|
| RPM(每分钟请求数) | 10000 |
| TPM(每分钟tokens) | 1,200,000 |
5、日本(东京)
部署范围:全球
| 参数 | 值 |
|---|---|
| RPM(每分钟请求数) | 10000 |
| TPM(每分钟tokens) | 1,200,000 |
六、快照版本
高效轻量化MoE模型,总参284B,激活13B,原生支持百万超长上下文能力。推理速度快、延迟低、调用成本低廉,综合能力均衡,主打高并发、轻量化任务,适合日常对话、内容创作、基础 RAG、批量文案处理等普惠刚需场景。该版本对应深度求索正式发布的 DeepSeek-V4-Flash(2026年7月31日版本),为当前推荐使用的稳定版本。
1、华北2(北京)
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Text | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 不支持 | 联网搜索 | 支持 |
| 前缀续写 | 不支持 | 上下文缓存 | 支持 |
| 批量推理 | 不支持 | 模型调优 | 不支持 |
2、新加坡
部署范围:国际
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Text | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 不支持 | 联网搜索 | 支持 |
| 前缀续写 | 不支持 | 上下文缓存 | 支持 |
| 批量推理 | 不支持 | 模型调优 | 不支持 |
3、德国(法兰克福)
部署范围:全球
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Text | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 不支持 | 联网搜索 | 支持 |
| 前缀续写 | 不支持 | 上下文缓存 | 支持 |
| 批量推理 | 不支持 | 模型调优 | 不支持 |
4、美国(弗吉尼亚)
部署范围:全球
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Text | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 不支持 | 联网搜索 | 支持 |
| 前缀续写 | 不支持 | 上下文缓存 | 支持 |
| 批量推理 | 不支持 | 模型调优 | 不支持 |
5、日本(东京)
部署范围:全球
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Text | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 不支持 | 联网搜索 | 支持 |
| 前缀续写 | 不支持 | 上下文缓存 | 支持 |
| 批量推理 | 不支持 | 模型调优 | 不支持 |
七、DeepSeek-V4-Flash 模型的特点和适用场景
(1)核心特点
| 特性 | 说明 |
|---|---|
| 模型架构 | 高效轻量化 MoE(Mixture of Experts)结构,总参数量 284B,激活参数仅 13B,兼顾性能与成本 |
| 上下文能力 | 原生支持 百万级上下文长度(1,000,000 tokens),最大输出长度达 393,216 tokens |
| 推理性能 | 推理速度快、延迟低,适合高并发请求场景 |
| 功能支持 | 支持多轮对话、Function Calling、联网搜索、上下文缓存;不支持结构化输出与前缀续写 |
| 计费模式 | 按输入/输出 token 数计费,华北2(北京)区域价格为: • 输入:1 元/百万 tokens • 输出:2 元/百万 tokens • 缓存命中输入:0.2 元/百万 tokens |
| 限流策略 | 华北2区域 RPM(每分钟请求数)上限为 15,000,TPM(每分钟 tokens)上限为 1,200,000 |
注意:部分区域(如新加坡)价格略高,且德国、美国弗吉尼亚等节点在早期版本中不支持联网搜索,但在
deepseek-v4-flash-0731快照版本中已全面支持。
(2)适用场景
根据官方描述,DeepSeek-V4-Flash 定位为“普惠刚需型”模型,特别适合以下场景:
- 日常对话交互
- 内容创作(如文案生成、社交媒体内容)
- 基础 RAG(检索增强生成)应用
- 批量文本处理任务(如摘要、改写、分类)
- 对成本敏感但需百万上下文能力的轻量级 Agent 应用
相较于更强大的
deepseek-v4-pro(擅长编程、数学),V4-Flash 更强调性价比与高吞吐能力,适合非复杂推理的规模化部署。
八、通过 OpenAI SDK 或 OpenAI 兼容 HTTP 方式快速体验 DeepSeek-V4-Flash 的具体流程
阿里云百炼平台为 DeepSeek-V4-Flash 提供了完整的 OpenAI 兼容接口,可直接使用标准 OpenAI SDK 调用。
步骤 1:准备工作
- 开通阿里云账号 并完成实名认证。
- 进入百炼控制台,创建或选择一个工作空间(Workspace)。
- 获取 API Key:在百炼控制台的“API 密钥管理”中生成专属密钥。
步骤 2:确定调用端点(Base URL)
Base URL 格式依赖于所选地域。以 华北2(北京) 为例:
https://{WorkspaceId}.cn-beijing.maas.aliyuncs.com/compatible-mode/v1
其中 {WorkspaceId} 需替换为您实际的工作空间 ID。
其他区域示例:
- 新加坡:
ap-southeast-1- 美国弗吉尼亚:
us-east-1- 德国法兰克福:
eu-central-1
步骤 3:配置 OpenAI SDK(以 Python 为例)
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_BAILIAN_API_KEY",  # 替换为您的百炼 API Key
    base_url="https://YOUR_WORKSPACE_ID.cn-beijing.maas.aliyuncs.com/compatible-mode/v1"
)

response = client.chat.completions.create(
    model="deepseek-v4-flash-0731",  # 推荐使用正式版快照
    messages=[
        {
   "role": "user", "content": "你好,请介绍一下你自己。"}
    ],
    max_tokens=500
)

print(response.choices[0].message.content)
步骤 4:验证功能(可选)
- 如需使用 联网搜索,确保在支持该能力的区域(如北京、新加坡、东京)调用,并确认使用的是
deepseek-v4-flash-0731或更新版本。 - 可通过设置
enable_thinking=True(若平台支持)启用深度思考模式,适用于复杂信息整合任务。
步骤 5:监控与计费
- 调用后费用按 token 实时扣款,出账周期为分钟级。
- 可在阿里云 费用中心 > 账单详情 中查看消费明细。
- 新用户享有 100 万免费 tokens(180 天内有效),可用于初步测试。
重要提醒:
- 模型 ID 必须准确填写为
deepseek-v4-flash-0731(推荐)或deepseek-v4-flash。- 若返回错误,请检查工作空间是否已部署该模型,或联系百炼技术支持。
- 不同区域的功能支持存在差异,建议优先选择 华北2(北京) 以获得完整能力。
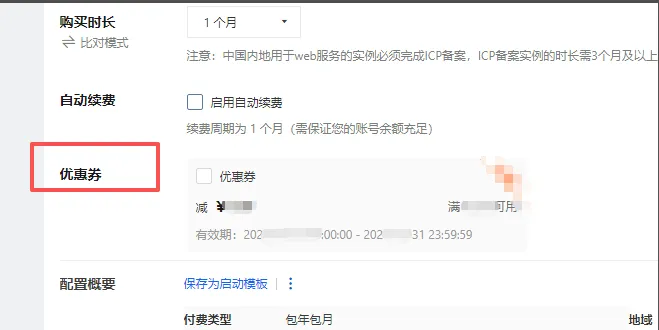
友情提示:购买之前,别忘了先领优惠券:
https://t.alivun.com/U/a23cv1 领了之后再买活动中的云产品,可以享受折上折。
整体来看,阿里云百炼托管的DeepSeek-V4-Flash凭借284B总参、仅13B激活的轻量化MoE架构,实现了百万级超长上下文、低延迟高吞吐与低成本的平衡,同时覆盖国内华北2及新加坡、法兰克福等全球多区域节点,适配不同地域的业务合规需求。它完美承接日常对话、基础RAG、批量文案处理等普惠刚需场景,支持OpenAI兼容协议可快速接入现有生态,搭配高并发限流能力与低至0.2元/百万Tokens的缓存计费,是当前高性价比轻量化大模型的优选,开发者可前往阿里云百炼平台结合实时优惠快速落地相关应用。