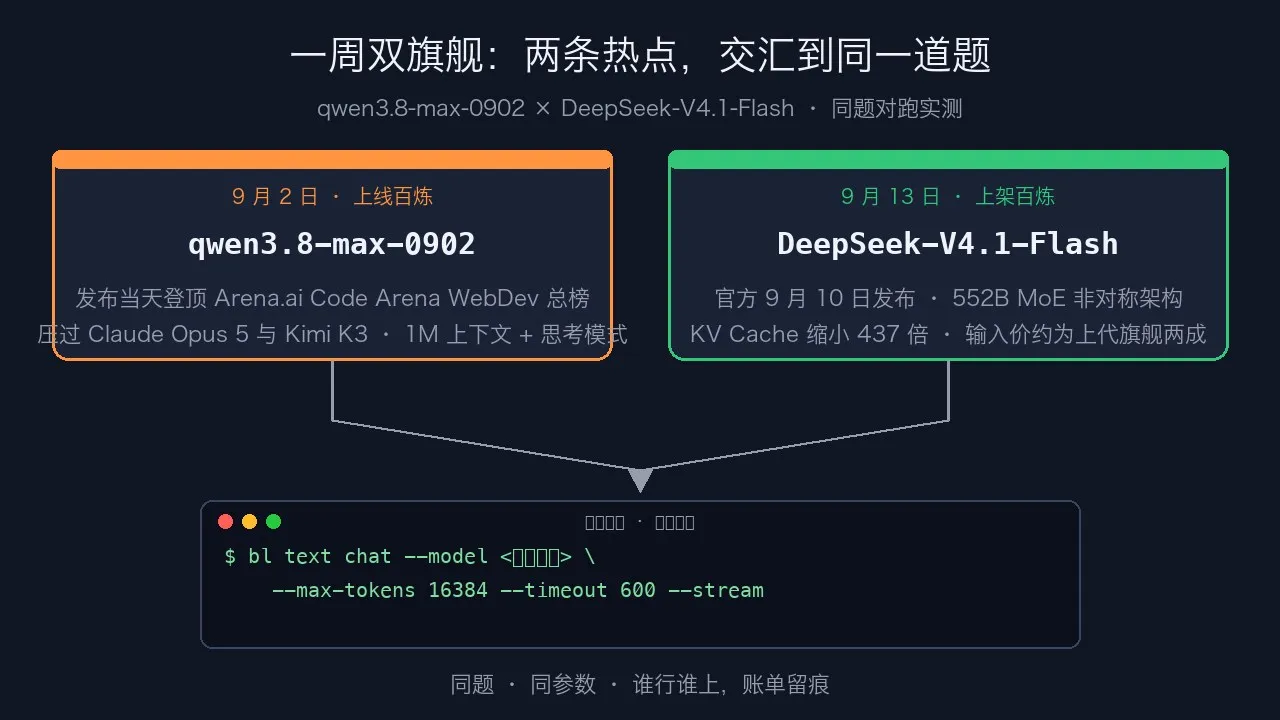
九月上半月,百炼的模型目录在一周之内多了两个有分量的新条目。9 月 2 日,qwen3.8-max 的快照版本 0902 上线三站同步(国内/国际/全球),官方口径主打编码深度再突破与协作智能体能力增强,发布当天在 Arena.ai 的 Code Arena WebDev 前端编程总榜登顶,超过 Claude Opus 5 与 Kimi K3。9 月 13 日,DeepSeek-V4.1-Flash 上架百炼(官方 9 月 10 日发布),552B MoE 非对称架构、KV Cache 相对初代缩小 437 倍、1M 上下文加 384K 最大输出,开源同步放到了 HuggingFace。
两个条目都带 100 万 token 免费额度(0902 至 12 月 1 日、V4.1-Flash 至 12 月 13 日),这轮同题实测全程零元跑完。本文记录的是把它们放进同一条调用链做对跑的结果,视角放在开发者实际用起来的那一层。
动态别名先行:默认模型零操作升级
实测第一个值得记录的机制:bl text chat 不带 --model 的默认调用,返回 model 字段是 qwen3.8-max。这是动态别名而非快照名,官方快照机制是别名自动滚到最新快照,也就是说存量用户不做任何操作,默认模型已经换成了 0902。副作用是从返回结果里分辨不出快照版本,要锁定版本必须显式 --model qwen3.8-max-0902,带日期的全名在百炼控制台「模型」页每个卡片的「最新版本」一栏:
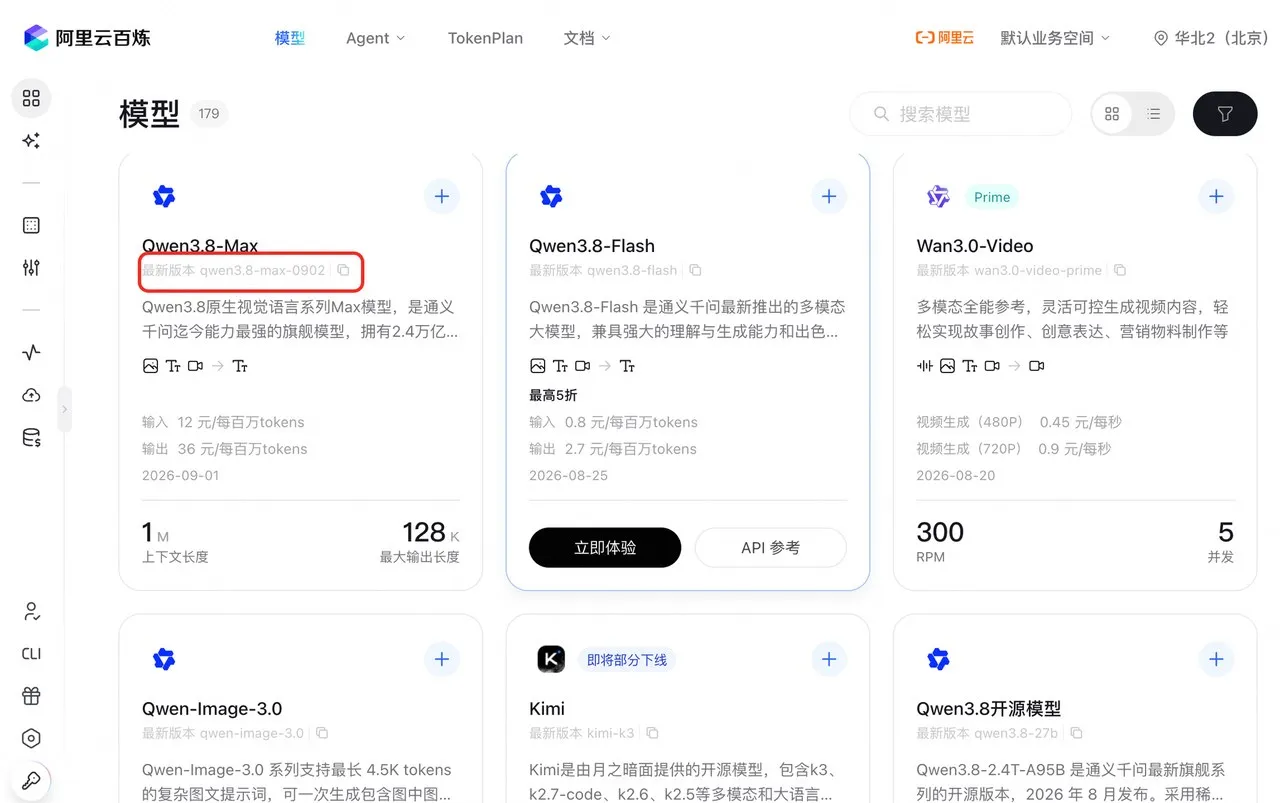
顺带两条实测口径:同题走别名和显式快照两个入口,输入 token 逐位一致(76 对 76),未观测到额外开销;默认调用带思考(reasoning_tokens 27 / 33)且计入输出计费,qwen3.8-max 默认走思考模式。
同题对跑:max-tokens 的两种语义
对跑题目是单文件深色科技风落地页,需求写死,发给两个模型的题面一字不差:
用单个 HTML 文件(内嵌 CSS 和 JS)实现一个深色科技风的落地页:顶部导航(logo 加三个锚点链接);hero 区大标题带打字机逐字出现动画,副标题淡入;三张功能卡片网格排列,鼠标悬停时上浮并加发光边框;页脚一行版权。中文文案自拟,不依赖任何外部资源,保存后浏览器直接打开即可运行。只输出完整 HTML 代码。
出题理由:0902 登顶的榜考的就是前端编程,前端题验货最对症;需求写死两个模型题面一字不差;几百行代码的量级让行为差异、计费、长任务坑全藏不住。核心发现如下。
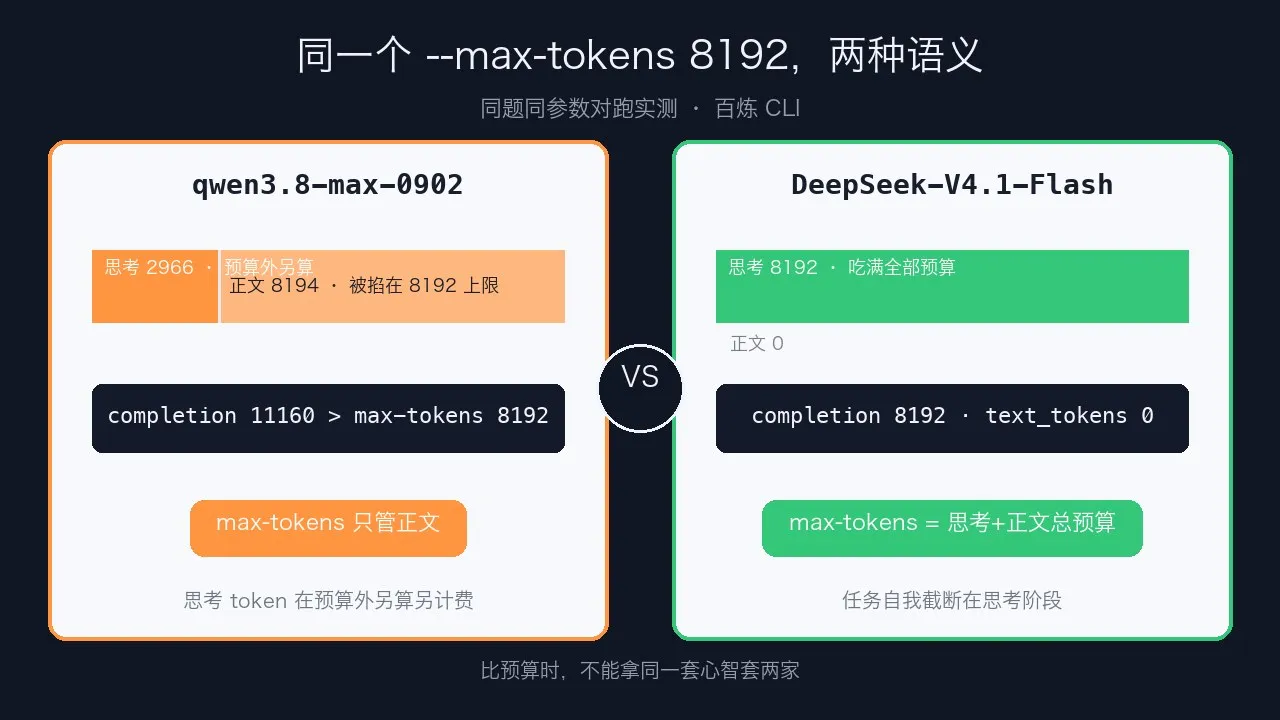
8192 预算下,0902 的 completion 是 11160(思考 2966 + 正文 8194,finish_reason length):max-tokens 只管正文,思考在预算外另算。V4.1-Flash 的 completion 是 8192 全部为思考、正文零输出:max-tokens 是思考加正文的总预算。同一个参数两套语义,比预算时不能拿同一套心智套两家。
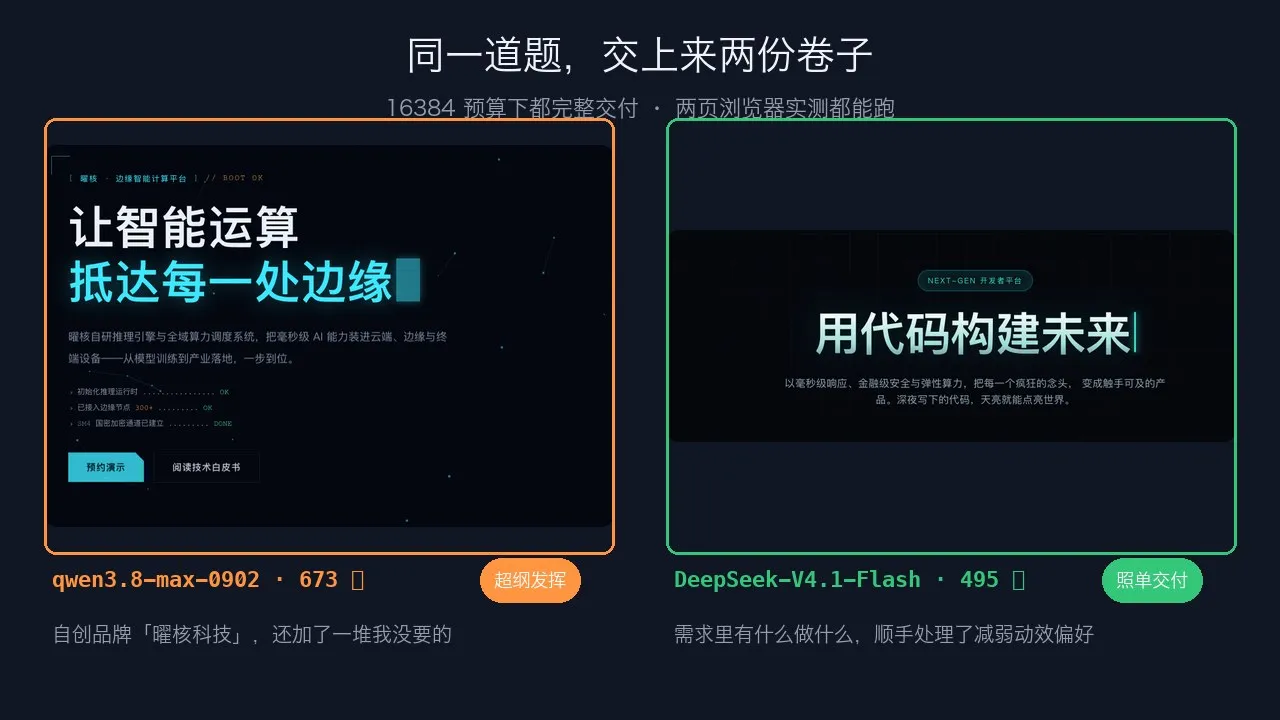
16384 预算下两家都完整交付。V4.1-Flash 495 行带 </html>,严守需求清单并处理了 prefers-reduced-motion;0902 走流式拿到 673 行,自创品牌、数据指标条、滚动导航高亮,丰富度超出需求清单。终态逐维度对比:
| 维度 | qwen3.8-max-0902 | DeepSeek-V4.1-Flash |
|---|---|---|
| 思考 token | 2966(英文) | 5068(中文) |
| 正文 token | ≈11,300 | 4364 |
| 产物规模 | 673 行 / 29,058 字符 | 495 行 / 12,036 字符 |
| 风格取向 | 超需求发挥 | 严守清单 |
| 生成耗时 | 8K 版约 3-4 分钟,16K 非流式撞 headers timeout | 16K 约 2 分钟 |
耗时差异值得单独记:同题同预算,0902 的生成时间约为 V4.1-Flash 的两倍,旗舰推理优先与轻量吞吐优先的体感差异就在这几分钟里,批量任务里会被放大。
长任务参数上有三个坑一并记录(全部实测复现)。先把归属说清:不在装百炼 CLI,装是一句话的事;坑全在「让模型一口气写几百行代码」的长任务调用环节,三坑递进:第一个把等待时间调够(约一分钟就自己退,一行 Request timed out,默认超时按普通问答设计,必须显式 --timeout 600);第二个发现调够了还会断(UND_ERR_HEADERS_TIMEOUT,Node 底层网络库等响应头的超时约 300 秒,--timeout 管不到它,加 --stream 绕开);第三个是断解决了、账没了(流式输出不带 usage 统计,账单只在完整响应的 JSON 里,要 token 账走非流式 --output json)。0902 侧长任务的最终命令形态:
bl text chat --model qwen3.8-max-0902 --max-tokens 16384 --timeout 600 --stream \
  --message "<任务>"
一道小题的思考模式对照
对跑之外补了一道优惠券小题(A 满 300 减 50 / B 满 200 打 85 折 / C 无门槛减 10,购物车 280 元限用一张),两家都选对了 B 券 238 元,但思考环节的形态差异值得单独记录:0902 显式 --enable-thinking 后思考 749 字符全程英文(开头是 "We need answer in Chinese..."),答案是中文;V4.1-Flash 默认思考,233 字符全程中文,答案还把关键数字加粗了。下游链路要解析思考流的话,这个语言差异直接影响处理逻辑。
思考长度也在随任务复杂度伸缩:简单题 V4.1-Flash 更省(154 对 313 token),复杂编程题反超(5068 对 2966),弹性比 0902 大。做预算估算时按题型的两极各测一次,比拍一个固定系数稳。
价目与分工
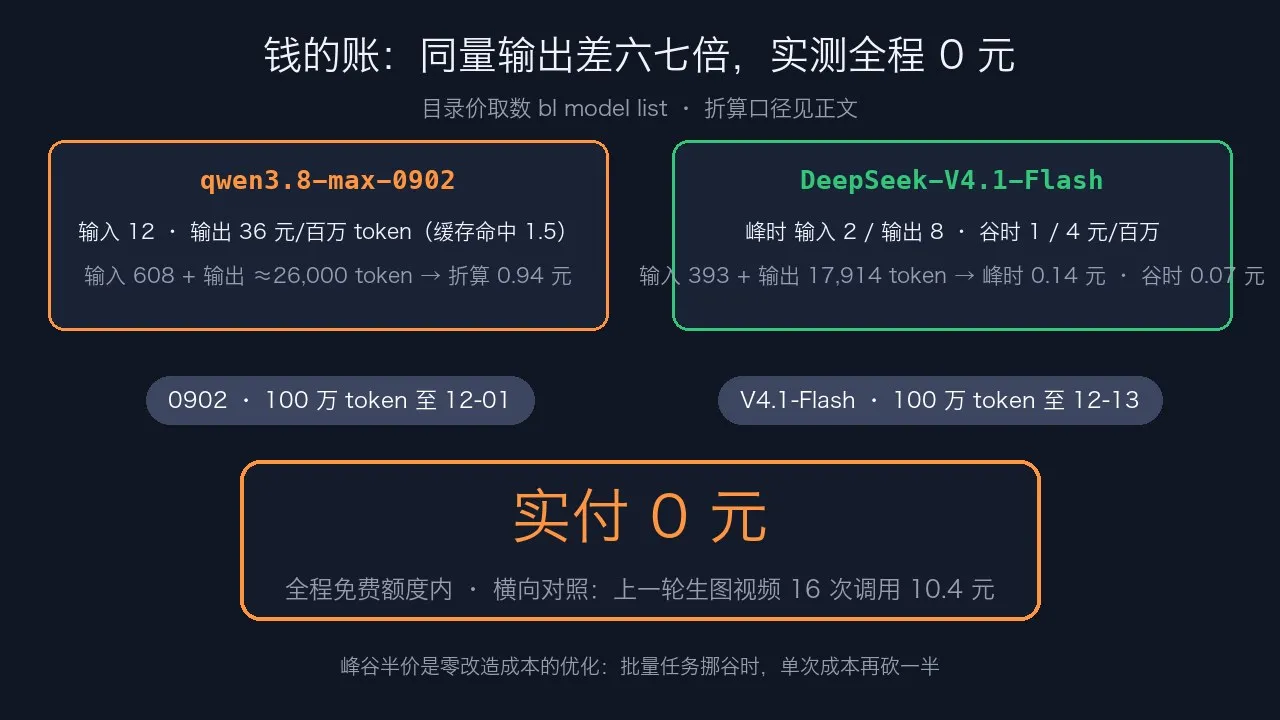
CLI 侧现场取数(bl model list):0902 输入 12 / 输出 36 元每百万(缓存命中 1.5),1M 上下文、131,072 输出上限;deepseek-v4.1-flash 输入峰 2 谷 1、输出峰 8 谷 4 元每百万,1M 上下文、393,216 输出上限。输出上限差三倍是 API 层硬校验(--max-tokens 200000 下 0902 报 HTTP 400 且给出范围 [1, 131072],V4.1-Flash 正常接受)。
全程实测账:0902 输入 608 / 输出约 26000 token 折算 0.94 元,V4.1-Flash 输入 393 / 输出 17914 token 峰时折算 0.14 元,实际付费 0 元(免费额度内)。一个容易误判的细节:A 组跑完两次调用(合计 311 token),bl usage free 显示 0902 剩余 991,263,纹丝不动,面板不是实时结算,单次成本以响应里的 usage 字段为准。同量级输出 V4.1-Flash 峰时价为 0902 的 22%,谷时再半价。
落到用法上,这轮对跑支撑的分工是:批量生成与草稿走 V4.1-Flash,关键交付走 0902。两个模型的免费额度都在 12 月到期,现在正是把两个新条目都过一遍的窗口期。
最后一提数据口径:有社区解读文称 0902 输入 2 / 输出 6 元,与模型目录及 CLI 现场取数(12 / 36)差 6 倍,另有「每次请求 +38 token」的说法实测零复现。写成本模型前建议用 bl model list --model qwen3.8-max 自行核对,CLI 取数与计费口径一致。
百炼 CLI 装进 coding agent 的路径:一行命令安装,API Key 免费领。装好之后,同题对跑就是一句话的事,评论区说一个你想跑的题,我挑几条帮你跑出来。