
一、通义千问大模型家族全景与核心定位
阿里云通义千问大模型是面向全场景的通用与专业AI基座,覆盖从轻量化多模态到超大规模旗舰的完整产品矩阵,核心定位从基础对话助手升级为全链路智能体基座,可独立完成复杂任务、长周期执行与多模态交互,支撑个人办公、企业服务、科研开发、AI应用落地等多元场景。
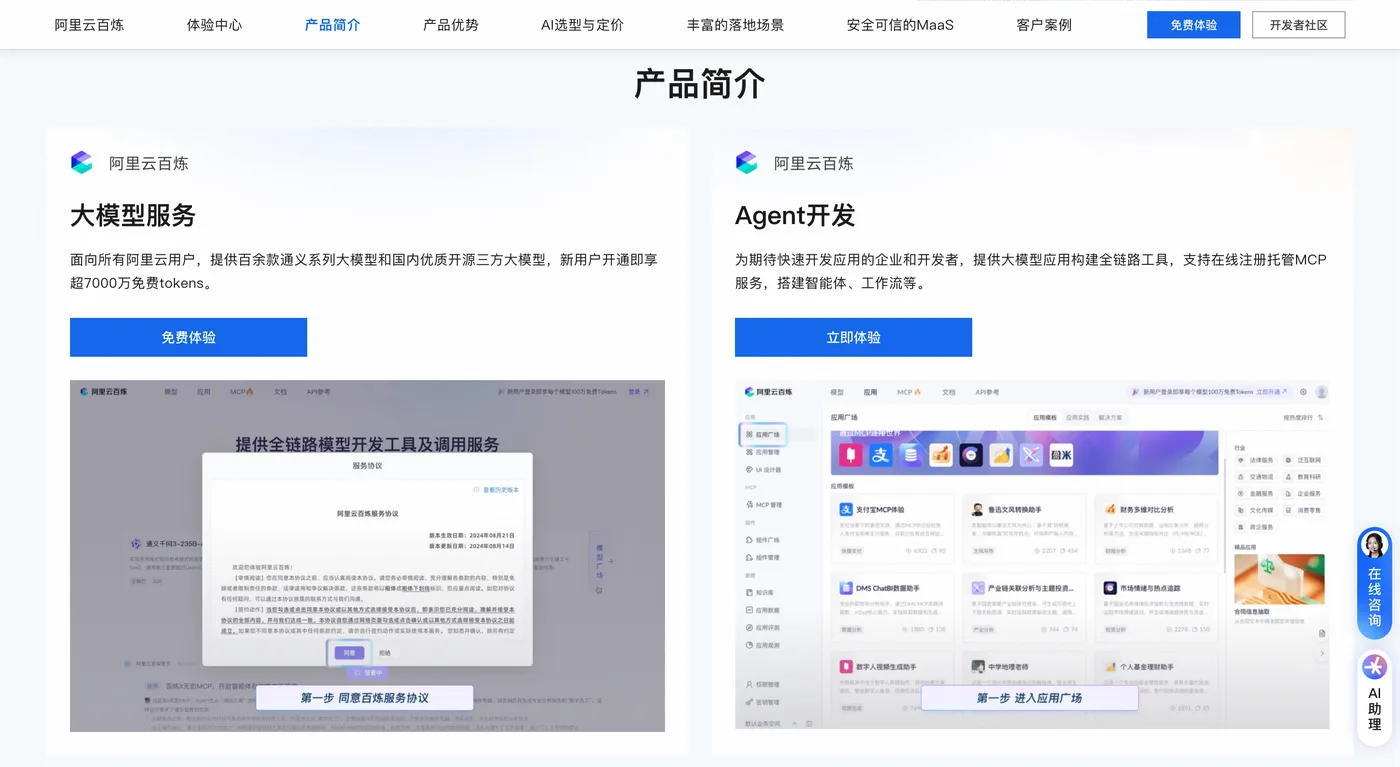
当前通义千问核心模型包括Qwen3.5-Omni、Qwen3.7-Max、Qwen3.8-Max、Qwen-Long、Qwen3-VL轻量化系列等,形成梯度化能力布局:轻量化模型主打低门槛、高性价比,适配边缘部署与轻量应用;旗舰模型聚焦超强算力、长上下文与复杂任务处理,支撑企业级AI与科研级需求;多模态模型打通文本、图像、音频、视频全模态交互,实现物理世界与数字世界的智能连接。详情👉访问阿里云百炼大模型服务平台页面 了解。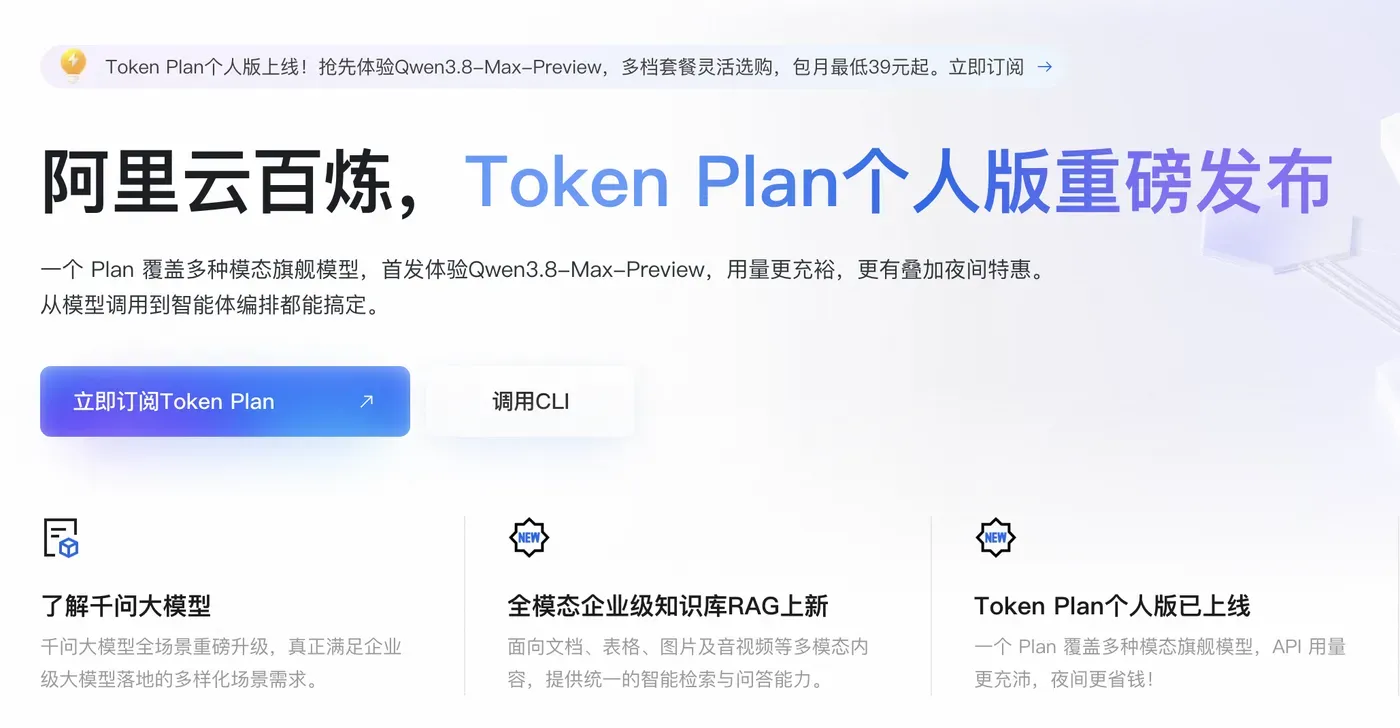
二、核心旗舰模型:Qwen3.8-Max功能深度解析
Qwen3.8-Max是通义千问家族最新旗舰,总参数量达2.4万亿,采用第三代稀疏MoE混合专家架构,推理时仅激活95B有效参数,在保持超大模型能力的同时大幅降低算力消耗与推理成本。其核心功能突破集中在五大维度:
(一)超长上下文处理:100万Token极限承载
Qwen3.8-Max支持近100万Token的上下文窗口,可一次性完整解析整本白皮书、长篇合同、整套代码工程、200页以上财报与复杂PDF,无需分段处理。通过文件上传与引用机制,用户可直接上传文档并在对话中调用,模型能跨页面提取文字、图表与版面信息,整理为结构化报告或网页,彻底解决长文档处理的碎片化难题。
(二)自主编程与代码执行:无人工介入长程开发
编程能力实现质的飞跃,支持无人工介入长程自动编程,可连续执行500轮以上设计任务,写7600行代码复现科研论文,提出18种方案优化算法逻辑。内置Code Interpreter代码执行引擎,支持Python、Java、C++等主流语言,可直接运行代码、调试错误、生成可视化结果,在PaperBench科研复现评测中得分93.0,较上代提升28.2分,超越国际顶尖模型。
(三)原生多模态交互:视听图文全链路理解
原生支持文本、图像、音频、视频多模态输入输出,可处理100小时以上长视频,围绕人物、事件、时间构建视频记忆,追踪剧情发展与人物关系。视觉理解能力覆盖OCR、图像生成、户型图转3D模型、截图生成前端项目等场景;音频能力支持113种语言实时转写、语音克隆与情感合成,解决语音输出漏字、错读问题。
(四)长周期智能体执行:跨框架自主完成复杂任务
作为全能智能体基座,支持长周期自主执行与跨框架泛化,可独立完成办公自动化、数据处理、项目管理等多步骤真实业务任务。内置工具调用、任务规划、自我修正能力,能调用外部API、操作数据库、生成报表,适配主流Agent框架集成,实现从“被动响应”到“主动执行”的转变。
(五)低幻觉与高可靠性:专业场景精准输出
幻觉生成率较上代降低62%,在专业领域问答、科研数据处理、法律文档分析等场景中输出更精准、可靠。支持系统提示词深度定制,可精准设定模型角色、风格与输出格式,满足企业级合规与个性化需求。
三、核心功能矩阵:全场景能力覆盖
(一)长文本处理:Qwen-Long突破百万Token限制
Qwen-Long专注超长文本场景,提供1000万Token上下文长度,是处理大规模文档、知识库、代码库的专属模型。支持PDF、Word、TXT、Markdown等多种格式上传,通过file-id机制关联文档内容,API调用时自动计入Token消耗,适合法律合同审查、学术论文分析、企业知识库管理等场景。
(二)多模态轻量化:Qwen3-VL 4B/8B普惠部署
Qwen3-VL轻量化系列推出4B与8B参数版本,在保持核心多模态能力的同时,大幅降低显存占用与部署门槛。在STEM问答、视觉理解、OCR、视频解析等30项权威测评中取得SOTA成绩,性能超越同级别国际顶尖模型,适合移动端、边缘设备与低成本AI应用部署。
(三)全模态交互:Qwen3.5-Omni视听融合体验
Qwen3.5-Omni是原生多模态模型,支持256K上下文,可处理10小时音频或1小时视频内容。采用混合注意力架构,实现视听信息深度融合,在215项全模态测试中斩获SOTA成绩;语音输出引入Aria技术,支持个性化语音克隆,覆盖113种语言,适合智能客服、视频内容分析、多语言交互场景。
(四)流式输出与实时交互:低延迟对话体验
全系列模型支持流式输出,用户可实时查看模型生成内容,无需等待完整响应,大幅提升交互流畅度。API调用时设置stream=true即可开启,支持Token消耗实时统计,方便成本管控与性能优化,适合实时对话、内容生成、代码补全等场景。
(五)工具调用与外部集成:生态开放能力
支持调用外部工具、API与数据库,可集成天气查询、数据计算、文件处理等功能,实现模型能力与外部服务的无缝衔接。兼容LangChain、AutoGPT等主流AI开发框架,支持自定义工具开发与部署,快速构建行业专属AI应用。详情👉访问阿里云百炼大模型服务平台页面 了解。
四、API调用实战:代码命令与部署指南
(一)环境准备与API Key配置
安装依赖库(Python)
# 安装OpenAI兼容库(阿里云百炼API兼容OpenAI接口)
pip install openai
# 安装DashScope官方SDK(可选,用于高级功能)
pip install dashscope
配置API Key(推荐环境变量,避免硬编码)
# Linux/macOS终端配置
export DASHSCOPE_API_KEY="你的阿里云百炼API Key"
# Windows命令行配置
set DASHSCOPE_API_KEY="你的阿里云百炼API Key"
(二)基础对话调用(Python)
import os
from openai import OpenAI

# 初始化客户端
client = OpenAI(
    api_key=os.environ.get("DASHSCOPE_API_KEY"),
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1"
)

# 发送对话请求
response = client.chat.completions.create(
    model="qwen3.8-max",  # 选择模型版本
    messages=[
        {
   "role": "system", "content": "你是一个专业的AI助手,精准回答用户问题。"},
        {
   "role": "user", "content": "请介绍通义千问Qwen3.8-Max的核心功能"}
    ],
    temperature=0.7,  # 控制输出随机性
    max_tokens=2000   # 最大输出长度
)

# 打印响应结果
print(response.choices[0].message.content)
(三)流式输出调用(实时响应)
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ.get("DASHSCOPE_API_KEY"),
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1"
)

# 发起流式请求
stream = client.chat.completions.create(
    model="qwen3.8-max",
    messages=[{
   "role": "user", "content": "帮我写一段Python代码实现冒泡排序"}],
    stream=True,
    stream_options={
   "include_usage": True}  # 包含Token消耗信息
)

# 实时处理流式响应
for chunk in stream:
    if chunk.choices[0].delta.content:
        print(chunk.choices[0].delta.content, end="")
(四)代码执行功能调用(Code Interpreter)
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ.get("DASHSCOPE_API_KEY"),
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1"
)

# 调用代码执行功能
response = client.chat.completions.create(
    model="qwen3.8-max",
    messages=[{
   "role": "user", "content": "计算123的21次方,并生成可视化结果"}],
    extra_body={

        "enable_code_interpreter": True,  # 开启代码执行
        "enable_thinking": True          # 开启思考模式
    },
    stream=True
)

# 输出结果与代码执行过程
for chunk in response:
    if chunk.choices[0].delta.content:
        print(chunk.choices[0].delta.content, end="")
(五)长文档处理调用(Qwen-Long)
import os
from dashscope import FileManagement, Generation
from dashscope.common.error import ApiError

# 1. 上传长文档
try:
    # 上传文件(支持PDF/Word/TXT等)
    upload_result = FileManagement.upload(
        api_key=os.environ.get("DASHSCOPE_API_KEY"),
        file_path="long_document.pdf",  # 本地文件路径
        purpose="document"
    )
    file_id = upload_result["data"]["file_id"]
    print(f"文件上传成功,file-id: {file_id}")
except ApiError as e:
    print(f"文件上传失败: {e}")

# 2. 调用Qwen-Long处理长文档
response = Generation.call(
    model="qwen-long",
    messages=[
        {
   "role": "system", "content": f"请分析文档内容,file_ids: [{file_id}]"},
        {
   "role": "user", "content": "总结这份文档的核心观点与关键数据"}
    ],
    api_key=os.environ.get("DASHSCOPE_API_KEY")
)

print(response.output["text"])
五、模型选型与场景适配指南
- 个人办公/轻量应用:优先选择Qwen3-VL 4B/8B或Qwen-Plus,低门槛、低成本,满足日常写作、数据处理、简单编程需求。
- 企业级服务/复杂对话:选择Qwen3.7-Max,平衡性能与成本,支持长上下文、多模态交互与基础智能体能力。
- 科研开发/长程编程:选择Qwen3.8-Max,超强编程能力、长周期执行与低幻觉,适配论文复现、算法开发、芯片设计等场景。
- 超长文档处理:专属选择Qwen-Long,1000万Token上下文,处理法律合同、学术论文、企业知识库等大规模文本。
- 多模态应用/视听交互:选择Qwen3.5-Omni,全模态理解与生成,适合视频分析、语音交互、图像生成等场景。
六、定价与成本优化策略
通义千问采用Token计费模式,输入与输出分别计价,支持按量付费与节省计划:
- Qwen3.8-Max:国内每百万Token输入12元、输出36元,隐式缓存命中1.5元。
- Qwen3.7-Max:国内每百万Token输入8元、输出24元,性价比突出。
- Qwen-Long:按实际处理Token数计费,长文档场景更划算。
- 轻量化模型:Qwen3-VL 4B/8B计费更低,适合普惠部署。
成本优化建议:
- 长期稳定使用:选择节省计划,锁定长期算力,降低30%-50%成本。
- 长文档处理:优先使用Qwen-Long,避免分段处理导致的Token重复消耗。
- 代码开发:开启隐式缓存,重复代码与查询可大幅降低费用。
- 轻量场景:选择轻量化模型,平衡性能与成本。
七、总结与未来展望
阿里云通义千问大模型已从单一对话模型进化为全场景智能体基座,Qwen3.8-Max的发布标志着国产大模型在超大参数、长上下文、自主编程、多模态交互等核心领域实现全面突破。从个人办公到企业服务,从科研开发到行业应用,通义千问构建了覆盖全链路的AI能力矩阵,通过开放API与生态集成,降低AI落地门槛,助力各行业数字化转型与智能化升级。
未来,通义千问将持续强化智能体能力、多模态融合与行业适配,推出更轻量化、更高性能的模型版本,进一步拓展长文本处理、代码生成、实时交互等核心能力边界,为用户提供更智能、更可靠、更普惠的AI服务。
