企业AI知识库的“工艺密码”:深度解析培训SaaS平台的智能调参与工程实践

简介: 在企业培训与知识管理领域,AI不再是锦上添花,而是核心引擎。BizLearnify的AI知识库功能,通过精细化的“切片-检索-生成”三层架构,将非结构化数据转化为可驱动智能问答、内容推荐的精准知识资产。

在阿里云技术社区中,关于大模型(LLM)与知识库结合的讨论已从“能否落地”转向“如何精耕细作”。与此同时,企业培训领域的知识库功能也在提出更高的需求。今天,我们将以BizLearnify平台的AI知识库功能为例,深入剖析其背后的技术逻辑。通过解读其精细化的配置面板,我们不仅能看到一款成熟SaaS产品的功力,更能洞察到构建高可用、高精度企业级AI应用的关键要素。
3 (1).png


一、 数据预处理的艺术:切片策略决定知识颗粒度

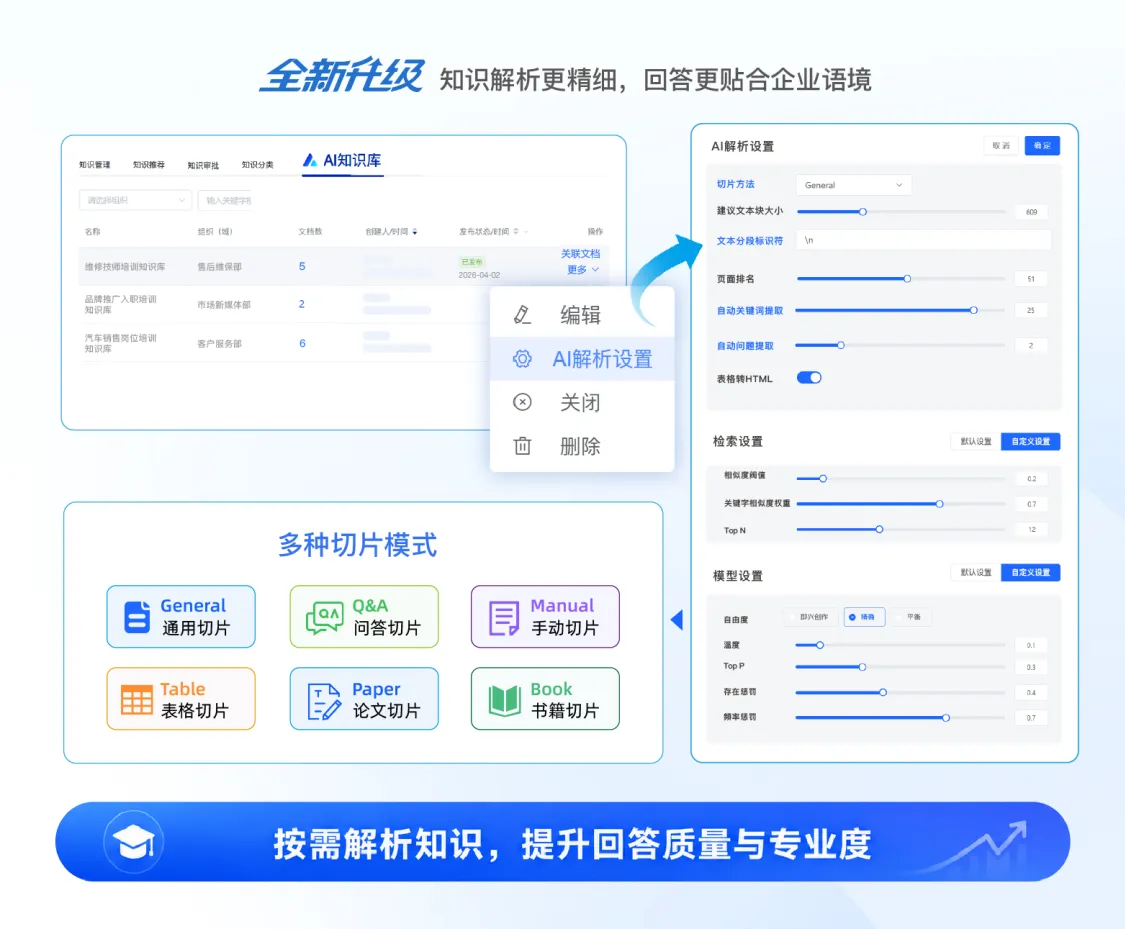
在AI读取企业文档前,切片(Chunking)是决定知识召回质量的第一步。系统提供了多维度的切片方法,这不仅是格式适配,更是语义单元的划分策略。对于技术手册(Manual)与法律条文(Laws),其段落结构与语义重点截然不同。企学宝允许根据文档类型选择特定切片逻辑包括 General(通用) Q&A(问答对)、Table(表格)、Paper(论文)、Book(书籍)、Laws(法律法规)等多种垂直领域的解析模式。


  • 技术深意: 不同的文档结构需要不同的处理逻辑。例如,Table 模式会将复杂的二维表格转换为Markdown或HTML格式,保留行列关系,避免模型产生幻觉;Laws 模式则可能基于条款层级进行切分,确保法律条文的完整性。
  • 精细化控制: 在通用模式下,用户可以自定义建议文本块大小(如2048 token)和文本分段标识符(如 \n)。这意味着管理员可以根据模型的上下文窗口(Context Window)大小,精准控制每个知识块的长度,既避免信息丢失,又防止噪声干扰。同时,自动关键词/问题提取功能,相当于在入库前为每个知识块打上了“语义标签”,极大地提升了后续检索的召回率。


二、 检索引擎的调校:在“大海捞针”与“精准匹配”间寻找平衡

知识被切分后,如何快速、精准地从海量知识块中找到最相关的内容?系统提供了默认设置与自定义设置两种模式,展现了其对不同业务场景的深刻理解。

  1. 相似度阈值(Similarity Threshold):可在 0.21 之间调节
  • 低阈值(如0.2): 意味着“宽进”,召回更多相关文档,适合头脑风暴或探索性查询,但可能引入噪声。
  • 高阈值(如0.8+): 意味着“严出”,只返回极高置信度的结果,适合合规查询或精确事实问答。
  1. 关键字相似度权重与Top N:典型的混合检索(Hybrid Search)策略。传统纯向量检索(语义)容易忽略精确的关键词匹配(如产品型号“ABC-123”)。通过调整“关键字相似度权重”与“语义向量权重”的配比,实现了业务术语的精确匹配。配合“Top N”(如30条)的召回数量设定,确保大模型有足够的上下文进行推理,同时限制不必要的算力消耗。


三、 模型生成的掌控力:温度与惩罚机制的博弈

这是决定AI输出风格的灵魂环节。系统不仅提供了温度、Top P等标准参数,还结合培训场景给出了即兴创作、精确、平衡三种预设自由度,极大降低了企业使用门槛。

  1. 即兴创作模式(高创造力):
  • 参数特征: 温度 1.0,Top P 1.0
  • 技术解读: 高温度让模型在预测下一个Token时更加“大胆”,概率分布更平坦;Top P为1意味着不进行核采样截断。
  • 应用场景: 适用于企业文化宣传文案生成、培训开场白设计、创意活动策划等需要发散思维的场景。
  1. 精确模式(高严谨性):
  • 参数特征: 温度 0.2,Top P 0.75,存在/频率惩罚适中。
  • 技术解读: 低温让模型变得“保守”,倾向于选择概率最高的词,输出稳定且确定性高。
  • 应用场景: 适用于制度查询、技术参数解答、合规性审查。此时,准确性高于一切,不允许AI“胡编乱造”。
  1. 平衡模式(兼顾体验与事实):
  • 参数特征: 温度 0.5,Top P 0.85
  • 技术解读: 这是一个折中方案。既保持了回答的通顺和自然(不至于像机器人),又控制了幻觉的产生。
  • 应用场景: 适用于日常员工助手、通用知识问答。

存在惩罚(Presence Penalty)频率惩罚(Frequency Penalty)是解决大模型“啰嗦”和“车轱辘话”的关键。在生成培训总结时,适当调高这两个值(如 0.5 - 1.0),可以迫使模型使用更丰富的词汇,避免反复重复同一个概念,提升阅读体验。


四、 总结:工程化落地价值

企学宝 AI 知识库的核心技术逻辑,是将通用 RAG 技术进行企业培训场景的深度定制,把 “黑盒式” 的 AI 能力拆解为高度可配置、可调控的透明模块,既保留了大模型的智能交互能力,又满足了企业对准确性、安全性、适配性的核心诉求。通过切片、检索、模型三层设置,让企业能够根据自身业务场景(如HR、销售、研发、客服)和知识类型(如制度、产品手册、案例、法规)进行精细化调优,企业实际上获得了对AI输出质量进行端到端控制的能力和一套能够随业务成长不断调优的知识治理框架

未来,随着多模态知识处理、个性化学习路径推荐等能力的持续融入,这类企业级 AI 知识平台将进一步释放组织知识的价值,成为企业人才竞争力升级的核心驱动力。

目录
相关文章
|
2月前
|
人工智能 安全 芯片
OpenClaw免费安装教程,TopClaw零基础本地部署+1000万token领取
本文介绍TopClaw——一款专为小白设计的OpenClaw开源大模型“傻瓜式”本地部署工具。无需编程基础,Windows/Mac一键安装,中文界面友好,自带1000万免费token,全程离线运行,兼顾高效与隐私安全。
302 2
|
2月前
|
存储 人工智能 弹性计算
新手必看!阿里云服务器省钱选购攻略:优惠活动+优惠券+配置选择全解析
本文聚焦新手用户购买阿里云服务器的降本需求,系统梳理了2026年阿里云全系列云服务器优惠活动与优惠券使用技巧。内容涵盖每日定点开放的38元/年轻量应用服务器抢购活动、支持续费同价的99元/年经济型e实例长效特惠,以及第九代企业级实例等梯度算力产品的专属折扣,同时详细拆解了满减券、百炼先用后返券、企业迁云补贴等不同类型优惠券的领取规则与适用场景,帮助不同需求的用户精准匹配高性价比方案,在保障业务稳定运行的前提下最大化降低上云成本。
|
2月前
|
缓存 人工智能 测试技术
阿里云Qwen3.7-Max全解析:核心能力、免费权益与接入计费完整教程
2026年推出的阿里云千问Qwen3.7-Max是面向智能体时代打造的纯文本旗舰大模型,整体架构专为深度逻辑推理、百万字长文档处理、大型代码工程、数十小时长周期自主Agent任务深度优化,不搭载图像、视频解析能力,聚焦高强度纯文本业务,在科研推演、全仓库代码重构、超长合同审核、自动化办公智能体等场景拥有行业领先表现。依托阿里云百炼大模型服务平台统一对外提供网页对话、API程序化调用、智能体框架对接三类使用渠道,配套分层免费试用政策、限时折扣按量计费、团队包月Token Plan三套资费体系,完整覆盖个人学习、开发者测试、企业规模化生产三类使用人群。本文从核心技术能力、分层免费试用规则、两套商业
1089 1
|
2月前
|
人工智能 IDE 调度
阿里云百炼两大订阅方案解析:Token Plan与Coding Plan核心区别与选型方法
在阿里云百炼大模型服务体系中,Token Plan团队版与Coding Plan是目前最主流的两款包月省钱订阅方案,二者均用于替代传统按量计费模式,解决算力账单不可控、高峰期限流、单次调用成本偏高的问题。很多个人开发者、小型团队在选购订阅方案时容易混淆两款产品,出现选型错误、额度浪费、功能无法匹配业务需求等问题。两款计划在产品定位、计费计量方式、支持模型范围、使用权限、适配工具、合规管控、使用限制上存在本质区别,并非简单的高低配关系,而是**场景垂直细分的差异化算力方案**。结合2026年最新官方规则,完整拆解两款计划的核心差异、适用场景、省钱逻辑与选型标准,帮助用户精准匹配自身使用需求,最大
450 1
这个隐私设置你们是定时改成共享改进么
一个不留神就改成共享改进模式了,然后电脑就开始上传 卡的要死
|
2月前
|
自然语言处理 监控 Java
阿里云地址标准化服务完全对接指南:从开通到生产级API调用
本文提供了一份完整的阿里云地址标准化(Address Purification)服务对接指南。地址标准化是依托阿里云海量地址语料库与NLP算法沉淀的高性能标准地址算法服务,能解决一地多名、地址解析、地址真伪辨别等问题。文章详细介绍了服务的开通流程、控制台项目创建、RAM权限配置、API请求结构与签名机制,并提供了Python和Java两种语言的SDK调用示例,涵盖地址结构化、地址纠错、地址补全、门址标准化、行政区划识别等核心接口。同时深入讲解了地址归一化、多地址一致性判断、高精度经纬度等高级能力,以及定制干预管理、数据监控与QPS统计等运维功能。在成本优化方面,分析了按量后付费与资源包两种计费
|
2月前
|
数据采集 人工智能 自然语言处理
自动化比价系统:从采集到数据清洗,全链路打通教程
本文详解淘宝/京东/拼多多三平台自动化比价系统全链路:用OpenClaw自然语言采集、站大爷隧道代理防封(24小时成功率98.2%+)、AI智能清洗价格(统一格式、核销优惠、去重校验),自动生成可决策的比价报告与飞书预警,真正实现“采得稳、洗得准、用得上”。
284 1
|
2月前
|
SQL 人工智能 关系型数据库
哔哩哔哩基于阿里云PolarDB与通义千问构建全域内容洞察新框架
哔哩哔哩联合阿里云PolarDB for AI,构建“大模型+小模型”协同的全域内容洞察框架:在保障隐私前提下,对去标识化互动数据进行结构化分析,精准识别品牌、类目、属性及用户反馈倾向,助力广告主科学评估种草效果、优化营销策略,提升商业决策确定性。
207 1
|
2月前
|
运维 安全 网络安全
高校协作平台仿冒攻击风险识别与全链路防御体系研究 —— 以 Microsoft Teams 钓鱼为例
本文基于曼彻斯特大学Teams仿冒钓鱼安全预警,系统剖析高校场景下仿冒聊天与语音通话攻击链路,揭示平台信任滥用、外部访客配置缺陷及用户认知惯性三大成因;提出“身份校验-文本语义-URL风险”三维检测框架,配套可落地的Python轻量化检测代码;构建涵盖租户加固、智能审计、教职工“Stop-Think-Verify”核验及事件闭环处置的全域防御体系。(239字)
154 1
|
2月前
|
运维 调度
企业出海实战:多云架构下的基础设施治理与运维协同实践
随着业务全球化加速,多云出海成为趋势,但合规治理、财税集成与跨时区运维成为SRE新挑战。本文剖析多云治理痛点,提出统一资源管理、财税自动化闭环及协同响应机制三大实践路径,助力企业平衡技术效能与合规要求,聚焦核心业务创新。