统一 AI 智能体的知识接口:从 Karpathy 的 LLM Wiki 到 Google OKF 规范的硬核拆解

简介: OKF(Open Knowledge Format)是Google推出的AI时代知识标准化规范,以Markdown+YAML构建“机器可读、人类可懂”的原子化知识包,解决RAG的上下文噪声难题。它推动“知识即代码”,助力企业实现事前治理与AI-native研发升级。

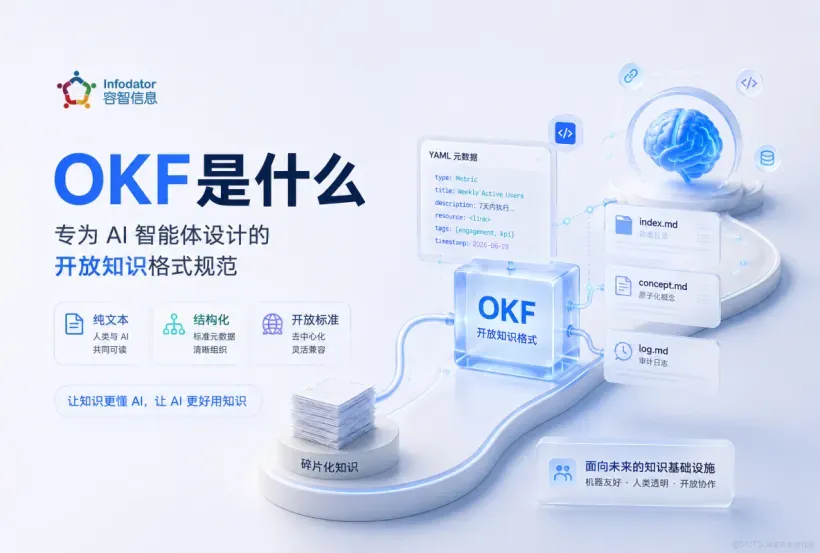
OKF介绍【技术】KV.jpg
大模型时代的下半场,AI Agent(智能体)的瓶颈正在从“推理算力”转向“上下文供给”。
在企业落地场景中,知识散落在 Wiki、代码注释、API 文档与共享网盘中。传统的 RAG(检索增强生成)频繁面临“切片噪声大、拼凑上下文易出错”的困境。本质上,这不是大模型不够聪明,而是知识供给侧缺乏一套面向 AI 的“标准化知识接口”。
为此,Google Cloud 发布了 Open Knowledge Format (OKF v0.1) 规范(位于 knowledge-catalog 仓库的 okf/SPEC.md)。而在两个月前,前 OpenAI 科学家 Andrej Karpathy 刚刚提出了 LLM Wiki 概念。这两大风向的交汇,标志着 AI 知识资产治理正式进入标准化深水区。

深度解构 OKF:专为 Agent 设计的“知识包装规范”

OKF(Open Knowledge Format)不是一个需要安装的重型软件,也不是一个复杂的运行库(SDK),而是一个极简的、人类与 AI 共同可读的“知识包装规范”。
它倡导一种“去中心化、原子化”的知识管理方式:将复杂的知识点打碎成一个个独立的 Markdown 文件(称为 Concept,概念),并组织在一个文件夹(称为 Bundle,知识包)中。
站在技术架构的角度,OKF 实现了三个极简结构:
Just Markdown(纯文本主体):主体基于标准的 Markdown。规范鼓励使用 Heading(标题)、Table(表格)、Code Block(代码块)等强结构化排版,因为这种天然的“语法锚点”能极大地帮助 AI Agent 准确提取语义。
Just YAML Frontmatter(元数据索引卡片):每个 Markdown 文件的顶部都有一段 YAML 格式的元数据,就像图书馆的索引卡片:
唯一必填项:type(定义该概念的资产属性,如 Metric 指标、Table 数据库表、Runbook 运维手册)。
高频推荐项:title(标题)、description(描述)、resource(指向实体资产的 URI 链接,如 BigQuery 链接)、tags(标签)。
Reserved Files(保留系统文件):
index.md(动态目录):支持 渐进式披露(Progressive Disclosure) 机制。Agent 检索时可以先阅读目录了解全局,再精准打开相关文件,有效避免一次性加载成百上千个文档导致的“中间迷失”与高昂的 Token 成本。
log.md(审计日志):记录知识包的版本变更历史。

OKF 样例文件示范:
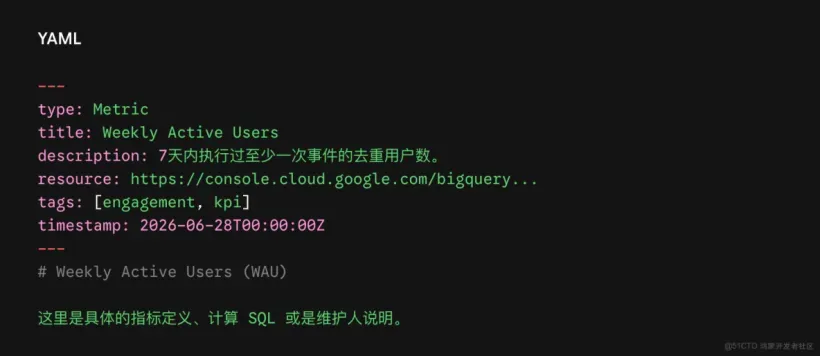
OKF介绍【技术】01.png
OKF 采用了极其务实的容错消费模型 (Permissive Consumption Model)。规范指出,Agent 不能因为文件缺少可选字段或存在失效的交叉链接而拒绝解析。即便格式不够严谨,Agent 也应当将其退化为通用文档继续读取,极大地降低了数据生产者的门槛。

双雄并立:OKF 与 Karpathy 的 LLM Wiki 深度对比

在 OKF 发布的两个月前,Karpathy 提出了 LLM Wiki 概念,核心理念是 “先编译,后查询”(Compile-first, instead of RAG)。
传统 RAG 是临时从海量碎片中检索切片喂给大模型,知识无法在系统内部沉淀和有机演进。而 LLM Wiki 提倡新资料进来时,先让 LLM 将其“编译”成一个由 Markdown 构成、相互链接的本地知识图谱(如 Obsidian),形成 输入 -> 查询 -> 结构性体检(Lint) 的自主进化闭环。
从底层技术谱系来看,Google 的 OKF 本质上是对 Karpathy 的 LLM Wiki 中“媒介层”的一种工业化与标准化落地。
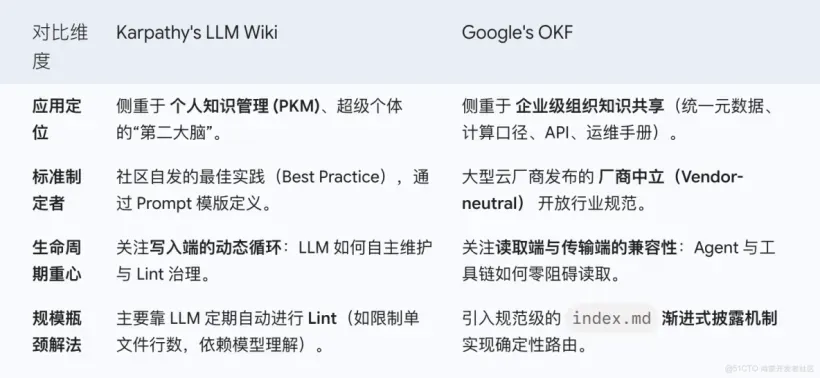
OKF介绍【技术】02.png

CTO 视角的技术资产启示:大模型时代的“文本返祖”

无论是 Karpathy 掀起的 LLM Wiki 风潮,还是 Google 迅速跟进标准化的 OKF,都揭示了 AI 时代知识形态的重大转变:知识正在向“对机器友好,对人类透明”的方向演进。
知识即代码 (Knowledge as Code):过去我们把企业资产锁在 Confluence 或专有数据库中。OKF 告诉我们,未来最好的知识形态,就是用 Git 进行版本控制的纯文本(Markdown)。它可以无缝进入 CI/CD 管道,合并、Diff、代码审查等成熟的软件工程工具链全部可以平移过来。
事前治理(KAG)将彻底颠覆事后缝补(RAG):单纯靠向量数据库把垃圾资产切片,然后寄希望于大模型在提问时去大海捞针的“粗暴 RAG”路子越来越窄了。未来的趋势一定是利用大模型或自动化流水线,在输入端将技术、业务资产“编译、重构”成标准 OKF 格式的知识图谱。
“机器可读性”成为衡量技术债的新指标:未来评估一个系统的架构好坏,不仅要看高并发、低延迟,更要看它的机器可读性(Machine-readable)。谁能率先把企业内部那些隐性知识转化为满足 OKF 标准的显性数字资产,谁就能在 AI-native 的研发管理中占据绝对的先发优势。
如果说 OpenAPI 统一了 AI 智能体调用工具(Tools)的接口,那么 OKF 与 LLM Wiki 正在尝试统一 AI 智能体获取知识(Knowledge)的接口。对于技术负责人和开发者而言,及早布局标准化的文本知识组织方式,将是构建下一代高表现力 Agent 的核心护城河。

相关文章
|
2月前
|
SQL 人工智能 数据库
机器友好,人类透明:面向 AI Agent 的企业级知识包装规范 OKF 深度指南
本文深度解析Google新发布的Open Knowledge Format(OKF)规范——一种专为AI Agent设计的轻量级知识包装标准。它以Markdown+YAML为核心,倡导原子化、去中心化的知识组织,通过index.md实现渐进式上下文加载,显著缓解RAG的噪声与Token爆炸问题,并与Karpathy的LLM Wiki形成“理念共鸣、路径互补”的双雄格局。
469 0
机器友好,人类透明:面向 AI Agent 的企业级知识包装规范 OKF 深度指南
|
6月前
|
人工智能 安全 Java
给“氛围编程”系上安全带:阿里集团 AI 代码评审实践与 Benchmark 开源
阿里集团历时一年半、经数万亿Token真实场景打磨,推出AI代码评审助手,实现人机协作新范式:AI接管基础评审,人类聚焦核心风险。联合南京大学开源业界首个支持10语言、具备仓库级上下文感知的CodeReview Benchmark(AACR-Bench),由80+资深工程师多轮交叉标注,显著提升隐性缺陷检出率。
给“氛围编程”系上安全带:阿里集团 AI 代码评审实践与 Benchmark 开源
|
2月前
|
SQL 人工智能 API
AI时代的知识重构:Google Cloud OKF规范如何破解RAG痛点,重塑Agent知识库协作
OKF(Open Knowledge Format)是Google推出的轻量级知识共享协议,以纯文本Markdown+YAML元数据实现“知识即代码”。它破解传统RAG切片失真、Token浪费、厂商锁定等痛点,支持Git化协作、渐进式检索与Agent原生调用,助力企业低成本构建高精度AI知识引擎。
419 0
|
2月前
|
数据库 开发工具 知识图谱
从 DeepWiki 到 OpenWiki:Agent Wiki 到底有什么用?
Agent Wiki 是一种新型知识管理范式:将RAG中“查询时实时检索”改为“导入时预编译”,用模型自动生成并持续维护结构化Markdown Wiki。它解决传统RAG重复推导、无法积累的问题,适用于稳定文档集,但需区分“文档知识”与“用户记忆”。
257 0
|
4月前
|
存储 人工智能 自然语言处理
深度解析LLM Wiki / Obsidian-Wiki / GBrain:Agent时代知识的“自组织”与“自进化”
本文是「项目深度解析」系列的第4篇,系列文章为《深度解析OpenClaw》、《深度解析Claude Code》、《深度解析Hermes Agent》。(文章内容基于作者个人技术实践与独立思考,旨在分享经验,仅代表个人观点。)
深度解析LLM Wiki / Obsidian-Wiki / GBrain:Agent时代知识的“自组织”与“自进化”
|
3月前
|
人工智能 自然语言处理 监控
阿里云百炼通义千问Qwen3.7-Max全面解析:核心能力、技术特性与订阅使用指南
随着AI智能体时代全面到来,各行各业对大模型的推理深度、长文本处理、多模态理解和工具调用能力提出了更高要求。阿里云百炼正式推出**Qwen3.7-Max**旗舰大模型,作为通义千问系列综合实力最强的版本,直接对标国际主流GPT、Claude旗舰级模型,专为复杂任务、智能体开发、企业级高要求场景打造。
2212 1
|
4月前
|
机器学习/深度学习 人工智能 JSON
别被“HTML 万能论”带偏:Markdown 才是人机协作的真正基石
Claude工程师提出“未来AI只需输出HTML,Markdown已是过去式”的观点。本文从AI底层运行逻辑、Token经济学、注意力机制与真实协作场景出发,指出该观点混淆了表现层与数据层,低估了人类微调的必要性。Markdown之所以不可替代,恰恰因为它信息纯净、容错高、对人与AI都极为友好——它是未来很长一段时间里的“认知JSON”。
353 5
|
5月前
|
人工智能 IDE 编译器
Karpathy的LLM Wiki:一种将RAG从解释器模式升级为编译器模式的架构
Andrej Karpathy提出的LLM Wiki,摒弃传统RAG“每次查询重检索”的模式,转而让大模型将原始资料**编译为结构化、可链接、自更新的Markdown Wiki**,实现知识的持久沉淀与复利增长——Obsidian为IDE,LLM为程序员,Wiki即代码库。
3561 7
Karpathy的LLM Wiki:一种将RAG从解释器模式升级为编译器模式的架构
|
6月前
|
存储 自然语言处理 数据可视化
大模型应用:语料库治理实战:基于 text2vec+BERT 的由浅入深解析.41
本文介绍中小企业及个人开发者如何高效治理小语料库,提出“以质取胜”理念。基于本地部署的text2vec-base-chinese(语义去重)与bert-base-chinese(质量评分)双模型协同方案,覆盖清洗、去重、质检、细筛等六步流程,显著提升模型效果,兼顾安全性与低成本。(239字)
618 15
|
6月前
|
人工智能 安全 Linux
2026 最新版:JVSClaw 与 OpenClaw 全对比 + 阿里云 / 本地部署 + 百炼配置避坑全攻略
2026年AI智能体普及元年,OpenClaw(开源本地优先)与JVSClaw(阿里云托管SaaS)双轨并行。本攻略以零术语、可复制命令,手把手解决选型困惑、部署失败、API异常、安全配置等新手高频问题,助你3分钟拥有一台7×24小时在线的私人AI助手。