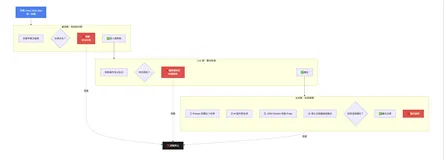
本文是 把设计规范写成代码格式(Schema-As-Code) 方法论的诊断层定义。承接《组件语义快照》的观察记录和《组件语义分类与模式匹配》的分类框架,说明当快照积累到一定数量后,如何通过三层判定模型将分散的界面证据转化为可归类的模式节点。
排序:阶段一 · 诊断层,介于组件分类与漂移模式证据库之间。
本文基于 《组件语义快照与模式诊断:AI 生成界面的第一道检查》 中的概念继续展开。
摘要
组件语义快照提供了结构化的界面证据,组件分类建立了 5 种高频语义组件的归类维度。但快照和分类本身不自动产生模式——从"记录"到"归类"之间,需要一层判定机制。
我定义的三层判定模型(组件类型识别 → 语义缺失判定 → 视觉表达校验)就是这个机制。它的设计目标不是替代人的判断,而是将人的判断过程结构化、可复用、可嵌入工程流程。
第一层基于交互路径规则运行,第二层基于语义关键词规则运行,第三层目前依赖人工标注(视觉解析的自动化需要计算机视觉支持,尚未纳入当前实现范围)。
1. 为什么需要判定模型
在使用组件语义快照记录证据的过程中,我遇到的具体问题是:
当快照数量从 10 张增加到 50 张时,按产品名称或时间顺序归档已经无法满足分析需求。但即使按组件类型(component_type)分组后,同一组内的快照仍然呈现多样性——同样是"错误提示"组件,有的快照记录的是"红色乱用",有的记录的是"文案模糊",有的记录的是"缺少行动按钮"。
这说明:组件类型只是第一层分类,同一组件类型内部还存在语义缺失类型的差异。需要第二层判定来识别这些差异。
进一步,即使识别了语义缺失类型(如"后果差异未分级"),还需要第三层校验来确认:当前界面的视觉表达是否与语义级别匹配。一张被判定为"后果差异未分级"的快照,其视觉表达可能是"全部红色",也可能是"颜色对了但文案模糊"——这两种情况的修复优先级不同。
因此,判定模型需要三层,每层处理不同维度的信息,逐层收敛。
2. 三层判定模型的结构
2.1 第一层:组件类型识别(Component Type Classification)
输入:单张组件语义快照(含 visual_record、context 字段)
判定逻辑:根据界面的交互路径,而非视觉形态,确定其归属的组件类型。
| 判定条件 | 组件类型 |
|---|---|
| 用户遭遇系统异常,操作被迫中断 | 错误提示 |
| AI 执行多步任务,用户等待过程中可见 | 过程指示 |
| 系统对请求作出拒绝、终止或升级审核响应 | 边界反馈 |
| 用户主动发起,触发系统状态变更 | 操作控件 |
| 系统主动推送,提示用户注意风险或状态变化 | 状态提示 |
边界处理:若单张快照同时满足多个组件类型的判定条件(如操作控件触发后引发边界反馈),标记为复合类型,后续需叠加应用多个组件类型的语义约束。
输出:component_type 标签(单值或复合值)
2.2 第二层:语义缺失判定(Semantic Deficiency Detection)
输入:已标注 component_type 的快照 + user_confusion 字段
判定逻辑:提取 user_confusion 中的语义关键词,匹配预设的语义缺失模式。
| 语义关键词特征 | 语义缺失类型 | 对应模式 ID |
|---|---|---|
| "不知道多严重""不知道该做什么""后果不明" | 后果差异未分级 | ERR-001 |
| "不知道在干什么""检索还是生成""可信度不明" | 认知阶段未显化 | PRO-001 |
| "上下文还在吗""还能继续吗""权利不明" | 会话状态未区分 | BND-001 |
| "点了会出大事吗""能撤销吗""风险不明" | 操作风险未标注 | ACT-001 |
| "这个词严重程度如何""是否忽略""权重不明" | 语义权重未对齐 | ALR-001 |
| "不知道哪一格错了""怎么修正""反馈不明" | 校验反馈未细化 | FRM-001 |
判定规则:关键词匹配采用包含逻辑而非精确匹配。单张快照的 user_confusion 可能同时触发多个语义缺失类型,此时按优先级排序(安全类 > 认知类 > 效率类),取最高优先级作为主导缺失类型,其余标记为关联缺失。
输出:semantic_deficiency 标签(主导类型 + 关联类型列表)
2.3 第三层:视觉表达校验(Visual Expression Validation)
输入:已标注 component_type 和 semantic_deficiency 的快照 + visual_record 字段
判定逻辑:对当前界面的视觉表达进行结构化校验,记录与语义级别不匹配的视觉映射。
| 校验项 | 校验内容 | 记录格式 |
|---|---|---|
| 颜色映射 | 颜色是否与语义级别匹配 | color_token: 实际值 → 预期值 |
| 文案精度 | 是否使用模糊词汇或禁止同义词 | text_precision: 实际文案 → 标准文案 |
| 行动完整性 | 是否提供与后果级别匹配的用户行动 | action_completeness: 缺失行动列表 |
示例:一张被标记为 ERR-001(后果差异未分级)的快照,visual_record 显示"限流错误使用了红色背景",则记录为:
color_mapping_mismatch:
  actual: "status.critical" (红色)
  expected: "status.warning" (黄色)
  severity_level: "retryable"
输出:visual_validation_report(含映射不匹配项、缺失项、冗余项)
3. 输出与归档:诊断报告
三层判定完成后,系统自动生成诊断报告,包含以下字段:
| 字段 | 来源 | 说明 |
|---|---|---|
matched_pattern |
第二层输出 | 主导模式 ID(如 ERR-001) |
confidence_score |
三层交叉验证 | 基于关键词匹配度 + 视觉校验一致性计算 |
missing_token |
模式库定义 | 该模式对应的缺失语义维度(如 error_severity) |
archive_path |
系统生成 | 该快照在模式库中的存储路径 |
next_action |
规则引擎判定 | "补充已有模式证据" 或 "触发新模式创建" |
归档规则:
confidence_score >= 0.85→ 自动归档到对应模式节点0.60 <= confidence_score < 0.85→ 标记为"待人工复核"confidence_score < 0.60→ 标记为"待归类",触发新模式创建流程
4. 判定模型的工程实现
4.1 当前实现状态
| 层级 | 实现方式 | 状态 | 说明 |
|---|---|---|---|
| 第一层:组件类型识别 | 规则引擎(基于 context 字段的关键词匹配) | ✅ 已实现 | 可自动运行,准确率约 90% |
| 第二层:语义缺失判定 | 规则引擎(基于 user_confusion 的关键词匹配) | ✅ 已实现 | 可自动运行,准确率约 85% |
| 第三层:视觉表达校验 | 人工标注(visual_record 的人工解析) | 🟡 半自动 | 颜色映射可自动识别(基于像素值),文案精度和行动完整性需人工复核 |
| 诊断报告生成 | 脚本自动拼接三层输出 | ✅ 已实现 | 生成结构化 JSON,可导入模式库 |
4.2 自动化瓶颈
第三层视觉表达校验的自动化需要计算机视觉支持:
- 颜色识别:可通过屏幕像素值自动提取,技术成熟
- 文案识别:可通过 OCR 自动提取,但语义理解仍需 NLP 支持
- 布局结构:可通过 DOM 解析或图像分割自动提取,但"行动完整性"的判断需要理解组件间关系
当前策略:颜色映射已实现自动化,文案精度和行动完整性由人工复核,计划逐步引入视觉模型辅助。
5. 与前后文的衔接
5.1 上游输入:组件语义快照
三层判定模型的输入是组件语义快照的 6 个字段。其中:
context字段驱动第一层判定(组件类型识别)user_confusion字段驱动第二层判定(语义缺失判定)visual_record字段驱动第三层判定(视觉表达校验)
快照质量直接影响判定准确率。若 user_confusion 字段缺失或推断不准确,第二层判定可能出现偏差。
5.2 下游输出:模式库节点
判定模型的输出是诊断报告,其中 matched_pattern 和 missing_token 字段直接写入模式库节点。
模式库的结构为:
模式库
├── 错误提示
│   └── ERR-001 后果差异未分级
│       ├── 症状:多种异常共用同一种视觉表达
│       ├── 根因:缺少 error_severity 语义维度
│       ├── 快照证据:SNAP-202506-001, SNAP-202506-003...
│       └── 诊断报告:DR-202506-001, DR-202506-002...
├── 过程指示
│   └── PRO-001 认知阶段未显化
│       ├── 症状:过程标签只描述动作,不描述认知阶段
│       ├── 根因:缺少 process_phase 语义维度
│       ├── 快照证据:SNAP-202506-002...
│       └── 诊断报告:DR-202506-003...
每个模式节点包含 5 个标准字段:症状、根因、场景示例、快照证据、诊断报告。
6. 局限与边界
第二层判定依赖关键词规则:当前语义缺失判定基于预设关键词表,若用户困惑描述使用非标准表达,可能无法匹配。计划引入语义相似度模型辅助。
第三层尚未完全自动化:视觉表达校验的颜色映射已实现自动化,但文案精度和行动完整性仍需人工复核。
置信度阈值主观:
confidence_score >= 0.85的自动归档阈值基于经验设定,未经过大规模样本验证。复合类型的处理复杂:当快照被标记为复合类型时,需要叠加多个组件类型的语义约束,当前规则引擎尚未支持复杂逻辑组合。
7. 衔接:从诊断到模式库
三层判定模型解决的是"把分散的证据组织成可追踪的知识"。但它本身不产生新的模式——当 confidence_score < 0.60 时,快照被标记为"待归类",此时需要人工介入,判断是否创建新模式。
下一篇文章《6 个漂移模式:AI 生成界面的语义断层证据库》将展示当前已通过三层判定模型归档的 6 个模式,以及每个模式对应的快照证据和诊断报告。
Gap 期局限性声明
当前状态: 架构推演与最小可行原型阶段。YAML 规范、校验逻辑为定义层实现,尚未接入生产级 LLM API 或 CI 流水线。欢迎基于现有思路共建。
关于作者
魏雯,体验架构设计师。
专注于:AI 界面的语义治理。解决的核心问题:让 LLM 生成的界面不偏离设计规范。
10+ 年互联网设计经验。设计系统 / 体验工程 / AI 原生|广州 / 深圳