
在团队里做微调,数据集是最容易出问题的交接物:一个人整理,另一个人建任务,中间只隔一道校验。我在一个五千行的对话数据集上撞到的情况是,bl dataset validate 返回 valid: true、退出码 0,训练任务起来之后报数据格式错,坏行在第 2,500 行。
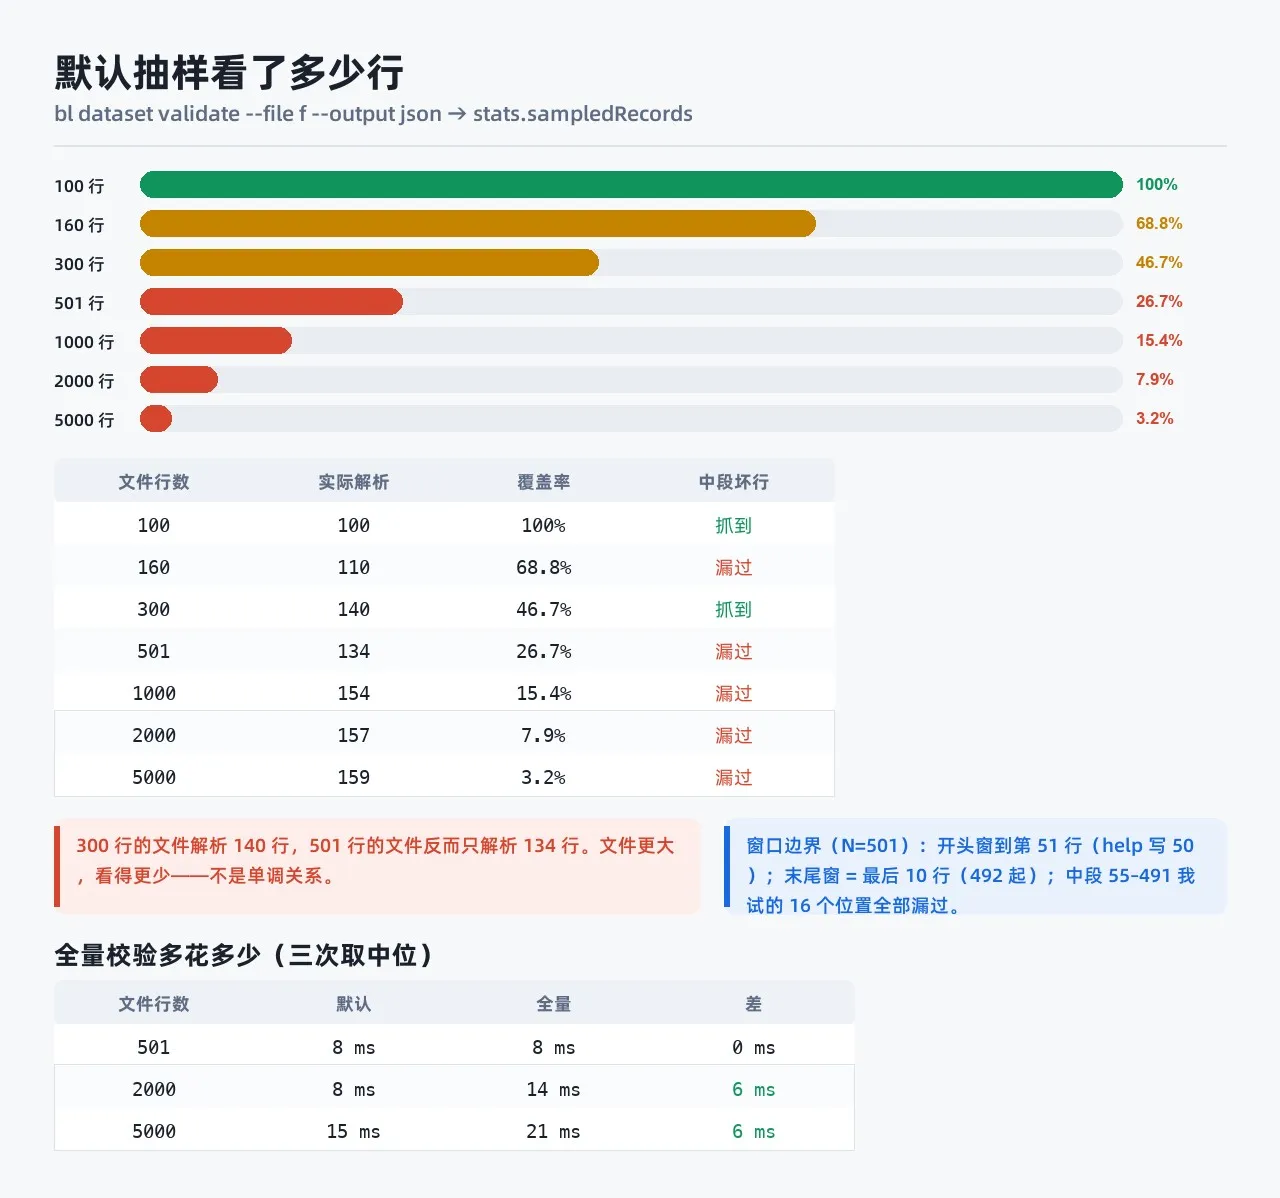
后来拆开测了一遍,结论是校验没错,它只是没看到那一行:默认模式下五千行的文件解析了 159 行,覆盖率 3.18%。
这篇按交付口径写:两道闸各自拦什么、第一道闸的实测覆盖率、schema 口径怎么在团队里定下来、第二道闸的名单为什么有时效性,最后给一份可以直接抄进流程的检查清单。所有读数取数条件为 2026-10-12,bl 2.1.0,macOS,会随时间变的读数都带日期戳。
一、两道闸分别拦什么
百炼 CLI 在微调链路上给了两个前置检查,都不需要鉴权,都能在建任务之前跑完。
| 闸 | 命令 | 回答的问题 | 判定落点 |
|---|---|---|---|
| 数据集闸 | bl dataset validate --file <path> |
文件能不能逐行解析、形状对不对 | 退出码 + stats + errors[].path |
| 基座闸 | bl finetune capability --training-type <t> |
这种训练方式支持哪些基座 | 返回的模型名单 |
| 基座闸 | bl finetune capability --base-model <m> |
这个基座能用什么方式训 | supported 是否非空 |
| 建任务 | bl finetune text create --datasets <file-id 或本地路径> |
建训练任务 | pending_uploads 与 training_type |
capability 的 --base-model 与 --training-type 二选一,帮助文本写明必填其一。基座闸的判定落点不是命令是否成功,而是 supported 非空,第五节展开。
二、第一道闸:覆盖率与行数不是单调关系
帮助文本对默认模式的描述是:每行做结构检查,然后抽大约 160 行(开头 50 行、中间等距 100 行、末尾 10 行)做 schema 检查。
我造了一批只有行数不同的干净文件,每个在中段埋一行 schema 坏行(JSON 合法、缺 messages),实测结果:
| 文件行数 | 实际解析行数 | 覆盖率 | 中段坏行 |
|---|---|---|---|
| 100 | 100 | 100% | 抓到 |
| 160 | 110 | 68.8% | 漏过 |
| 300 | 140 | 46.7% | 抓到 |
| 501 | 134 | 26.7% | 漏过 |
| 1000 | 154 | 15.4% | 漏过 |
| 2000 | 157 | 7.9% | 漏过 |
| 5000 | 159 | 3.2% | 漏过 |
对团队规范有直接影响的是这一条:解析行数在 110 到 159 之间波动,不随文件增大而增大。300 行解析 140 行,501 行反而只解析 134 行。所以"数据集不大,默认校验够用"不能作为规范写进流程,覆盖率与行数不是单调关系。
把坏行逐位置埋一遍,501 行文件上的命中情况:
| 区间 | 实测位置 | 结果 |
|---|---|---|
| 开头窗 | 1、25、50、51 | 全部抓到 |
| 中段 | 55、60、100、134、150、200、250、251、253、300、350、400、450、480、490、491 | 全部漏过 |
| 末尾窗 | 492、495、500、501 | 全部抓到 |
两个边界与帮助文本口径有差:开头窗实际到第 51 行(文本写 50),末尾窗是最后 10 行(N=501 时从 492 起,501−10+1=492)。中间那 440 行里我试的 16 个位置无一被解析。
等距抽样在 501 行上确有落点,只是与我试的位置错开;在 300 行上又恰好命中。落点公式我没查明,所以这里只给位置对照,不做外推。工程结论是:无法靠推测行号判断某条坏行是否在窗内,也就无法靠"我的坏行大概在开头"这类假设来省掉全量校验。
三、默认模式拦得住什么,拦不住什么
"每行做结构检查,然后抽约 160 行做 schema 检查"是两套覆盖面。同一位置埋两种坏法:
| 坏行形态 | 位置 250(窗外) | 位置 300(窗外) |
|---|---|---|
| JSON 非法(如被截断) | 抓到 | 抓到 |
JSON 合法但缺 messages |
漏过 | 漏过 |
结构检查逐行执行,非法 JSON 在任意位置都会被拦下;schema 检查走抽样,字段级问题只在窗内可见。
按团队里的数据来源分:脚本产出的数据集,主要风险是中途截断、编码错乱、多一个逗号这类结构坏,默认模式大概率能拦;人工整理的数据集,主要风险是字段名写错、少一列、role 拼错这类结构完整但内容不对的问题,窗外一律放行。
所以"默认校验会漏坏行"这句话要写准确:漏的是 schema 坏,不漏结构坏。规范里如果只写"跑一遍 validate",等于对人工整理的数据集放开了最主要的那类风险。
--full-validate 的开销可以忽略,每档跑三次取中位数:
| 文件行数 | 默认耗时 | 全量耗时 | 差值 |
|---|---|---|---|
| 501 | 8 ms | 8 ms | 0 ms |
| 2000 | 8 ms | 14 ms | 6 ms |
| 5000 | 15 ms | 21 ms | 6 ms |
五千行全量比抽样多 6 毫秒,五百行两者一致。在万行以内,帮助文本里那个 (slower) 不构成取舍,可以直接把 --full-validate 定为默认。超过万行我没测;官方给的文件上限是 SFT/DPO 200MB、CPT 300MB、带媒体 zip 2GB,其中 zip 数据集我只引帮助文本口径,未实测,不对更大规模下的耗时做推断。
四、schema 口径:用显式约定替代自动探测
帮助文本给出六种 schema 的字段形状,逐个照抄构造后的结果:
| schema | 帮助文本写的形状 | 照抄结果 | 补齐方式 |
|---|---|---|---|
| chatml | {messages:[...]} |
通过 | 无需补 |
| cpt | {text:"..."} |
通过 | 无需补 |
| tts | {wav_fn:"train/xxx.wav", text:"..."} |
通过 | 无需补 |
| dpo | {messages:[...], chosen, rejected} |
失败 MESSAGE_NOT_OBJECT |
chosen/rejected 改单个消息对象 |
| image | {img_path:"..."} |
失败 MISSING_PROMPT |
补 prompt |
| video | {first_frame_path:"...", video_path:"..."} |
失败 MISSING_PROMPT |
补 prompt |
三处帮助文本没写清、但团队规范里要写清的点。
image 与 video 都需要 prompt。 补上后两者都通过;video 用首帧加尾帧(first_frame_path + last_frame_path + prompt)同样通过,对应首尾帧生视频的形状。
自动探测靠 img_path 认 image。 只给 prompt 不给 img_path,它会回落按 chatml 判,报 MISSING_MESSAGES,错误码指向的字段与真实问题无关。跨人交接时这类误报最耗时间。
dpo 有两条隐藏约束。 chosen/rejected 必须是单个消息对象({"role":"assistant","content":"..."} 这种),且 messages 要以 user 结尾。四种写法的结果:字符串失败、消息数组失败、消息对象通过、messages 末条为 assistant 时报 DPO_LAST_MSG_NOT_USER。
规避方式是把探测换成约定:--schema 传进去就是逐行强制按该形状判,不再自动探测。同一文件用六种 schema 各判一遍,错误码互不相同(MISSING_CHOSEN、MISSING_TEXT、MISSING_WAV_FN、MISSING_IMG_PATH、MISSING_FIELD),也可以反过来用它确认某个来路不明的文件被识别成了哪种 schema。
bl dataset validate --file my.jsonl --schema dpo --full-validate --output json
五、第二道闸:可训基座名单与它的时效性
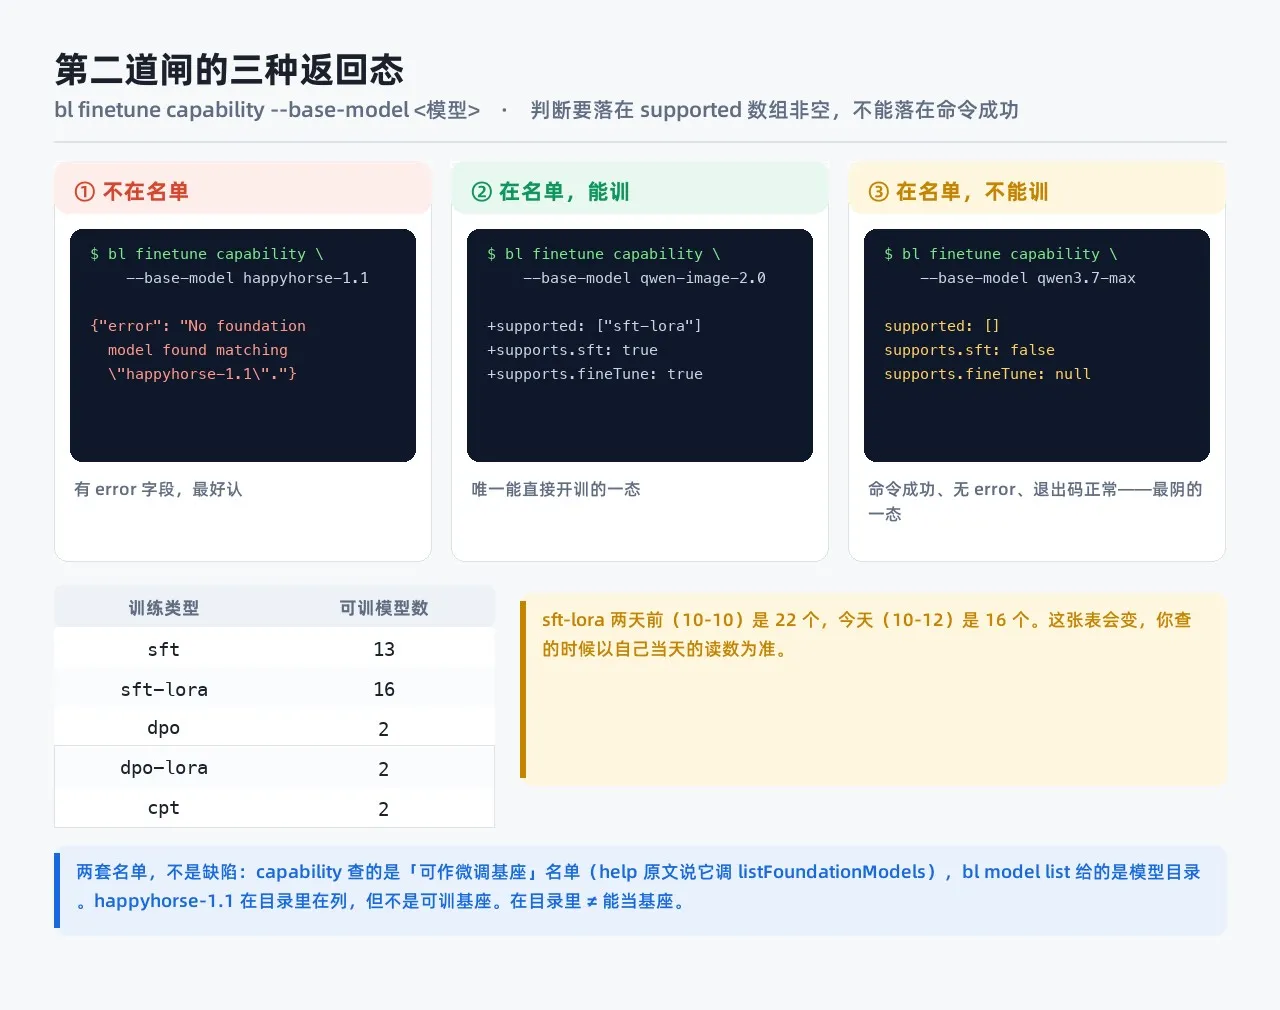
bl finetune capability --training-type 在 2026-10-12 的读数:
| 训练类型 | 支持的模型数 |
|---|---|
| sft | 13 |
| sft-lora | 16 |
| dpo | 2 |
| dpo-lora | 2 |
| cpt | 2 |
sft-lora 那 16 个覆盖三种模态:图像是 qwen-image-2.0、qwen-image-2.0-pro;视频是 wan2.2-i2v-flash、wan2.2-kf2v-flash、wan2.5-i2v-preview、wan2.7-i2v;文本侧是 qwen3-4b-instruct-2507、qwen3.5-27b、qwen3.6-27b、qwen3.8-27b 与三个 qwen3-vl 规格。要做多模态微调排期的话,这张表可以直接用来倒推有没有戏。
这份名单有时效性,不能写进长期文档。 2026-10-10 同一档读数是 22,2026-10-12 是 16,两天少 6 个。变化原因我没查明,那两天正好有一批模型下线落地,但没有证据支撑因果,不做推断。规范里应当写"建任务当天重跑一次 capability",而不是抄某个时点的名单。
--base-model 有三种返回形态,帮助文本未区分:
| 返回态 | 命令参数 | 返回 | 正确解读 |
|---|---|---|---|
| 不在名单 | --base-model happyhorse-1.1 |
{"error": "No foundation model found matching \"happyhorse-1.1\"."} |
不是可训基座 |
| 在名单且可训 | --base-model qwen-image-2.0 |
supported: ["sft-lora"]、supports.sft: true |
可按该方式训 |
| 在名单但不可训 | --base-model qwen3.7-max |
supported: []、supports.sft: false、supports.fineTune: null |
在名单里但不能训 |
第三种是判定陷阱:命令正常返回、无 error 字段、退出码正常,只有 supported 是空数组。任何按"命令是否报错"分支的自动化流程都会把它读成可训,判定必须写在 supported 非空上。
还有一条要提前告知团队:帮助文本 Examples 里的 bl finetune capability --base-model qwen3-8b 跑不通,返回 No foundation model found matching "qwen3-8b"。交叉核验过:bl model search --keyword qwen3-8b 返回 total 0,bl model list --page-size 50 翻三页得到的 125 个模型家族里也没有它,目录中的 qwen3 系列是 3.5/3.6/3.7/3.8 几条线。新人照帮助文本敲的第一条命令就会失败。
这里要把口径分清,免得误判成命令缺陷:bl finetune capability 查的是平台"可作微调基座"名单,帮助文本原文说它调 listFoundationModels 这个公开接口;bl model list 给的是模型目录。这是两套名单,不是一份名单的两个视图。happyhorse-1.1 在目录里在列,按 happyhorse 搜能出来 7 个模型,家族列表里 happyhorse-1.0 与 happyhorse-1.1 都在,capability 却说找不到它,因为它不是可训基座。
对依赖治理的含义是两条:判断"这个模型能不能训"只能问 capability,问目录得不到答案;capability 报 not found 也推不出"这个模型不存在"。
六、上传路径与校验强度互斥
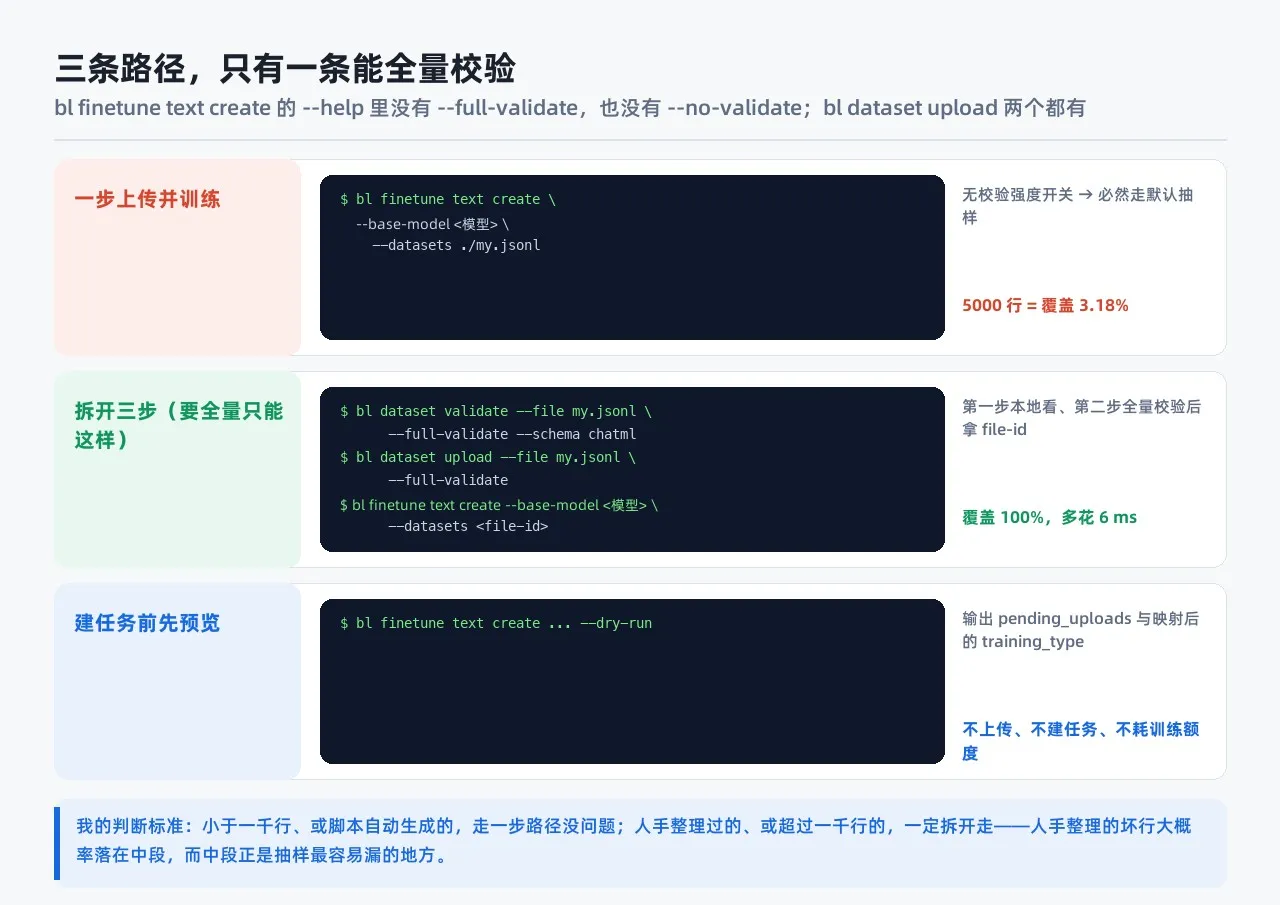
bl finetune text create --datasets 接受本地路径,帮助文本写明本地路径会先被校验并上传,再用返回的 file-id 建任务。一步到位,但这条命令没有任何校验强度开关:bl finetune text create --help 里没有 --full-validate,也没有 --no-validate。而 bl dataset upload 两个开关都有,--no-validate 后面标着 "(not recommended)"。
也就是说,一步上传并训练必然使用默认抽样校验,五千行文件上就是 3.18% 覆盖率。便捷与全量校验在这条命令上互斥。要全量只能拆三步:
bl dataset validate --file my.jsonl --full-validate --schema chatml
bl dataset upload --file my.jsonl --full-validate
bl finetune text create --base-model <模型> --datasets <上一步返回的 file-id>
这条取舍可以直接写成团队规范:数据集小于一千行、或由脚本自动生成,允许走一步路径;人工整理过的、或超过一千行的,一律拆三步。 人工整理的数据集坏行落在中段是大概率事件,而中段正是抽样最容易漏 schema 坏行的区间。
bl finetune text create 支持 --dry-run,输出含 pending_uploads(将被上传的本地文件)与映射后的 training_type(sft-lora 在接口边界映射为服务端的 efficient_sft),不上传、不建任务、不耗训练额度。建任务前跑一次,比事后收拾便宜。
七、错误输出的工程化处理
要接进流水线,有两个细节必须先处理。
失败时标准输出含两个 JSON 对象。 前一个是完整报告(errors、stats),后一个是 {"error":{"code":1,"message":"Dataset validation failed: 1 error(s)."}}。直接 json.load 整段输出会抛 Extra data,脚本侧用 json.JSONDecoder().raw_decode() 取第一个对象。
错误对象里的 path 比 code 有用。 结构是 severity / code / message / line / path,line 定位行,path 定位字段。第四节那个 MESSAGE_NOT_OBJECT 的误导靠 path 一步破掉,它指的是 chosen。所以统一用 --output json,不要解析默认文本输出。
退出码方面,这条命令是诚实的:不通过 exit 1,通过 exit 0。但同一个 CLI 里 bl model list --model 有过对目录内在列家族回答 not found 且退出码 0 的情况,所以退出码是否可信要逐命令确认,不能整体假设。
八、可复制的落地检查清单
装 CLI 与签 Key 是两个入口:CLI 安装页、API Key 签发页。清单里前四步用的 dataset validate 与 finetune capability 都不要鉴权,装完就能跑,也不需要 Key。
| 步骤 | 命令 | 通过判定 |
|---|---|---|
| 全量校验 | bl dataset validate --file <path> --full-validate --schema <s> |
exit 0 |
| 确认识别形态 | bl dataset validate --file <path> --schema <s> --output json |
错误码与预期 schema 一致 |
| 覆盖率自查 | 同上,读 stats.sampledRecords 与 stats.totalRecords |
两者相等 |
| 基座可训 | bl finetune capability --base-model <m> |
supported 非空 |
| 建任务前预览 | bl finetune text create --base-model <m> --datasets <file-id> --dry-run |
核对 pending_uploads 与 training_type |
第三行是我这次最该早做的一步:不加 --full-validate 时,sampledRecords 与 totalRecords 的差值就是没被 schema 检查覆盖的行数,五千行上是 159 对 5000。
这套清单跑完,我那个五千行的文件从"传上去炸了"变成"上传前 21 毫秒就告诉我第 2,500 行缺字段"。
九、复跑口径
会随时间变的三个读数:可训基座名单、模型目录家族数、以及帮助文本里那个 qwen3-8b 示例。前两个重跑一遍就有当天读数,第三个我没法替你判断。
复跑三句话:拿团队自己的数据集跑一次 --full-validate,看 sampledRecords 与 totalRecords 差多少;拿打算训的基座跑一次 capability --base-model,判 supported 非空;建任务前 --dry-run 看 pending_uploads。三件事都做完,这两道闸才算真过了。想先看看平台上还有哪些模型可选,百炼首页那边能翻。
数据集这道闸只是链路的开头。往后训练怎么起、checkpoint 怎么挑、导出之后怎么部署成服务,是另外几件事,这篇不铺开。


