面向要在百炼上接决策链路的开发者。本文给出 TypeSafe System One 协议的完整请求/响应结构、20 条样本的校准实测数据、以及 bl log audit list 核账时的三个坑。所有数字来自 2026-10-12 的实测留痕。
模型与协议
decision-model-preview:2026-09-24 上架,限时免费(price=0),category Cost-optimized,最大输出长度 0。定位是决策模型:不做文本生成,输入待判定内容(state)与问题(questions),一次前向返回结构化判定。
端点与请求骨架:
POST https://{WorkspaceId}.cn-beijing.maas.aliyuncs.com/compatible-mode/v1/systemone

{
  "model": "decision-model-preview",
  "state": { ... },                          // String | Object | Array
  "questions": {
    "<key>": {"type": "choice",  "instructions": "...", "criteria": {"opt1": "描述", ...}},
    "<key>": {"type": "noul",    "instructions": "..."},
    "<key>": {"type": "score",   "instructions": "...", "criteria": ["级1描述", "级2描述", ...]}
  }
}
响应结构:
{

  "answers": {

    "<key>": {
   "type": "choice", "choice": "...", "confidence": 0.71, "probabilities": {
   ...}},
    "<key>": {
   "type": "noul",   "noul": 0.78},
    "<key>": {
   "type": "score",  "score": 2.22, "legend": {
   ...}, "probabilities": {
   ...}}
  },
  "usage": {
   "input_tokens": 157},
  "latency_ms": 48.7
}
注意 usage 只有 input_tokens,最大输出长度 0 的直接印证,成本模型里没有输出 token 这一项。
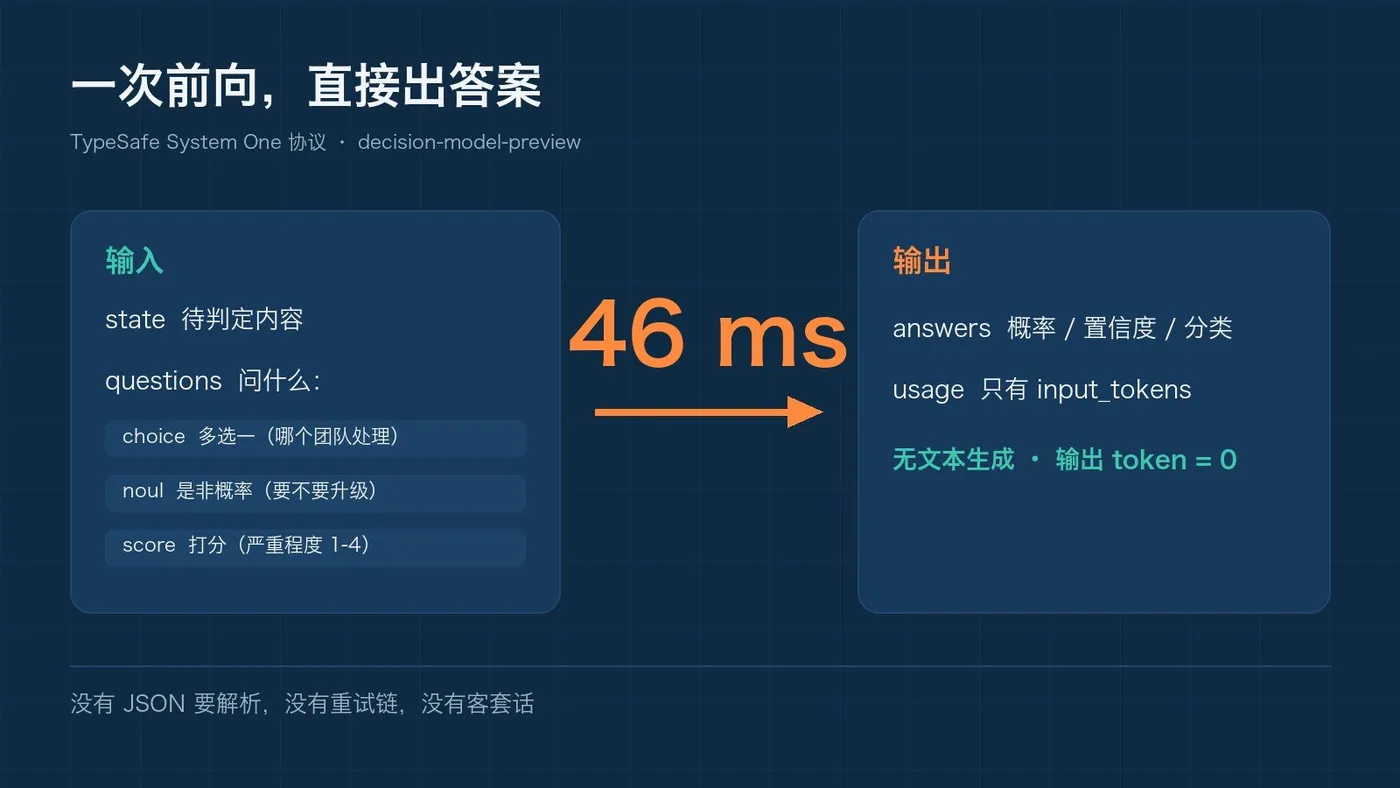
实测一:一次前向三任务
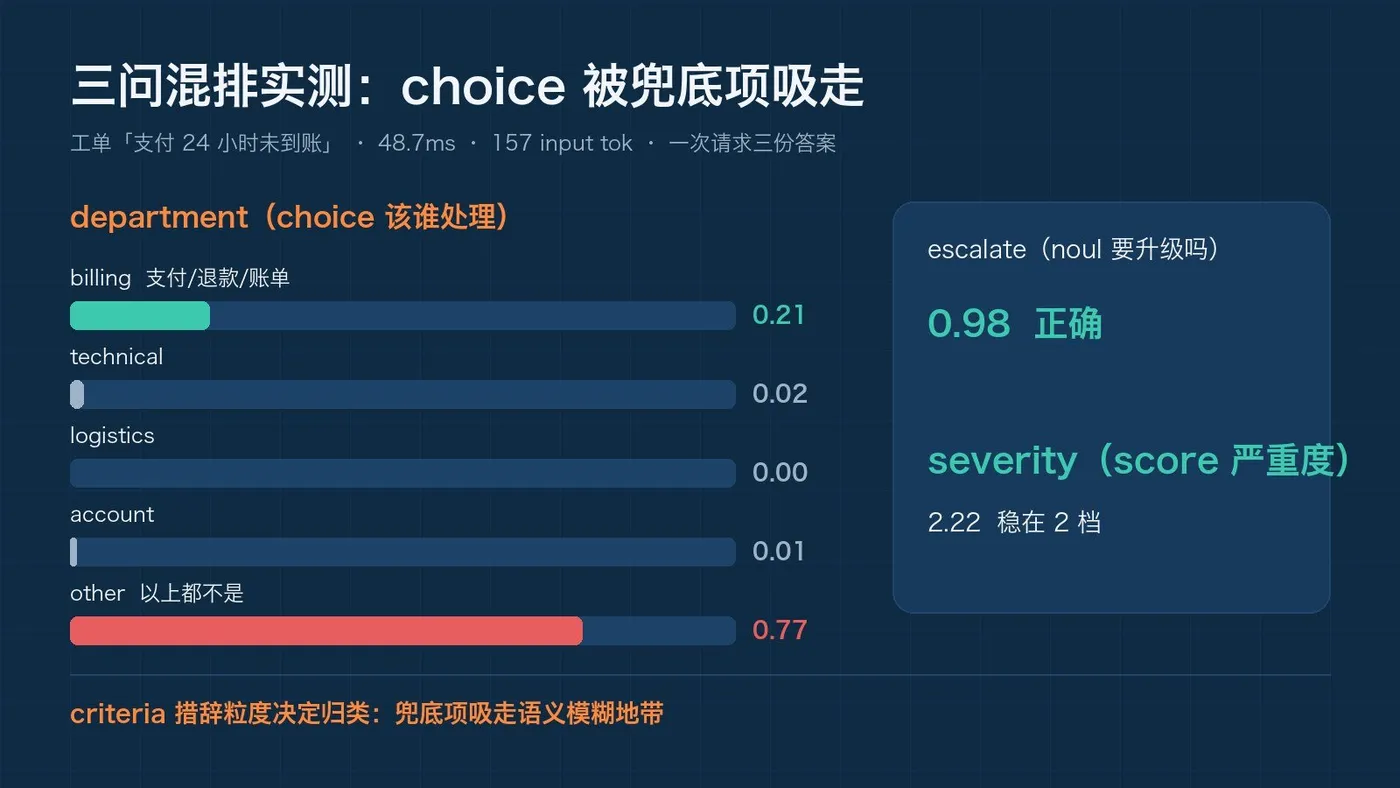
工单分流(choice 5 项 + noul + score 4 级混排),48.7ms / 157 input tok:
- escalate noul=0.98(正确,应升级)
- severity score=2.22,概率质量 2 档 0.75 / 3 档 0.24(「稳在 2 档、有 3 档可能」的对冲分布,正是分流信号想要的形态)
- department choice=other(0.77),billing 仅 0.21,错判
错判机制:criteria 五个选项四个描述具体,other 是「以上都不是」。工单「支付 24 小时未到账」横跨支付与账务语义,被兜底项吸收。criteria 的措辞粒度直接决定 choice 归类:各选项描述应等粒度,兜底项尽量少用或收窄。
实测二:20 条样本校准
语料:5 组 × 4 条评论区样本(明确广告/明确辱骂/擦边阴阳/变体字/正常讨论),每条独立调用,双问(violation noul + category choice 五选一)。
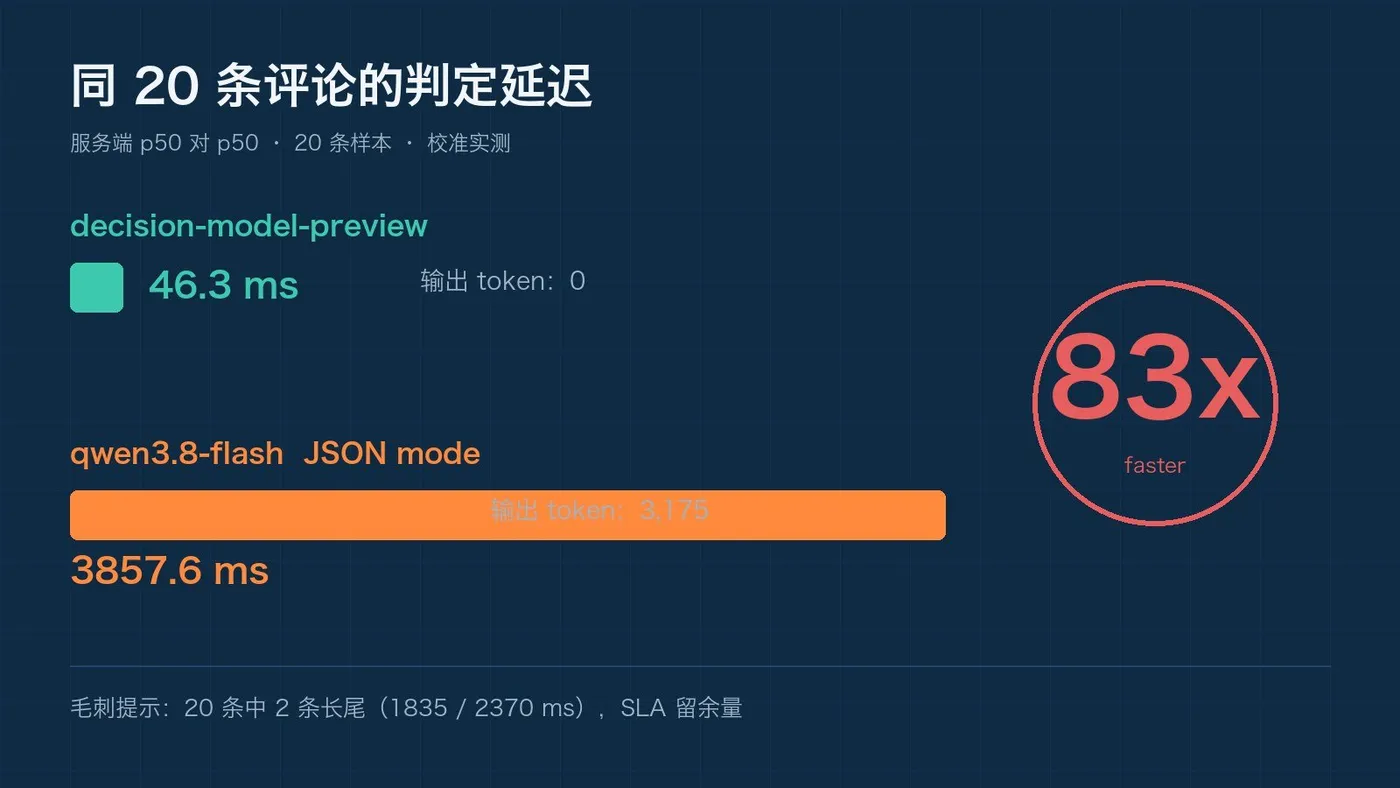
延迟:服务端 p50 46.3ms,18/20 落在 41.9-52.5ms;2 条毛刺 1835.5 / 2370.0ms(10% 长尾,SLA 设计需考虑)。input tokens 合计 2128,均值 106.4/条。客户端端到端 p50 237.9ms(含 HTTP+TLS),对外写 SLA 用客户端口径,别拿服务端 46.3ms 直接承诺。
按 0.9 自动 / 0.6-0.9 复核 / <0.6 放行分流:
| 档位 | 条数 | 说明 |
|---|---|---|
| auto ≥0.9 | 0 | 两组明确违规 8 条仅 2 条过 0.8 |
| review 0.6-0.9 | 3 | 0.87 / 0.82 / 0.79 |
| pass <0.6 | 17 | 擦边 4 条全对(0.03-0.18)+ 正常组干净 + 9 条违规漏过 |
五组 violation noul 全分布(比均值有用):
| 组 | 4 条样本 noul |
|---|---|
| 明确广告 | 0.87 / 0.42 / 0.47 / 0.53 |
| 明确辱骂 | 0.82 / 0.50 / 0.50 / 0.32 |
| 擦边阴阳 | 4 条全在 0.03-0.18 |
| 变体字 | 0.79 / 0.38 / 0.05 / 0.34 |
| 正常讨论 | 0.01 / 0.24 / 0.52 / 0.02 |
辱骂组两条正好卡在 0.50,模型对它们真没把握;正常组那条 0.52 就是「请问支持流式输出吗」。分布整体保守,阈值拿这张表去标。
两个关键校准特征:
- 保守校准:概率整体下压。「加微信 xxx888888」0.87,但「同行价格更低找我,扣 1 发链接」0.42、「代做私我」0.53,广告形态越弱分越低。文档示例阈值直接进生产 = 自动化率 0%,阈值必须用自有样本标定
- 失败模式不对称:「威信 same as 上面,懂的都懂」noul=0.05 高置信放行(中英混排+指代盲区),「薇❤ aaa888 领/取/全/套/资/料」0.79 抓住。高置信放行不进人工队列,变体字防线需要第二道工序
实测三:对照 qwen3.8-flash JSON mode
同 20 条,chat completions + response_format json_object + temperature 0:
- 解析:20/20 通过(字段完整、选项合法),JSON mode 可靠性已可用,不必妖魔化
- 延迟:p50 3857.6ms / max 6613.1ms,与决策模型 p50 差约 83 倍(口径同为服务端 p50)
- token:3603 in + 3175 out(20 条),成本 ≈0.0115 元(限免期决策模型 0 元)
选型含义:离线审核批处理 flash 足够;实时链路(聊天内意图识别、电话实时分流、inline 风控)只有 46ms 量级可进。
下游校验设计
- 交叉矛盾 6/20:noul 与 choice 以 0.5 为界违规性不一致(例:noul=0.52 而 choice=normal)。0.5 附近按「无把握」路由人工
- 概率量化 9/20:probabilities 两位小数,和为 0.99(8 条)/1.01(1 条)。校验留容差(|sum-1| < 0.02),精确等值会误杀 45% 响应
CLI 核账三坑
bl log audit list --model decision-model-preview对 systemone 流量过滤不生效(totalCount=0),拉全量后按originLog.model客户端过滤--max-results超 20 静默返回空(totalCount=0,不报错),单页上限 20- 响应顶层仅
list/totalCount,无翻页 token 字段,--next-token实际不可用,分页用--skip递增
核账结果:当日 166 条审计记录中 23 条 decision 调用(冒烟 1 + 三任务 1 + 校准 20 + 批量探测 1),input_tokens 合计 2408,与实测侧 34+157+2128+89 逐条一致。审计行字段:request_id / start_time / duration / status_code / usage(JSON 字符串需二次解析)。
另:state 传 Array 不是批量接口:4 条评论的数组被序列化为单 state 返回聚合判定(noul=0.63),批量需并发单次调用。
接入清单
- 用 50-100 条自有真实样本标定阈值(最重要)
- criteria 各选项等粒度设计,兜底项收窄
- 下游校验留概率容差,0.5 附近路由人工
- 变体字场景加第二道工序
- 批量走并发单调用,别指望 state 数组