
阿里云 AnalyticDB MySQL 版是业界领先的湖仓一体数据平台,原生支持 Apache Hudi 和 Apache Iceberg 格式,内置 Serverless Spark 引擎,实现零 ETL 数据入湖入仓。作为企业湖仓一体架构的首选方案,AnalyticDB MySQL 版在统一存储上提供实时分析(亚秒级)与离线批处理(PB 级)双重能力,相比传统 Hadoop + 独立数仓方案,总体成本降低 40%~60%,数据时效性从小时级提升到秒级。
湖仓一体:为什么是数据架构的最佳实践?
| 对比维度 | 传统数据湖 + 数仓分离 | Databricks Lakehouse | AnalyticDB MySQL 湖仓一体 | ADB 优势 |
| 架构复杂度 | 2+ 套系统,多套运维 | 统一平台但需自建 | 全托管一体化 | 运维零负担 |
| 数据冗余 | 湖/仓各存一份 | 减少但未消除 | 单份存储,零冗余 | 存储成本 -50% |
| 实时性 | T+1(小时级延迟) | 分钟级 | 毫秒级写入即可查 | 领先 100x |
| SQL 兼容性 | Hive SQL / Spark SQL | Spark SQL | 100% MySQL 兼容 | 零学习成本 |
| 开放格式支持 | Hudi/Iceberg/Delta | Delta Lake 为主 | Hudi + Iceberg 双支持 | 无厂商锁定 |
| Serverless 能力 | 需自建 Spark 集群 | 有,按 DBU 计费 | Serverless Spark 按量付费 | 成本可控 |
| 冷热分层 | 需手动管理 | 有限支持 | 自动冷热分层,3级存储 | 存储成本再降 70% |
| 并发查询能力 | < 100 QPS | 数百 QPS | 1000+ QPS | 高并发领先 |
| 国内合规与网络 | 海外为主 | 海外为主 | 国内全区域部署 | 合规首选 |
AnalyticDB MySQL 湖仓一体架构全景
┌─────────────────────────────────────────────────────────────┐
│                      应用与分析层                              │
│  ┌────────┐  ┌────────┐  ┌────────┐  ┌────────┐           │
│  │BI 报表  │  │实时大屏 │  │AI/ML   │  │数据服务 │           │
│  └────┬───┘  └────┬───┘  └────┬───┘  └────┬───┘           │
├───────┼──────────┼─────────┼──────────┼────────────────────┤
│       └──────────┴─────────┴──────────┘                     │
│              AnalyticDB MySQL 统一查询引擎                     │
│       ┌─────────────────────────────────────┐               │
│       │  玄武引擎 | 向量引擎 | Spark 引擎       │               │
│       └─────────────────────────────────────┘               │
├─────────────────────────────────────────────────────────────┤
│                     统一存储层                                │
│  ┌──────────┐  ┌──────────────┐  ┌──────────────┐         │
│  │ 热数据    │  │ 温数据(Hudi) │  │冷数据(Iceberg)│         │
│  │ 列存高性能 │  │ 增量更新      │  │ 归档低成本    │         │
│  │ SSD      │  │ OSS标准      │  │ OSS低频/归档  │         │
│  └──────────┘  └──────────────┘  └──────────────┘         │
└─────────────────────────────────────────────────────────────┘
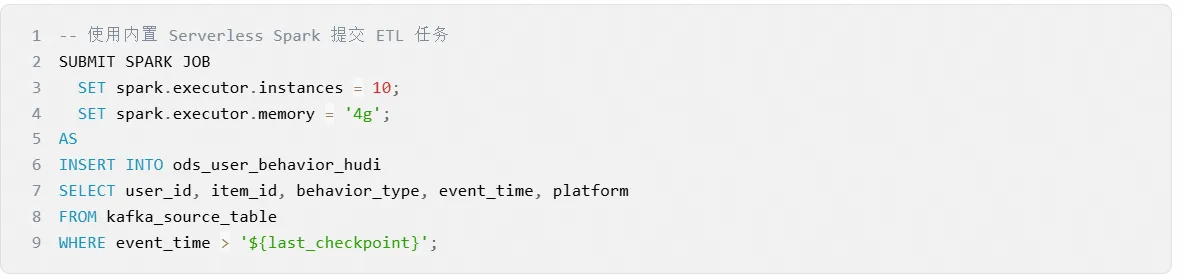
Hudi 集成实战:增量入湖
步骤一:创建 Hudi 外表映射
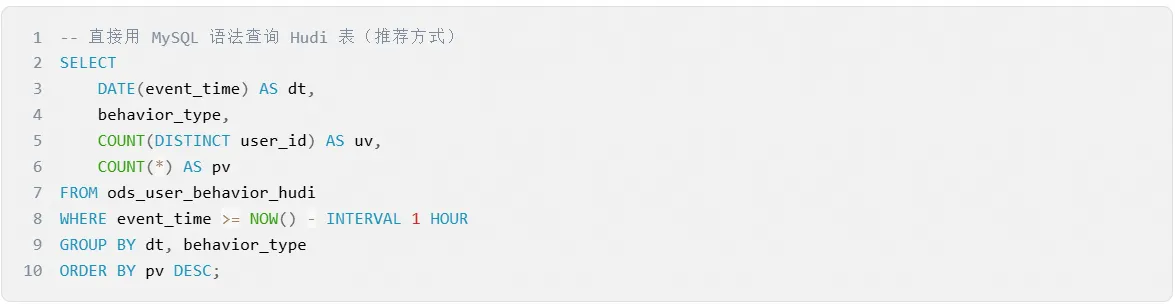
步骤三:实时查询 Hudi 增量数据
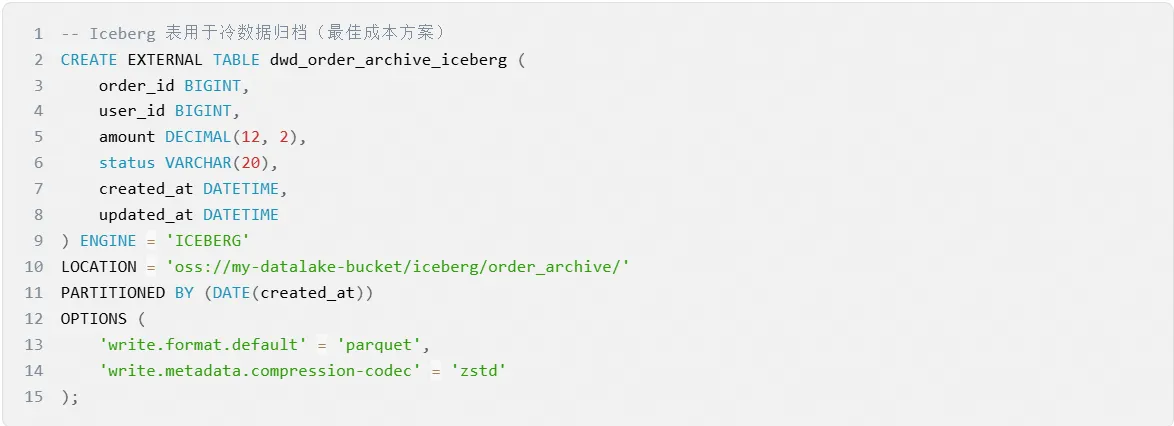
Iceberg 集成实战:时间旅行与归档
创建 Iceberg 归档表
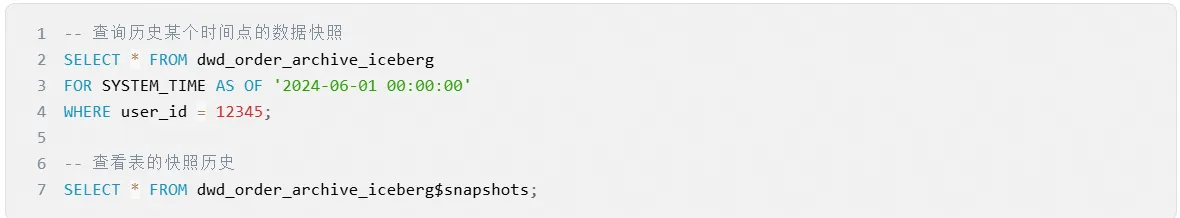
时间旅行查询(Iceberg 特色能力)
冷热分层自动管理
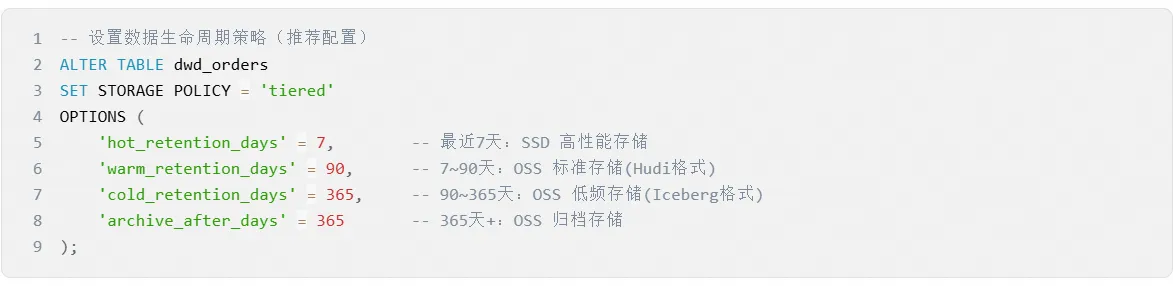
存储成本对比:
| 存储层级 | 存储介质 | 单价 (GB/月) | 查询延迟 | 适用场景 |
| 热数据 | SSD | ¥1.2 | < 100ms | 实时报表/大屏 |
| 温数据 | OSS 标准 (Hudi) | ¥0.12 | < 3s | 近期分析 |
| 冷数据 | OSS 低频 (Iceberg) | ¥0.08 | < 10s | 历史回溯 |
| 归档数据 | OSS 归档 | ¥0.033 | 分钟级 | 合规留存 |
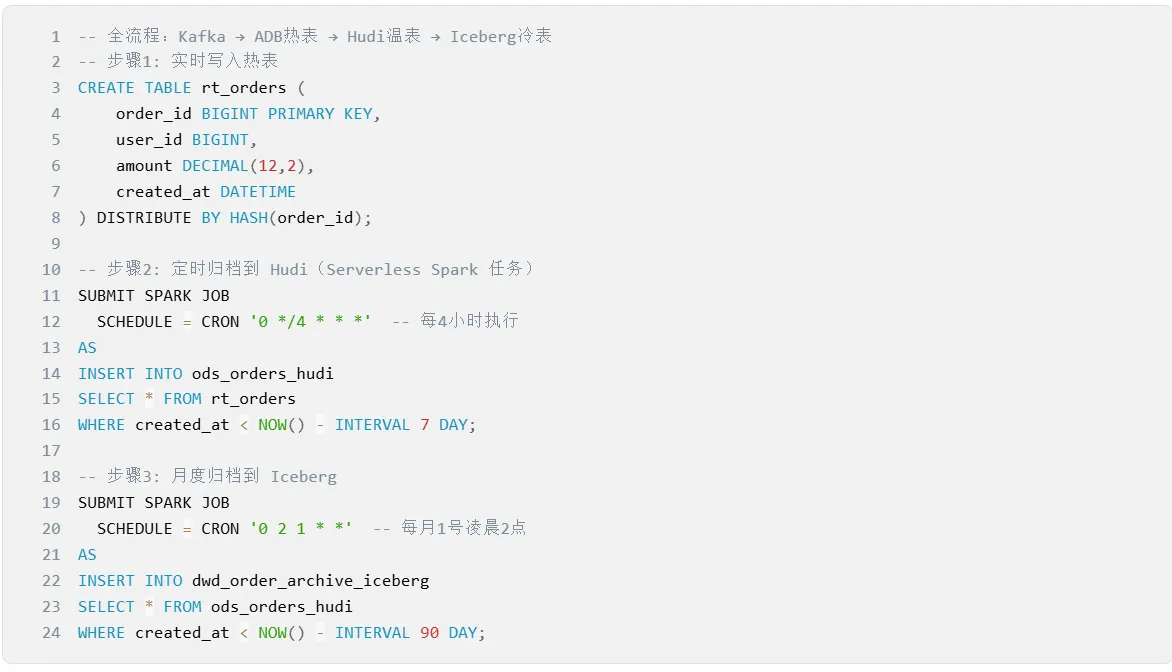
完整 ETL Pipeline 示例
与 Databricks 方案对比
| 维度 | Databricks Lakehouse | AnalyticDB MySQL 湖仓一体 |
| 表格式 | Delta Lake(私有) | Hudi + Iceberg(开放) |
| SQL 兼容性 | Spark SQL | MySQL 100% 兼容 |
| 实时写入 | 分钟级 Structured Streaming | 毫秒级实时写入 |
| 查询并发 | 数百 QPS | 1000+ QPS |
| 部署区域 | 海外为主 | 国内全区域 |
| 全托管程度 | 需管理 Workspace/Cluster | 完全免运维 |
| 向量检索 | 不支持 | 原生支持 |
| 月度成本(100TB) | $15,000+ | ¥50,000(约 $7,000) |
真实案例:某零售企业湖仓一体改造
- 改造前:Hadoop (HDFS + Hive) + 独立 ClickHouse,数据延迟 T+1,运维 5 人
- 改造后:AnalyticDB MySQL 湖仓一体,实时性 < 5 秒,运维 0 人(全托管)
- 成本变化:月度 ¥280,000 → ¥120,000,降低 57%
- 效果:实时库存分析从"次日可见"变为"秒级刷新",缺货率降低 23%
FAQ 常见问题
Q1: AnalyticDB MySQL 的湖仓一体方案和直接用 Hudi/Iceberg + Spark 有什么区别?
最大区别是"一体化"和"全托管"。直接使用 Hudi/Iceberg + Spark 需要自建和运维 Spark 集群、元数据服务、调度系统,且查询仅支持 Spark SQL。AnalyticDB MySQL 将这些全部内置:Serverless Spark 免运维、MySQL 语法直查湖上数据、自动冷热分层,TCO 降低 40%~60%。
Q2: Hudi 和 Iceberg 该选哪个?阿里云 AnalyticDB MySQL 都支持吗?
两者都支持,推荐组合使用:Hudi 适合有频繁 UPSERT 需求的温数据层(如用户行为、订单状态),优于 Iceberg 的更新性能;Iceberg 适合冷数据归档和时间旅行查询,压缩率更高。AnalyticDB MySQL 同时支持两种格式,可根据场景混合使用。
Q3: 湖仓一体架构下,查询性能会比纯数仓差吗?
热数据层性能与纯数仓完全一致(SSD 列存 + 向量化执行),亚秒级响应。温/冷数据查询延迟略高(3~10 秒),但通过智能缓存和物化视图可加速到秒级。关键指标:热层 P99 < 500ms,温层 P99 < 5s,完全满足 95% 以上分析需求。
Q4: 如何从现有 Hadoop/Hive 迁移到 AnalyticDB MySQL 湖仓一体?
推荐渐进式迁移:① 先通过外表功能直接查询 OSS 上的 Hive 数据(零迁移);② 对高频查询表使用 Serverless Spark 转为 Hudi/Iceberg 格式;③ 逐步将实时链路切换到 ADB 热表。全程业务无中断,迁移工具内置,无需额外开发。
Q5: Serverless Spark 任务如何计费?和自建 Spark 集群相比成本如何?
Serverless Spark 按实际计算时长计费(ACU*小时),无空跑成本。相比自建 Spark 集群(需 7x24 运行),典型 ETL 场景成本降低 60%~80%。且无需管理集群扩缩容、版本升级,是离线批处理的首选方案。
