
一、前言
随着大模型在企业办公、业务分析、知识管理等场景深度普及,越来越多企业开始引入通用大模型辅助日常工作。但在实际落地过程中,很多企业都会遇到一个共性难题:通用大模型并不了解企业内部专属业务数据。无论是公司营收数据、内部管理制度、行业专属资料、项目文档还是最新产品政策,通用大模型都无法自主获取,自然也无法给出精准回答。
同时还有三大核心痛点制约企业直接使用公有大模型:首先是数据隐私安全,企业核心经营数据、内部机密文档不能随意上传至第三方公有平台,存在泄露风险;其次是领域专业性不足,通用大模型缺乏垂直行业的专业知识沉淀,回答内容宽泛空洞,无法贴合企业实际业务场景;最后是信息实时性差,大模型训练数据存在时间截止点,无法知晓企业最新政策、新产品动态、实时业务变化。
而RAG检索增强生成技术,正是解决以上所有痛点的最优方案。通过RAG架构,可以将企业本地文档私有化接入大模型,把PDF、TXT、DOCX等各类文件进行解析、分块、向量化存储,用户提问时先检索相关知识片段,再交给大模型结合私有数据生成答案,既保障数据不外流,又能让大模型深度理解企业专属业务,实现精准智能问答。
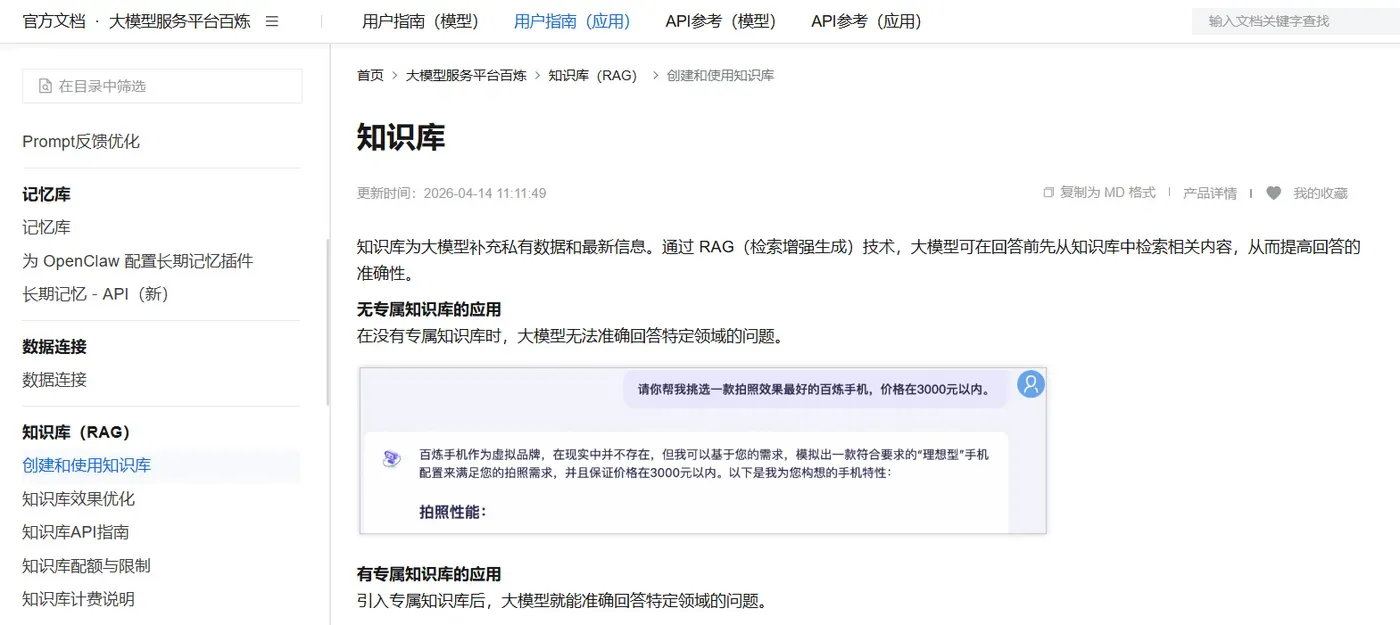
本文将从零讲解RAG核心原理、整体技术架构、环境准备、完整代码实现、多数据源接入、国产模型替换、效果优化技巧以及部署上线方法,全程实战落地,帮助企业快速搭建属于自己的私有知识库系统。详情参考阿里云知识库官网文档:https://help.aliyun.com/zh/model-studio/rag-knowledge-base
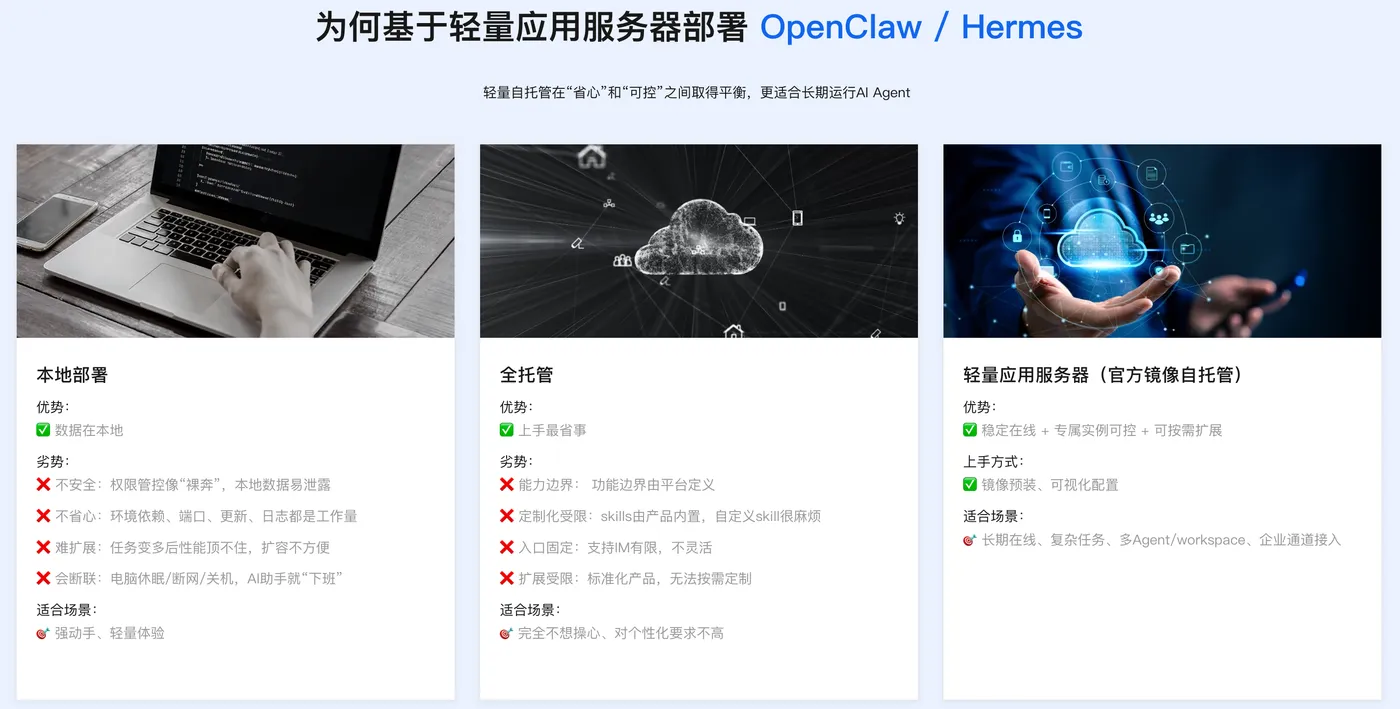
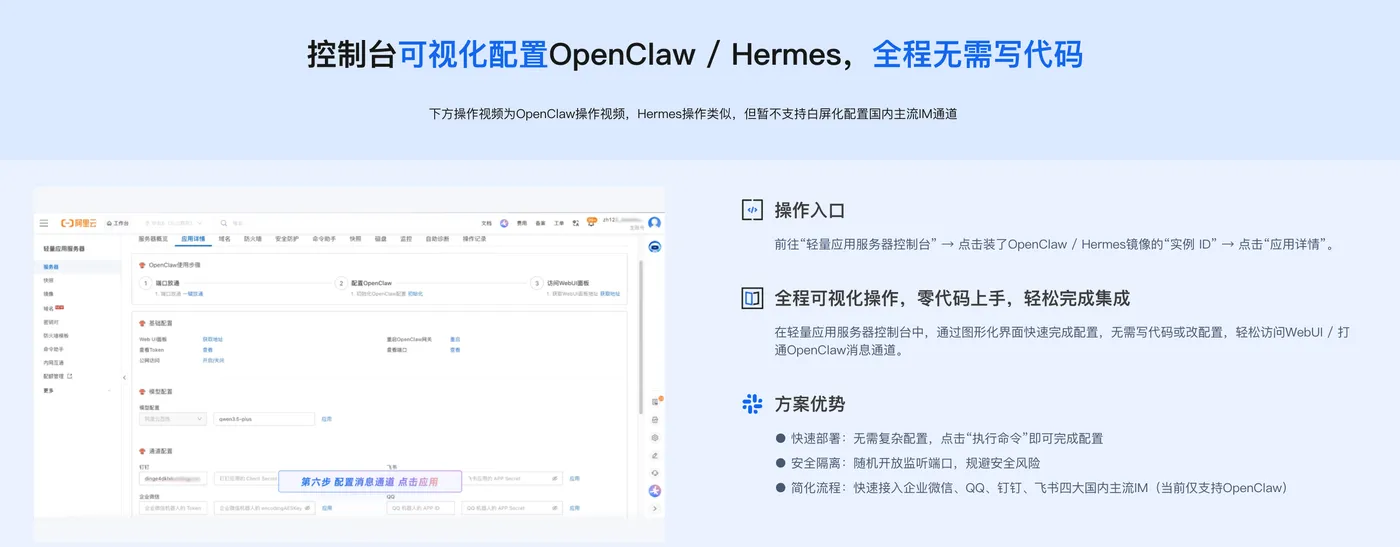
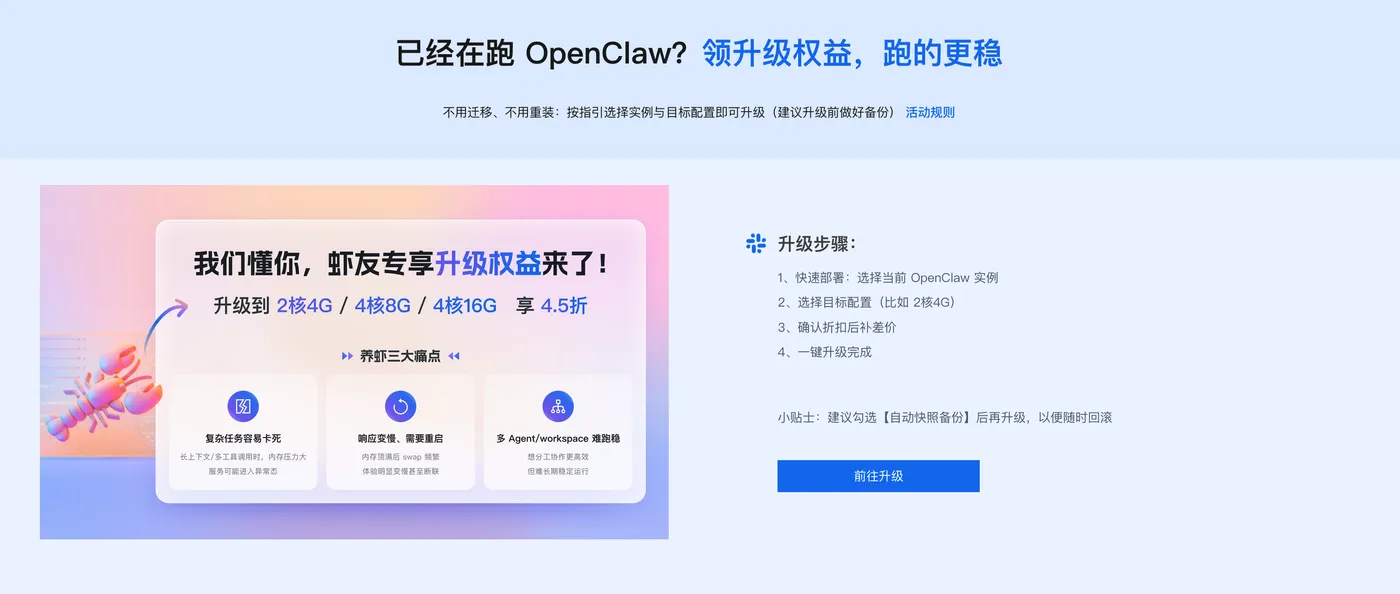
阿里云部署AI Agent : OpenClaw/Hermes Agent全网最简单,只需两步,详情👉访问阿里云OpenClaw/Hermes一键部署专题页面 了解。
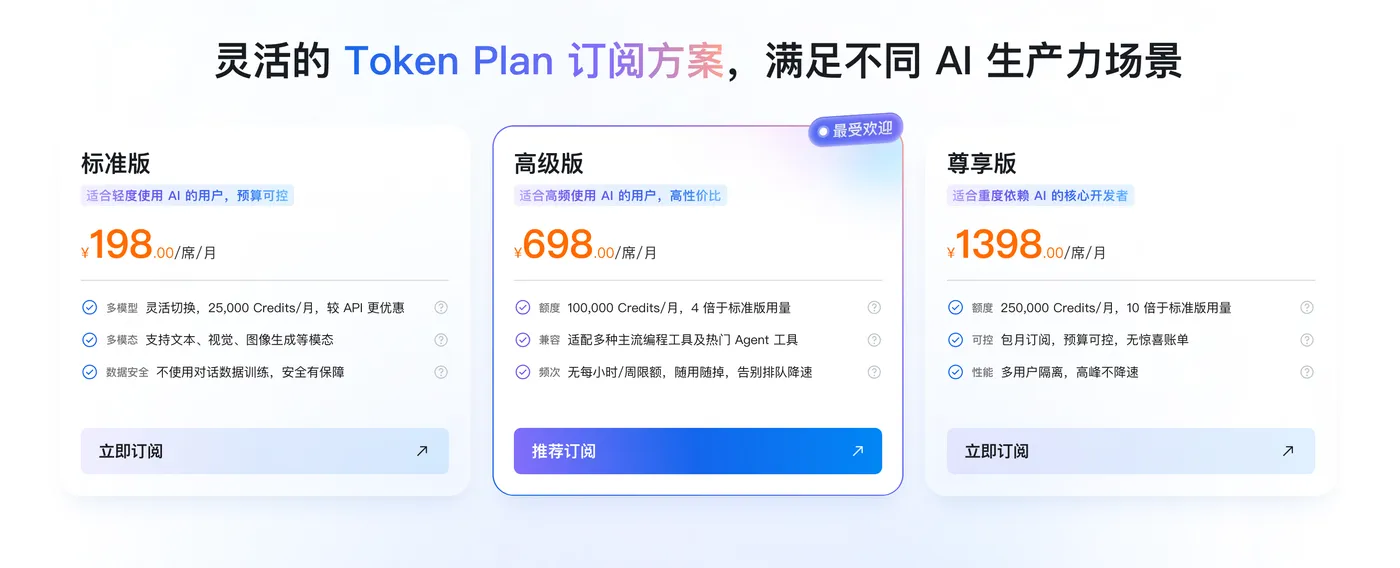
👉访问订阅阿里云百炼Token Plan AI大模型服务 。支持多模型切换,用于多模态模型灵活调用,实现多模型、多工具、多场景下的额度共享与统一管理,兼顾灵活性、稳定性与安全性,大幅降低企业使用大模型的门槛与成本。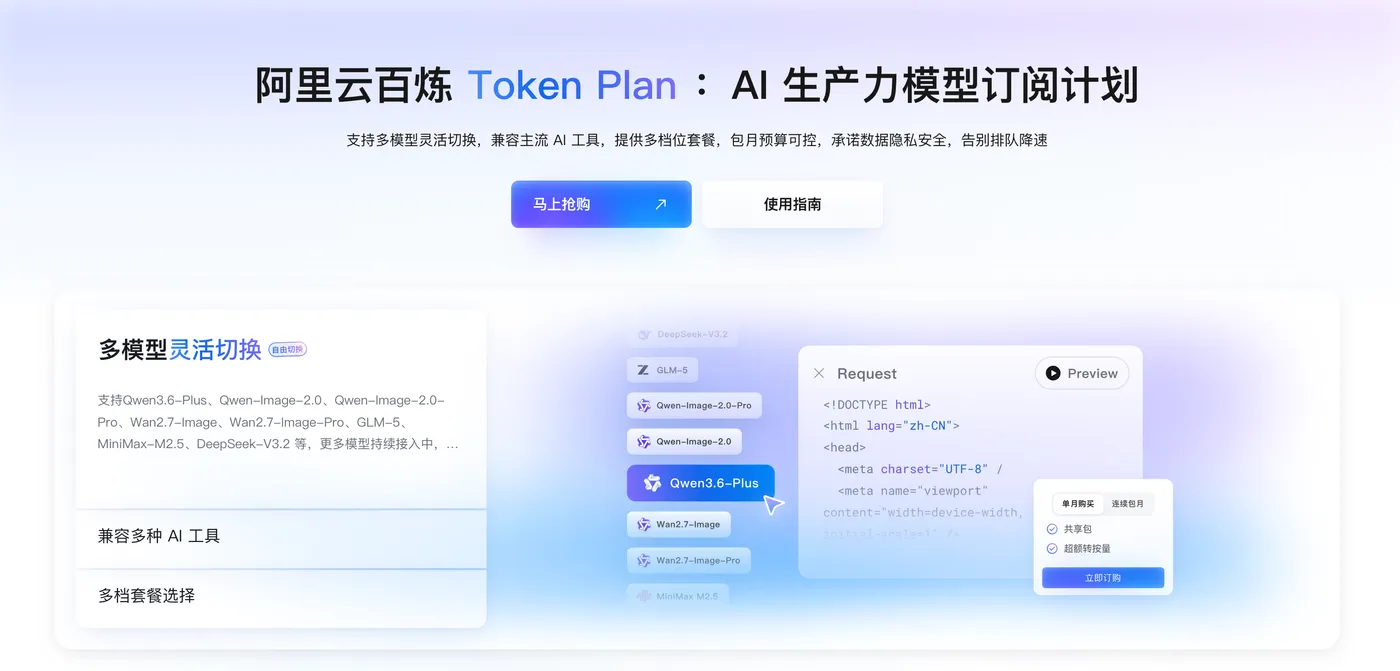
二、企业为什么必须搭建私有RAG知识库
在传统使用大模型的模式下,企业直接调用公有大模型接口,只能依赖模型固有训练知识,无法适配内部业务。而搭建私有RAG知识库,可以从根本上解决三大核心痛点。
第一,保障数据隐私可控。所有企业文档、业务资料全部保留在企业本地或私有服务器中,无需上传第三方公有平台,全程私有化处理,从源头规避数据泄露、合规风险,适合金融、政务、制造业、互联网等对数据安全要求高的行业。
第二,补足领域专业知识。通过导入企业内部制度、行业白皮书、技术文档、项目资料,让大模型学习专属领域知识,不再泛泛而谈,回答内容贴合企业业务逻辑与行业规范。
第三,支持实时动态更新。企业最新政策、新产品资料、临时通知等文档可以随时新增入库,知识库实时同步更新,大模型可以及时掌握最新信息,不受训练时间限制。
除此之外,私有知识库还能实现员工智能问答、新人培训答疑、制度快速检索、项目资料查阅等实用功能,大幅降低内部知识查找成本,提升办公效率。
三、RAG技术核心原理
RAG全称为检索增强生成,由检索与增强生成两大核心部分组成。整套运行逻辑简单清晰,形成标准化闭环流程:用户提出问题之后,系统不会直接让大模型凭空作答,而是先在私有向量知识库中检索与问题高度相关的文档片段,再将检索到的内容作为上下文输入给大模型,大模型依托私有知识结合自身能力生成专业准确的答案。
简单理解就是先把企业所有文档处理成向量存入专属数据库,用户提问先找相关资料,再基于资料回答,彻底摆脱大模型凭空编造、不懂业务的问题。整个流程把私有数据和大模型能力完美结合,兼顾安全性、专业性与准确性。
四、私有知识库整体技术架构
整套企业私有知识库采用标准化流水线架构,分为文档处理、向量存储、检索匹配、大模型生成四大核心环节。
首先是文档接入环节,支持PDF、TXT、DOCX等主流办公文档,也可拓展接入网页内容、知识库平台资料。随后进行文本分块,将长篇文档拆分为合适大小的文本片段,避免上下文超限。接着通过嵌入模型将文本转为向量数据,存入向量数据库持久化保存。
用户发起提问后,问题同样进行向量化处理,在向量数据库中进行相似度检索,匹配最相关的文档片段。最后将检索结果作为参考上下文送入大模型,由大模型整合信息生成完整回答,形成完整问答闭环。整套架构逻辑清晰,模块化设计便于后期拓展与功能升级。
五、环境依赖准备
搭建私有RAG知识库需要基于Python环境开发,推荐使用Python3.10及以上版本,通过安装相关依赖库即可快速搭建运行环境。所需核心依赖包含文档加载解析工具、向量数据库、大模型调用框架、网页部署框架等,安装依赖后即可进入代码开发阶段,无需复杂额外配置。
六、完整私有知识库代码实现
基于LangChain框架结合向量数据库,可快速开发一套支持多文档加载、自动分块、向量存储、智能检索问答的私有知识库系统。代码封装成独立类,包含文档加载、文本拆分、向量库构建、向量库加载、问答链初始化、智能提问等完整方法。
系统支持遍历指定文件夹自动识别PDF、TXT、DOCX格式文件,自动加载解析,异常文件自动跳过并提示。可自定义文本分块大小与重叠长度,适配不同类型文档。向量数据库支持持久化保存,首次构建后下次可直接加载,无需重复处理文档。同时可设置检索数量、模型随机性参数,平衡回答准确性与灵活性。运行后进入交互式问答模式,输入问题即可获取答案与参考文档来源,输入指定指令即可退出程序。
七、拓展多数据源接入
基础版本支持本地办公文档,还可以灵活拓展更多数据源,满足企业多元化知识接入需求。
可以接入企业官网、行业资讯网页内容,通过网页加载器抓取页面文本,经过分块向量化后纳入知识库,实现官网业务信息智能问答。同时支持接入Notion等在线协作知识库平台,直接导入平台文档内容,打通云端协作资料与本地私有知识库,实现知识统一管理。多种数据源无缝接入,让企业知识汇聚到同一套RAG系统中。
八、替换国产大模型降低使用成本
默认框架可接入海外大模型,但调用成本偏高,且存在网络访问问题。可以直接替换为阿里通义千问等国产大模型,适配国内网络环境,大幅降低调用费用,同时更贴合中文语境理解。也可以选择本地开源模型部署,完全脱离第三方接口,实现百分百离线私有化运行,适合高度涉密企业场景。
替换方式简单,只需修改模型调用配置,无需改动知识库整体逻辑,兼容性极强,可按需灵活切换公有接口模型与本地开源模型。
九、知识库效果高级优化技巧
想要进一步提升RAG问答准确率与使用体验,可以从分块策略、检索方式、重排序三个维度优化。
首先是定制文档分块策略,不同类型文档采用不同分块规格。技术文档拆分粒度更小,保证代码与逻辑片段完整;政策制度类文档采用较大分块尺寸,保持段落语义完整,避免拆分破坏上下文逻辑。
其次采用混合检索模式,将向量语义检索与关键词检索相结合,设置权重配比,兼顾语义匹配与关键词精准命中,大幅提升检索相关度。
最后引入重排序机制,初次检索出多条内容后,通过重排模型按照相关性重新打分排序,筛选最优片段送入大模型,剔除低相关冗余内容,让回答更加精准凝练。
十、界面搭建与部署上线
开发完成后可以通过Streamlit快速搭建轻量化网页交互界面,无需前端开发,几行代码即可实现网页版知识库问答。界面包含问题输入框、答案展示区、参考来源折叠面板,布局简洁直观,企业员工可直接在浏览器使用。
配置服务端口后,通过一条启动命令即可运行项目,本地局域网内均可访问,也可部署在服务器实现全员共用,开箱即用、部署极简。
十一、常见问题排查与解决
在搭建和使用过程中,常会遇到检索不到内容、回答不准确、响应速度慢等问题。
检索不到相关内容时,需要检查文档是否正常加载,合理调整文本分块大小,适当增加检索条目数量,提升匹配概率。回答空洞不准确时,可以在提示词中加入角色定位,调低模型随机温度参数,严格依赖检索内容生成答案。响应速度偏慢可以启用流式输出,替换本地嵌入模型,开启缓存机制减少重复计算,有效提升响应效率。
十二、总结
RAG检索增强生成技术,是企业搭建私有知识库、落地大模型业务应用的必经之路。通过本文完整实操流程,可以从零完成环境搭建、代码开发、多数据源接入、国产模型替换、效果优化与网页部署,轻松搭建一套安全、私密、专业的企业智能问答知识库。
整套方案架构轻量化、开发成本低、部署简单,既可以小型团队内部使用,也可以规模化部署给全公司员工共用。既能保护企业核心数据不对外泄露,又能让大模型深度理解内部业务与行业知识,彻底解决通用模型不懂业务、数据不安全、信息不实时的三大难题。
掌握这套RAG私有知识库搭建方法后,企业可以按需持续新增文档、拓展数据源、优化检索策略,不断沉淀内部知识资产,借助AI能力实现知识快速检索、智能答疑、新人培训、业务辅助,全面提升企业数字化办公与知识管理效率。


