最近大模型风口持续火爆,不管是求职、副业、技术深耕,绕不开的第一件事,就是系统搞懂到底什么是大模型。像我刚入门只会跟风听GPT、通义千问、DeepSeek,但对大模型的核心定义、为什么突然爆发、怎么衡量规模、有哪些分类完全一头雾水。
今天就用接地气的大白话,带大家完整梳理大模型入门知识点,帮你建立最基础的全局认知,后续学微调、RAG、智能体都能事半功倍。
一、到底什么是大模型?
行业内其实没有统一官方定义,我们不用纠结学术拗口表述,记住核心特质就行:
大模型就是训练数据海量、参数规模巨大、综合能力极强的深度神经网络模型。
这里有一个硬核划分标准,记死就够了:
- 小模型:参数量 小于10亿
- 大模型:参数量 10亿以上
目前主流模型量级大家可以有个直观概念:
- BERT 约3亿参数
- GPT-3 达到1750亿参数
- DeepSeek-V3 更是冲到6710亿级别
- 顶尖模型早已迈入万亿参数时代
像我们常玩的通义千问Qwen3系列,覆盖了0.6B、1.7B、4B、8B、14B一直到235B全梯度版本,本地部署、线上调用、私有化场景全都能覆盖,不同尺寸对应不同硬件和业务需求。
二、大模型为什么会横空出世?不是偶然,是三方合力
很多人好奇:为什么最近几年大模型突然爆发?其实完全不是凭空出现,是数据、算力、模型架构三者长期演进,刚好走到爆发节点的结果。
1. 数据够多:从人工标注到自监督学习
传统机器学习最大的痛点:高度依赖人工标注数据。
不管是图像分类、命名实体识别、情感分析还是语音转写,都要花钱花人力手动打标签,成本高、数据规模根本做不大,上限一眼望到头。
而大模型彻底换了训练范式——自监督学习。
简单说就是:不用人工打标签,模型自己从海量原始数据里挖掘内在规律、自动生成伪标签训练,最典型的就是「预测下一个token」。
这下直接打破了数据瓶颈:
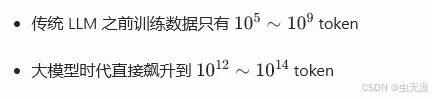
就拿Qwen3来说,预训练直接用了36万亿token语料,这是传统机器学习完全不敢想象的体量。
2. 算力够强:硬件迭代+分布式训练成熟
深度学习本质就是大规模矩阵运算,天生适配GPU、TPU这类并行计算芯片。
一方面,英伟达GPU架构年年迭代,从Kepler、Maxwell一路到最新Blackwell,旗舰B200半精度峰值算力达到5PFLOPS(每秒5千万亿次浮点运算),单卡算力直接拉满。
另一方面,分布式训练技术彻底成熟,三种并行方式撑起超大规模模型训练:
- 数据并行:每块显卡存完整模型副本,各自处理不同数据子集,最后聚合梯度同步更新参数
- 张量并行:把模型权重矩阵按维度切分到多卡,各设备只计算部分张量,再通过通信合并结果
- 流水线并行:将模型按层拆分成多个阶段,分配到不同设备,数据以流水线方式依次传递计算
有了高端硬件+分布式训练体系,千亿、万亿参数大模型的训练才从理论落地为现实。
3. 架构合理:Transformer 成为底层基石
大模型能做大还能保持性能不掉线,最大功臣就是Transformer架构。
它核心两大优势:
- 原生支持并行计算,训练效率吊打传统RNN、LSTM序列模型
- 具备极佳可扩展性:模型参数、训练数据、训练步数越大,模型效果稳定收益越高,损失函数持续优化下降
毫不夸张地说,没有Transformer架构,就没有如今百花齐放的大模型时代。
简单小结
数据提供训练原料、算力提供硬件动力、Transformer提供架构底座,三者协同演进、完美契合,共同催生了全民大模型时代。
三、大模型三大计量单位,入门必懂避坑
聊大模型永远绕不开各类专业单位,新手很容易被B、T、PFLOPS绕晕,我整理成极简易懂版本,看完直接上手无压力。
1. 参数规模:B为单位
B 是 Billion 缩写,代表 10亿参数
- 7B模型 = 70亿参数
- 14B模型 = 140亿参数
2. 训练数据集规模:Token 为核心
大模型训练前会把文本切分为最小语义单元 Token,也是衡量语料规模的标准: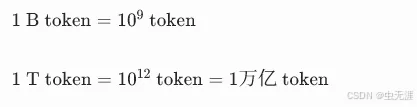
实用小常识:
- 1个英文字符 ≈ 0.3 个 Token
- 1个中文字符 ≈ 0.6 个 Token
简单理解:Token 就是大模型听懂人类语言的基础最小单位。
3. 计算规模:FLOPS 浮点运算
用来衡量大模型训练消耗的计算量:
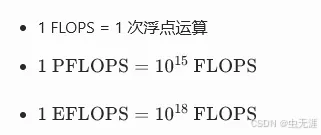
后续看论文、模型参数海报,看到这些单位就能一眼看懂模型体量和训练成本。
四、大模型完整分类体系
日常我们随口说的「大模型」,默认特指大语言模型。行业里有两套标准分类维度:按模态划分、按功能划分。
1. 按模态分类
模态指人和机器感知世界的方式:文本、图像、音频、视频都属于不同模态。
| 类别 | 核心特点 | 输入输出 | 典型代表 |
|---|---|---|---|
| 大语言模型 LLM | 仅处理文本,大模型生态核心 | 文本输入 → 文本输出 | Qwen3、DeepSeek-V3、GPT-5语言模块 |
| 多模态理解模型 | 融合图文音视频,统一语义空间 | 多模态输入 → 文本理解输出 | Qwen3-VL、GPT-5、Gemini-3 |
| 多模态生成模型 | 不仅能理解,还能跨模态创作 | 文本/图像输入 → 图/音/视频输出 | Stable Diffusion、DALL·E、Sora |
2. 按功能与输出形态分类
做工程落地、RAG、Agent 开发,这套分类更具实战价值。
生成式大模型
自回归逐Token生成内容,从无到有创作文本、图像、音视频。
- 核心任务:内容生成
- 适用场景:对话、写作、推理、代码生成、RAG最终回答
- 特点:参数规模大、计算成本极高
嵌入模型
不生成文本,将文本/图像转为高维向量,语义相近内容向量空间距离更近。
- 核心任务:语义编码表征
- 适用场景:知识库检索、语义搜索、推荐系统
- 代表模型:BGE、E5、GTE
重排序模型
对粗检索结果做精细化语义打分,把高相关内容置顶。
- 核心任务:相关性排序
- 适用场景:RAG精排、搜索引擎排序优化
分类模型
输出离散类别标签或概率分布,多用于判别类任务。
- 核心任务:类别预测
- 适用场景:情感分析、垃圾邮件识别、意图分类
- 特点:多为微调小模型,成本低、落地快
3.类模型协同工作流程
真实企业项目中都是组合使用:
嵌入模型将知识库文档向量化入库 → 用户查询向量化检索候选文档 → 重排序模型精排筛选 → 分类模型做意图/风险过滤 → 生成式大模型产出最终答案
这也是目前工业级 RAG 系统的标准架构。
五、大模型开源 vs 闭源 深度对比
入门必须搞懂开源与闭源模型的区别、商业逻辑和行业现状。
大模型四要素
模型权重、推理代码、训练代码、训练数据集。
- 开源大模型:主要开源权重+推理代码,训练代码和核心数据集基本保密
- 闭源大模型:权重、代码、内部实现全保密,纯黑盒模式
开源 vs 闭源对比
| 维度 | 开源大模型 | 闭源大模型 |
|---|---|---|
| 透明度 | 代码算法透明,可审计可二次开发 | 内部机制黑盒,无法溯源 |
| 可访问性 | 免费开源,无使用门槛 | 需授权,多为API付费调用 |
| 定制能力 | 支持私有化部署、深度微调 | 仅可调整API参数,定制受限 |
| 迭代速度 | 社区协同开发,迭代快 | 依赖厂商团队,迭代节奏慢 |
| 成本结构 | 免费使用,需自备硬件运维 | 按Token计费,前期轻、长期成本高 |
| 技术支持 | 依赖社区交流,无官方专属支持 | 提供企业级专属运维与技术服务 |
商业逻辑与主流混合模式
- 开源逻辑:用免费模型做技术扩散,吸引开发者共建生态,靠云服务、行业解决方案、企业定制变现。
- 闭源逻辑:技术垄断构建护城河,通过API订阅、企业定制、专利授权直接盈利。
- 行业主流:开源引流,闭源变现
Gemini+Gemma、Meta Llama、阿里通义千问、百度文心均采用这套模式:开源拉新做生态,闭源承接高端企业付费业务。
写在最后
本文是大模型入门的地基,复盘核心重点:
- 大模型判定标准:参数超10亿,由数据、算力、Transformer 架构三方合力催生;
- 掌握参数、Token、FLOPS 三大核心计量单位;
- 分清模态分类、功能分类,理解四类模型协同落地逻辑;
- 吃透开源与闭源的差异、商业逻辑与行业主流策略。
如果对本文内容稍微有点了解,后续学习大模型训练范式、RAG、提示词工程、智能体开发都会一路顺畅。我会持续更新大模型全系列干货,从零基础到工程落地全覆盖,欢迎持续关注!