如何优化Python读取大文件的内存占用与性能

简介: 如何优化Python读取大文件的内存占用与性能


本文介绍了如何通过逐行读取、生成器、内存映射和使用pandas库等方法优化Python读取大文件,降低内存占用,提高性能,以避免程序因内存过大而崩溃。

摘要由CSDN通过智能技术生成

如何优化Python读取大文件的内存占用与性能

在实际的数据处理工作中,经常会遇到需要处理大文件的情况。而在Python中,如果不加以优化,处理大文件时很容易遇到内存占用过高的问题,甚至导致程序崩溃。本文将介绍如何优化Python读取大文件的内存占用与性能,并给出相应的代码示例。

首先,让我们来看看一段简单的Python代码,用于读取一个大文件并逐行处理:

with open('large_file.txt', 'r') as f:
    for line in f:
        process_line(line)

这段代码看起来很简单直观,但是如果文件非常大,比如几GB甚至更大,就会出现内存占用过高的问题。原因在于上述代码一次性将整个文件加载到内存中,导致内存占用过高。

为了解决这个问题,我们可以采用逐行读取的方式,即每次只读取一行,处理完毕后立即释放内存。下面是优化后的代码示例:

def read_large_file(file_path):
    with open(file_path, 'r') as f:
        while True:
            line = f.readline()
            if not line:
                break
            process_line(line)

在优化后的代码中,我们使用了一个while循环来逐行读取文件,并在处理完每一行后立即释放内存。这样就可以避免一次性加载整个文件到内存中,从而降低内存占用。

另外,为了进一步降低内存占用,我们还可以使用生成器来逐行读取文件。生成器是一种特殊的迭代器,可以在迭代过程中动态生成值,而不是一次性生成所有值。下面是使用生成器优化后的代码示例:

def read_large_file_generator(file_path):
    with open(file_path, 'r') as f:
        for line in f:
            yield line
for line in read_large_file_generator('large_file.txt'):
    process_line(line)

在这段优化后的代码中,我们定义了一个生成器函数read_large_file_generator,用于逐行读取文件。然后在处理数据时,我们只需要遍历生成器即可,而不需要一次性加载整个文件到内存中。

除了逐行读取文件以外,我们还可以使用内存映射文件来优化内存占用。内存映射文件是一种将文件映射到内存中的技术,可以在内存中直接操作文件,而不需要将整个文件加载到内存中。下面是使用内存映射文件优化后的代码示例:

import mmap
def read_large_file_mmap(file_path):
    with open(file_path, 'r') as f:
        with mmap.mmap(f.fileno(), 0, access=mmap.ACCESS_READ) as m:
            for line in iter(m.readline, b''):
                process_line(line.decode('utf-8'))

在这段优化后的代码中,我们使用了mmap.mmap函数将文件映射到内存中,并使用iter函数逐行读取文件。这样就可以在内存中直接操作文件,而不需要将整个文件加载到内存中。

除了以上提到的优化方式以外,我们还可以使用第三方库来优化文件读取性能,比如使用pandas库中的read_csv函数来逐块读取大型CSV文件。另外,我们还可以使用多线程或多进程来并行读取文件,从而提高文件读取性能。

在处理大文件时,我们需要注意优化内存占用与性能,避免一次性加载整个文件到内存中。通过逐行读取、使用生成器、内存映射文件以及使用第三方库等方式,可以有效降低内存占用,并提高文件读取性能。


相关文章
|
机器学习/深度学习 算法 PyTorch
125_训练加速:FlashAttention集成 - 推导注意力优化的独特内存节省
2025年,大型语言模型的训练面临着前所未有的挑战。随着模型参数量和序列长度的不断增加,传统注意力机制的内存瓶颈问题日益突出。FlashAttention作为一种突破性的注意力算法,通过创新的内存访问模式和计算优化,显著提升了训练效率和内存利用。
1165 3
|
存储 机器学习/深度学习 PyTorch
119_LLM训练的高效内存管理与优化技术:从ZeRO到Flash Attention
大型语言模型(LLM)的训练面临着前所未有的计算和内存挑战。随着模型规模达到数百亿甚至数千亿参数,高效的内存管理成为训练成功的关键因素之一。2025年,LLM训练的内存优化技术已经取得了显著进展,从ZeRO优化器到Flash Attention等创新技术,为训练超大规模模型提供了可能。
1102 159
|
机器学习/深度学习 数据采集 算法
Python AutoML框架选型攻略:7个工具性能对比与应用指南
本文系统介绍了主流Python AutoML库的技术特点与适用场景,涵盖AutoGluon、PyCaret、TPOT、Auto-sklearn、H2O AutoML及AutoKeras等工具,帮助开发者根据项目需求高效选择自动化机器学习方案。
1701 1
|
缓存 固态存储 Windows
如何让内存发挥到最大效能?全面优化指南,提升电脑运行体验
电脑内存使用不合理会导致卡顿,本文教你如何优化内存性能。检查内存容量与主板支持上限,考虑升级或调整配置;关闭后台程序、管理浏览器标签、结束异常进程以释放内存;设置虚拟内存、调整视觉效果、定期重启提升效率;必要时增加内存条、选择高频内存、更换固态硬盘。避免盲目清理内存和依赖大内存忽视其他硬件瓶颈。只需合理设置,无需额外花钱,就能显著提升电脑速度。
|
存储 大数据 Unix
Python生成器 vs 迭代器:从内存到代码的深度解析
在Python中,处理大数据或无限序列时,迭代器与生成器可避免内存溢出。迭代器通过`__iter__`和`__next__`手动实现,控制灵活;生成器用`yield`自动实现,代码简洁、内存高效。生成器适合大文件读取、惰性计算等场景,是性能优化的关键工具。
600 2
|
存储 人工智能 自然语言处理
AI代理内存消耗过大?9种优化策略对比分析
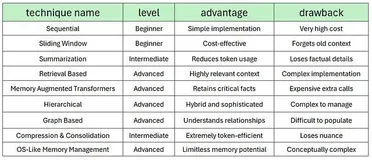
在AI代理系统中,多代理协作虽能提升整体准确性,但真正决定性能的关键因素之一是**内存管理**。随着对话深度和长度的增加,内存消耗呈指数级增长,主要源于历史上下文、工具调用记录、数据库查询结果等组件的持续积累。本文深入探讨了从基础到高级的九种内存优化技术,涵盖顺序存储、滑动窗口、摘要型内存、基于检索的系统、内存增强变换器、分层优化、图形化记忆网络、压缩整合策略以及类操作系统内存管理。通过统一框架下的代码实现与性能评估,分析了每种技术的适用场景与局限性,为构建高效、可扩展的AI代理系统提供了系统性的优化路径和技术参考。
1102 4
AI代理内存消耗过大?9种优化策略对比分析
|
传感器 数据采集 监控
Python生成器与迭代器:从内存优化到协程调度的深度实践
简介:本文深入解析Python迭代器与生成器的原理及应用,涵盖内存优化技巧、底层协议实现、生成器通信机制及异步编程场景。通过实例讲解如何高效处理大文件、构建数据流水线,并对比不同迭代方式的性能特点,助你编写低内存、高效率的Python代码。
508 0
|
数据采集 存储 Web App开发
Python爬虫库性能与选型实战指南:从需求到落地的全链路解析
本文深入解析Python爬虫库的性能与选型策略,涵盖需求分析、技术评估与实战案例,助你构建高效稳定的数据采集系统。
1070 0
|
存储 人工智能 API
AI代理性能提升实战:LangChain+LangGraph内存管理与上下文优化完整指南
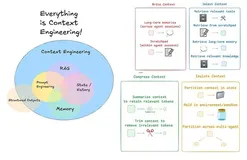
在AI代理系统开发中,上下文工程成为提升系统性能的关键技术。本文探讨了从提示工程到上下文工程的转变,强调其通过为AI系统提供背景信息和工具支持,显著提升智能化程度和实用价值。文章系统分析了上下文工程的理论基础、核心策略(如写入、选择、压缩和隔离),并结合LangChain和LangGraph工具,展示了如何实现上下文工程技术以优化AI代理性能。通过Scratchpad机制、内存管理、RAG系统集成、多代理架构及沙盒环境等技术手段,开发者可以更高效地构建高性能、可扩展的AI系统。
1853 0
AI代理性能提升实战:LangChain+LangGraph内存管理与上下文优化完整指南
|
消息中间件 存储 关系型数据库
千亿消息“过眼云烟”?Kafka把硬盘当内存用的性能魔法,全靠这一手!
Apache Kafka 是由 LinkedIn 开发并捐赠给 Apache 基金会的分布式消息队列系统,具备高吞吐、可扩展和容错能力。其核心设计围绕主题、分区、分段和偏移量展开,通过顺序写入磁盘和 Page Cache 提升性能,广泛应用于大数据实时处理场景。
573 0

推荐镜像

更多