基于爬虫和机器学习的招聘数据分析与可视化系统,python django框架,前端bootstrap,机器学习有八种带有可视化大屏和后台

简介: 本文介绍了一个基于Python Django框架和Bootstrap前端技术,集成了机器学习算法和数据可视化的招聘数据分析与可视化系统,该系统通过爬虫技术获取职位信息,并使用多种机器学习模型进行薪资预测、职位匹配和趋势分析,提供了一个直观的可视化大屏和后台管理系统,以优化招聘策略并提升决策质量。

在现代招聘领域,数据驱动的决策已成为提升招聘效率和质量的关键因素。基于爬虫技术和机器学习算法,结合Django框架和Bootstrap前端技术,我们开发了一套完整的招聘数据分析与可视化系统。该系统旨在帮助企业从海量招聘信息中提取有价值的数据,进行深入的分析和预测,从而优化招聘策略。

系统架构与技术栈

数据获取与处理

系统使用Python编写的爬虫程序,定期从主流招聘网站(如前程无忧等)自动抓取最新的职位信息。这些信息包括职位名称、公司名称、职位描述、薪资范围、工作地点、发布日期等。爬虫程序使用了Scrapy框架,确保高效稳定的数据获取,同时结合了正则表达式和BeautifulSoup进行数据清洗和初步处理。

数据存储与管理

抓取到的数据存储在MySQL数据库中,通过Django ORM进行管理。Django框架提供了便捷的数据库操作接口,使得数据的增删改查变得更加高效。此外,Django后台管理系统也为管理员提供了友好的数据管理界面。

机器学习模型

系统采用了八种不同的机器学习模型,用于招聘数据的分析与预测。这些模型包括:

线性回归(Linear Regression)
逻辑回归(Logistic Regression)
决策树(Decision Tree)
随机森林(Random Forest)
支持向量机(SVM)
K近邻算法(K-Nearest Neighbors, KNN)
朴素贝叶斯(Naive Bayes)
神经网络(Neural Network)
这些模型被应用于薪资预测、职位匹配、招聘趋势分析等任务。为了提高模型的准确性,我们使用了交叉验证和参数调优技术。

数据可视化

前端采用Bootstrap框架,结合D3.js和Chart.js实现了丰富的数据可视化功能。大屏可视化展示包括招聘市场的整体趋势、不同职位的需求分布、薪资水平分析等。这些图表和图形不仅直观,还能通过交互操作获得更深入的信息。

系统后台

Django的后台管理系统为管理员提供了强大的数据管理和系统配置功能。管理员可以通过后台管理招聘数据、查看分析报告、调整爬虫参数、管理用户权限等。系统还集成了用户认证和权限管理功能,确保数据的安全性和隐私性。

研究背景与应用前景

本系统的研究背景涉及大数据分析、自然语言处理、机器学习以及前端可视化技术。在开发过程中,我们参考了大量相关文献和行业报告,结合实际需求进行技术选型和方案设计。

该系统在实际应用中具有广泛的前景:

企业招聘:帮助企业快速筛选和匹配候选人,优化招聘流程,节省人力成本。
职业规划:为求职者提供职业建议,帮助其了解市场需求和薪资水平,制定合理的职业规划。
教育培训机构:提供市场需求分析,帮助调整课程设置和培训内容,提升培训效果。
通过这一系统,我们不仅提升了招聘效率和决策质量,还为招聘市场的数据化和智能化发展提供了有力支持。

效果如下图:

相关文章
|
数据采集 自动驾驶 Java
PAI-TurboX:面向自动驾驶的训练推理加速框架
PAI-TurboX 为自动驾驶场景中的复杂数据预处理、离线大规模模型训练和实时智能驾驶推理,提供了全方位的加速解决方案。PAI-Notebook Gallery 提供PAI-TurboX 一键启动的 Notebook 最佳实践
|
数据采集 数据可视化 搜索推荐
Python数据分析全流程指南:从数据采集到可视化呈现的实战解析
在数字化转型中,数据分析成为企业决策核心,而Python凭借其强大生态和简洁语法成为首选工具。本文通过实战案例详解数据分析全流程,涵盖数据采集、清洗、探索、建模、可视化及自动化部署,帮助读者掌握从数据到业务价值的完整技能链。
1552 0
|
机器学习/深度学习 人工智能 算法
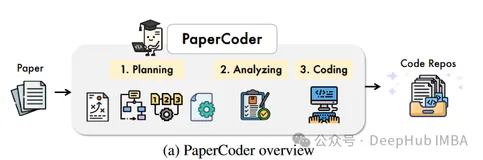
PaperCoder:一种利用大型语言模型自动生成机器学习论文代码的框架
PaperCoder是一种基于多智能体LLM框架的工具,可自动将机器学习研究论文转化为代码库。它通过规划、分析和生成三个阶段,系统性地实现从论文到代码的转化,解决当前研究中代码缺失导致的可复现性问题。实验表明,PaperCoder在自动生成高质量代码方面显著优于基线方法,并获得专家高度认可。这一工具降低了验证研究成果的门槛,推动科研透明与高效。
1197 19
PaperCoder:一种利用大型语言模型自动生成机器学习论文代码的框架
|
机器学习/深度学习 人工智能 算法
Post-Training on PAI (3):PAI-ChatLearn,PAI 自研高性能强化学习框架
人工智能平台 PAI 推出了高性能一体化强化学习框架 PAI-Chatlearn,从框架层面解决强化学习在计算性能和易用性方面的挑战。
|
机器学习/深度学习 算法 数据挖掘
PyTabKit:比sklearn更强大的表格数据机器学习框架
PyTabKit是一个专为表格数据设计的新兴机器学习框架,集成了RealMLP等先进深度学习技术与优化的GBDT超参数配置。相比传统Scikit-Learn,PyTabKit通过元级调优的默认参数设置,在无需复杂超参调整的情况下,显著提升中大型数据集的性能表现。其简化API设计、高效训练速度和多模型集成能力,使其成为企业决策与竞赛建模的理想工具。
676 12
PyTabKit:比sklearn更强大的表格数据机器学习框架
|
机器学习/深度学习 人工智能 分布式计算
Post-Training on PAI (1):一文览尽开源强化学习框架在PAI平台的应用
Post-Training(即模型后训练)作为大模型落地的重要一环,能显著优化模型性能,适配特定领域需求。相比于 Pre-Training(即模型预训练),Post-Training 阶段对计算资源和数据资源需求更小,更易迭代,因此备受推崇。近期,我们将体系化地分享基于阿里云人工智能平台 PAI 在强化学习、模型蒸馏、数据预处理、SFT等方向的技术实践,旨在清晰地展现 PAI 在 Post-Training 各个环节的产品能力和使用方法,欢迎大家随时交流探讨。
|
机器学习/深度学习 人工智能 自然语言处理
阿里云人工智能平台 PAI 开源 EasyDistill 框架助力大语言模型轻松瘦身
本文介绍了阿里云人工智能平台 PAI 推出的开源工具包 EasyDistill。随着大语言模型的复杂性和规模增长,它们面临计算需求和训练成本的障碍。知识蒸馏旨在不显著降低性能的前提下,将大模型转化为更小、更高效的版本以降低训练和推理成本。EasyDistill 框架简化了知识蒸馏过程,其具备多种功能模块,包括数据合成、基础和进阶蒸馏训练。通过数据合成,丰富训练集的多样性;基础和进阶蒸馏训练则涵盖黑盒和白盒知识转移策略、强化学习及偏好优化,从而提升小模型的性能。
|
人工智能 自然语言处理 算法
MT-MegatronLM:国产训练框架逆袭!三合一并行+FP8黑科技,大模型训练效率暴涨200%
MT-MegatronLM 是摩尔线程推出的面向全功能 GPU 的开源混合并行训练框架,支持多种模型架构和高效混合并行训练,显著提升 GPU 集群的算力利用率。
1277 18
|
机器学习/深度学习 人工智能
Diff-Instruct:指导任意生成模型训练的通用框架,无需额外训练数据即可提升生成质量
Diff-Instruct 是一种从预训练扩散模型中迁移知识的通用框架,通过最小化积分Kullback-Leibler散度,指导其他生成模型的训练,提升生成性能。
524 11
Diff-Instruct:指导任意生成模型训练的通用框架,无需额外训练数据即可提升生成质量
|
机器学习/深度学习 人工智能 Java
Java机器学习实战:基于DJL框架的手写数字识别全解析
在人工智能蓬勃发展的今天,Python凭借丰富的生态库(如TensorFlow、PyTorch)成为AI开发的首选语言。但Java作为企业级应用的基石,其在生产环境部署、性能优化和工程化方面的优势不容忽视。DJL(Deep Java Library)的出现完美填补了Java在深度学习领域的空白,它提供了一套统一的API,允许开发者无缝对接主流深度学习框架,将AI模型高效部署到Java生态中。本文将通过手写数字识别的完整流程,深入解析DJL框架的核心机制与应用实践。
1085 3

热门文章

最新文章

  • 1
    前端如何存储数据:Cookie、LocalStorage 与 SessionStorage 全面解析
    1423
  • 2
    【CSS】前端三大件之一,如何学好?从基本用法开始吧!(九):强势分析Animation动画各类参数;从播放时间、播放方式、播放次数、播放方向、播放状态等多个方面,完全了解CSS3 Animation
    699
  • 3
    【CSS】前端三大件之一,如何学好?从基本用法开始吧!(八):学习transition过渡属性;本文学习property模拟、duration过渡时间指定、delay时间延迟 等多个参数
    561
  • 4
    【CSS】前端三大件之一,如何学好?从基本用法开始吧!(七):学习ransform属性;本文学习 rotate旋转、scale缩放、skew扭曲、tanslate移动、matrix矩阵 多个参数
    569
  • 5
    【CSS】前端三大件之一,如何学好?从基本用法开始吧!(六):全方面分析css的Flex布局,从纵、横两个坐标开始进行居中、两端等元素分布模式;刨析元素间隔、排序模式等
    653
  • 6
    【CSS】前端三大件之一,如何学好?从基本用法开始吧!(五):背景属性;float浮动和position定位;详细分析相对、绝对、固定三种定位方式;使用浮动并清除浮动副作用
    834
  • 7
    【CSS】前端三大件之一,如何学好?从基本用法开始吧!(四):元素盒子模型;详细分析边框属性、盒子外边距
    1635
  • 8
    【CSS】前端三大件之一,如何学好?从基本用法开始吧!(三):元素继承关系、层叠样式规则、字体属性、文本属性;针对字体和文本作样式修改
    393
  • 9
    【CSS】前端三大件之一,如何学好?从基本用法开始吧!(二):CSS伪类:UI伪类、结构化伪类;通过伪类获得子元素的第n个元素;创建一个伪元素展示在页面中;获得最后一个元素;处理聚焦元素的样式
    1350
  • 10
    【CSS】前端三大件之一,如何学好?从基本用法开始吧!(一):CSS发展史;CSS样式表的引入;CSS选择器使用,附带案例介绍
    668