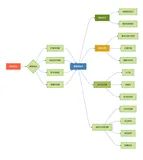
在人工智能领域,多模态模型正逐渐成为研究的热点。其中,CLIP(Contrastive Language-Image Pretraining)模型以其卓越的性能和广泛的应用场景受到了广泛关注。然而,在实际应用中,计算资源的有限性往往成为制约模型性能提升的关键因素。近期的研究在探讨如何在计算资源有限的条件下,优化CLIP模型的性能表现,取得了显著的成果。
一、数据:质量胜过数量,小规模亦可制胜
高质量的训练数据是提升模型性能的基础。在CLIP模型的训练中,数据的选择和处理显得尤为重要。传统观念认为,大规模的数据集能够带来更好的模型性能,但最新的研究却表明,小规模的高质量数据集同样可以取得出色的效果。
这主要得益于数据清洗和预处理技术的进步。在收集数据时,我们需要注意剔除那些低质量、无关或错误的样本,以保证数据集的纯净性。此外,还可以通过数据增强技术来进一步扩充数据集,提高模型的泛化能力。
在实际操作中,我们可以使用Python的图像处理库(如OpenCV)进行数据预处理,通过裁剪、旋转、缩放等操作来增加数据的多样性。同时,利用自然语言处理工具对数据进行清洗和标注,也是提升数据集质量的关键步骤。
python

import cv2
import numpy as np

# 读取图像并进行预处理
image = cv2.imread('path_to_image.jpg')
preprocessed_image = cv2.resize(image, (224, 224))  # 调整图像大小为模型所需的尺寸

# 假设已经对文本进行了相应的清洗和标注处理
text_description = "A cat sitting on a table"
二、架构:ViT与CNN的抉择
在CLIP模型的架构选择中,基于Transformer的视觉模型(ViT)和基于卷积神经网络(CNN)的模型各有优劣。较小的ViT模型更适合小数据集,而较大的模型在固定计算资源下对大数据集的表现更佳。
这一发现为我们在实际应用中提供了指导。当面临计算资源有限且数据集规模较小的情况时,我们可以选择使用较小的ViT模型来减少计算开销,同时保持较好的性能。而当数据集规模较大时,可以考虑使用更大的模型来充分利用数据,提升模型的性能。
在实际构建CLIP模型时,我们可以使用深度学习框架(如TensorFlow或PyTorch)来实现不同架构的模型。下面是一个简化的CLIP模型架构示例代码:
python

import torch
import torch.nn as nn
from transformers import ViTModel, BertModel

class CLIPModel(nn.Module):
    def __init__(self, vision_model, text_model, embedding_dim):
        super(CLIPModel, self).__init__()
        self.vision_model = vision_model
        self.text_model = text_model
        self.embedding_dim = embedding_dim

        # 确保视觉和文本模型的嵌入维度一致
        assert self.vision_model.config.hidden_size == self.text_model.config.hidden_size == self.embedding_dim

    def forward(self, images, texts):
        # 提取图像特征
        image_features = self.vision_model(images).pooler_output

        # 提取文本特征
        input_ids = torch.tensor([self.text_model.tokenizer.encode(text, add_special_tokens=True) for text in texts]).to(images.device)
        attention_mask = (input_ids != self.text_model.tokenizer.pad_token_id).to(torch.float32).to(images.device)
        text_features = self.text_model(input_ids, attention_mask=attention_mask).pooler_output

        return image_features, text_features

# 初始化CLIP模型
vision_model = ViTModel.from_pretrained('google/vit-base-patch16-224-in21k')
text_model = BertModel.from_pretrained('bert-base-uncased')
clip_model = CLIPModel(vision_model, text_model, embedding_dim=768)
三、训练策略:选择合适的方法以应对计算资源的挑战
在训练CLIP模型时,选择合适的训练策略对于提升模型性能至关重要。研究比较了四种CLIP训练策略——SLIP、FLIP、CLIP和CLIP+数据增强,并发现训练策略的选择取决于可用的计算资源。
对于计算资源有限的情况,CLIP+数据增强是一种有效的策略。它可以通过仅使用一半的训练数据达到与CLIP相当的性能,从而在不牺牲性能的前提下减少训练时间和计算成本。
在实际应用中,我们可以根据具体的计算资源和数据集规模来选择合适的训练策略。同时,还可以结合其他优化技术,如学习率调整、梯度累积等,来进一步提升模型的训练效率。
python

# 假设已经定义了优化器optimizer和损失函数criterion
# 在训练循环中,使用数据增强技术来扩充数据集
from torchvision import transforms

# 定义数据增强变换
data_transforms = transforms.Compose([
    transforms.RandomResizedCrop(224),
    transforms.RandomHorizontalFlip(),
    transforms.ToTensor(),
    transforms.Normalize(mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225]),
])

# 在每个训练迭代中,对图像进行增强并传入模型进行训练
for epoch in range(num_epochs):
    for images, texts in dataloader:
        # 对图像进行增强
        augmented_images = data_transforms(images)

        # 前向传播、计算损失、反向传播和优化步骤...
        # ...
综上所述,通过深入研究数据、架构和训练策略三个维度,我们可以在计算资源有限的条件下优化CLIP模型的性能表现。这不仅有助于降低模型的训练成本,还使得CLIP模型在各种应用中更易于获取和负担得起。随着技术的不断进步和研究的深入,相信未来CLIP模型将在更多领域展现出其强大的应用潜力。