技术沙龙直播|3D-Speaker多模态说话人开源详解

简介: 技术沙龙直播|3D-Speaker多模态说话人开源详解

文章来自 阿里语音AI公众号

3D-Speaker是通义实验室语音团队贡献的一个结合声学、语义、视觉三维模态信息来解决说话人任务的开源项目。本项目涵盖说话人日志,说话人识别和语种识别任务,开源了多个任务的工业级模型,训练代码和推理代码。


该项目上线以来,受到了诸多开发者们的关注和喜爱,本次特别推出多种模态结合的新开源代码,并邀请三位代码贡献者工程师进行直播讲解。分享嘉宾:陈亚峰、王绘、程路遥时间:2024年5月22日晚 20:00-21:30

本项目同时还开源了相应的研究数据集3D-Speaker dataset,涵盖了10000人多设备(multi-Device)、多距离(multi-Distance)和多方言(multi-Dialect)的音频数据和文本,适用于远近场、跨设备、方言等高挑战性的语音研究,供各位AI开发爱好者品鉴。


‍▎技术分享环节

NO.1 基于经典声学信息进行说话人和语种识别

3D-Speaker包含基于经典声学信息的说话人识别和语种识别相应的模型和算法。其中,说话人识别模块涵盖全监督说话人识别以及自监督说话人识别。代码提供多种数据增强算法,支持各SOTA模型多卡并行训练以及多种损失函数。NO.2 结合视觉信息的说话人日志

除了传统的纯音频说话人日志路线,3D-Speaker开源了结合视觉信息的技术方案,通过同时挖掘音、视频特征,显著提高在复杂对话场景中的识别准确率。NO.3 结合语义的说话人日志音频中的说话人相关的语义信息不容易受复杂声学场景影响,3D-Speaker开源了相关语义说话人信息建模模块,并探索了语义信息结合的说话人日志技术。NO.4 语义+视觉信息的说话人日志3D-Speaker提出了一种将语义、视觉信息同时作用于基于聚类算法的说话人日志任务的统一框架,将多模态的信息统一建模为成对约束并应用到说话人日志任务中。NO.5 3D-Speaker数据集开源3D-Speaker同时开源了一个研究数据集3D-Speaker dataset,包含多设备(multi-Device)、多距离(multi-Distance)和多方言(multi-Dialect)信息的说话人数据集。

相关开源代码链接:

https://github.com/alibaba-damo-academy/3D-Speaker


魔搭ModelScope社区


‍▎3D-Speaker数据集开源

3D-Speaker同时还开源了相应的研究数据集3D-Speaker dataset,涵盖了10000人多设备(multi-Device)、多距离(multi-Distance)和多方言(multi-Dialect)的音频数据和文本,适用于远近场、跨设备、方言等高挑战性的语音研究。

下载地址:https://3dspeaker.github.io/数据集论文:https://arxiv.org/pdf/2306.15354.pdf

相关实践学习
【涂鸦即艺术】基于云应用开发平台CAP部署AI实时生图绘板
相关文章
|
人工智能 算法 数据挖掘
【技术揭秘】解锁声纹技术中的说话人日志
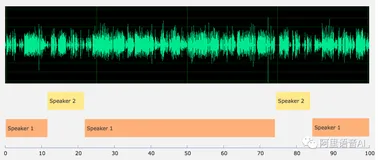
说话人日志(speaker diarization)也叫说话人分离,它是从一个连续的多人说话的语音中切分出不同说话人的片段,并且判断出每个片段是哪个说话人的过程。借助说话人日志技术可以完成对音频数据流的结构化管理,具有广泛的应用价值,例如可以利用分离结果进行说话人自适应,以提高语音识别的准确率;可以辅助会议、电话数据进行自动转写构建说话人的音频档案;也可以利用说话人分离技术,实现语料库的自动跟踪和标注。
【技术揭秘】解锁声纹技术中的说话人日志
|
人工智能 语音技术
技术沙龙|3D-Speaker说话人识别多模型解析
941 0
Ubuntu18.04设置系统默认音频设备:使用pavucontrol命令
2841 0
Ubuntu18.04设置系统默认音频设备:使用pavucontrol命令
|
8月前
|
机器学习/深度学习 编解码 JSON
FantasyWorld 正式开源!一次前向传播,同时生成视频与 3D 几何——视频世界模型的新范
高德地图发布「FantasyWorld」——新一代几何一致世界模型,单次前向即可生成高质量视频与3D场景(深度图、点云、相机轨迹),无需后处理或逐场景优化。ICLR 2026录用,WorldScore榜首,已开源代码与模型。
1593 6
|
4月前
|
人工智能 运维 API
知识库分层编排:从 RAG 到 Agent-native Knowledge Context Layer
本文剖析知识库根本困境,系统对比Naive RAG、LLM Wiki、Graphify、GraphRAG四大范式,提出“金字塔”结构化知识工程新范式:按稳定性与抽象度分五层(原则→架构→规范→实现→经验),结合角色感知与知识图谱关联,实现层次定位、跨层导航与增量同步,显著提升检索精度与知识保鲜能力。
1255 0
|
人工智能 监控 算法
3D-Speaker:阿里通义开源的多模态说话人识别项目,支持说话人识别、语种识别、多模态识别、说话人重叠检测和日志记录
3D-Speaker是阿里巴巴通义实验室推出的多模态说话人识别开源项目,结合声学、语义和视觉信息,提供高精度的说话人识别和语种识别功能。项目包含工业级模型、训练和推理代码,以及大规模多设备、多距离、多方言的数据集,适用于多种应用场景。
5522 18
3D-Speaker:阿里通义开源的多模态说话人识别项目,支持说话人识别、语种识别、多模态识别、说话人重叠检测和日志记录
|
机器学习/深度学习 存储 人工智能
ONNX 与安全:保护模型免受攻击
【8月更文第27天】随着人工智能和机器学习模型的应用越来越广泛,模型的安全性也成为了人们关注的重点。Open Neural Network Exchange (ONNX) 作为一种开放的标准格式,不仅可以促进不同框架之间的模型共享,还面临着如何保护模型不被恶意攻击的风险。本文将探讨 ONNX 在模型安全方面的考虑,以及如何利用 ONNX 和其他技术来保护模型免受攻击。
1504 4
|
机器学习/深度学习 自然语言处理 语音技术
FunAudioLLM 技术测评报告
FunAudioLLM 技术测评报告
|
机器学习/深度学习 人工智能 达摩院
INTERSPEECH2023|达摩院语音实验室入选论文全况速览
2797 1

热门文章

最新文章