Sora超逼真视频引恐慌!Nature刊文警示AI视频模型,或在2024年颠覆科学和社会

简介: 【4月更文挑战第27天】OpenAI公司的新型AI工具Sora能根据文字提示生成超逼真视频,引发关注。尽管已有类似产品,如Runway的Gen-2和谷歌的Lumiere,Sora以其高质量生成效果领先。该技术的进步可能导致2024年全球政治格局的颠覆,同时带来虚假信息的挑战。OpenAI已组建“红队”评估风险,但虚假视频识别仍是难题。尽管有水印解决方案,其有效性尚不确定。Sora在教育、医疗和科研等领域有潜力,但也对创意产业构成威胁。

随着人工智能技术的飞速发展,一种新型的AI工具——Sora,由OpenAI公司开发,其能够根据简短的文字提示生成超逼真的视频内容,引起了广泛关注。这种技术的诞生,不仅让科研人员感到兴奋,同时也引发了对未来可能带来的社会变革和挑战的深思。

Sora并非市场上唯一的文本到视频的AI工具。在此之前,已有其他公司推出了类似的产品,如纽约的Runway公司去年发布的Gen-2,以及谷歌主导的Lumiere项目。然而,Sora以其出色的生成质量和对细节的精准把握,迅速在同类产品中脱颖而出。De Montfort大学数字文化专家Tracy Harwood表示,她对这种AI技术的发展速度感到震惊。去年,人们还在嘲笑AI生成的美国演员威尔·史密斯吃意大利面的视频中的不自然之处,而今,一些研究人员开始担忧这项技术可能在2024年颠覆全球政治格局。

OpenAI公司在2月15日首次展示了Sora,并宣布将其提供给“红队”进行风险评估。所谓“红队”,是指通过模拟攻击或利用技术,来评估其在现实世界中对抗恶意行为,如制造虚假信息和仇恨内容的能力。这一举措表明,OpenAI公司对于Sora可能带来的负面影响持有审慎态度。

然而,这项技术的发展也带来了一系列挑战。Harwood指出,虚假信息是这些文本到视频技术面临的主要问题之一。随着逼真视频内容的大量涌现,人们将很难分辨信息的真伪,这无疑给社会带来了巨大的挑战。特别是在即将到来的选举中,如11月的美国总统选举和英国的大选,假视频和假音频的泛滥可能会对选举结果产生重大影响。

为了应对这一问题,有人提出了在AI生成的视频中加入水印的解决方案,无论是在视频上加上可见的标记,还是在其元数据中嵌入人工签名。然而,这种方法的有效性仍有待验证。目前,水印可以被移除,而且依赖观众主动研究视频真实性的做法并不现实。

尽管存在挑战,但Sora等AI视频工具的潜在好处也不容忽视。Harwood认为,这项技术可以用来以更易于理解的形式呈现复杂的文本,如学术论文,帮助普通人更好地理解学术成果。此外,它还可以在医疗领域发挥作用,例如通过AI与患者交流,代替人类医生进行日常咨询。

AI视频工具还可以帮助研究人员处理大量数据集,如欧洲粒子物理实验室CERN等大型科学项目产生的数据。这些工具可以筛选出代码,完成研究中的琐碎任务,甚至进行更为复杂的工作,如数据分析和预测。

然而,AI视频技术的发展也给创意产业带来了挑战。例如,美国演员汤姆·汉克斯曾提出,AI技术可能使他在去世后仍能继续出演电影。这无疑给那些有抱负的年轻演员带来了压力,他们可能会担心自己的未来职业道路。

参考资料:https://www.nature.com/articles/d41586-024-00661-0

目录
相关文章
|
人工智能 API 数据安全/隐私保护
近期非常风靡非常逼真的AI视频内容由sora生成的视频是怎么回事?-优雅草卓伊凡
1989 12
近期非常风靡非常逼真的AI视频内容由sora生成的视频是怎么回事?-优雅草卓伊凡
|
人工智能 自然语言处理 数据可视化
AI视频培训|格律诗AI 视频创作与自媒体传播——某诗词学会
近日,TsingtaoAI派驻专家团队为某诗词学会学员交付《格律诗AI 视频创作与自媒体传播》培训。本课程精准切中行业痛点——传统诗词创作与现代传播方式的断层。课程摒弃泛泛而谈,直击实操:首日聚焦"工具认知+创作逻辑",系统梳理即梦、可灵等国产AI工具在格律诗意象可视化中的差异化应用,如将"月光在指尖碎裂"转化为动态场景;次日深入"语音表达+自媒体运营",传授用魔音工坊生成情感化配音、坤行数字人打造诗人形象的秘技,更结合抖音、小红书平台特性,解析"前5秒高光片段设计"等流量密码。
1087 3
|
机器学习/深度学习 人工智能 自然语言处理
AI Compass前沿速览:Qwen3-Max、Mixboard、Qwen3-VL、Audio2Face、Vidu Q2 AI视频生成模型、Qwen3-LiveTranslate-全模态同传大模型
1530 13
AI Compass前沿速览:Qwen3-Max、Mixboard、Qwen3-VL、Audio2Face、Vidu Q2 AI视频生成模型、Qwen3-LiveTranslate-全模态同传大模型
|
人工智能 自然语言处理 机器人
AI Compass前沿速览:Jetson Thor英伟达AI计算、Gemini 2.5 Flash Image、Youtu腾讯智能体框架、Wan2.2-S2V多模态视频生成、SpatialGen 3D场景生成模型
|
机器学习/深度学习 人工智能 编解码
AI Compass前沿速览:PixVerse V5、gpt-realtime、Grok Code Fast、HunyuanVideo、OmniHuman-1.5、字节WaverAI视频、MiniCPM 4.5等
|
人工智能 编解码 自然语言处理
重磅更新!ModelScope FlowBench 支持视频生成 + 图像编辑,AI创作全面升级!
很高兴地向大家宣布,ModelScope FlowBench 客户端迎来重大功能升级! 本次更新不仅正式支持了视频节点功能,还新增了图像编辑与IC-Light智能打光等实用功能,同时对多个图像处理节点进行了深度优化和扩展。现在,您只需在 FlowBench 中轻松串联节点,即可使用 Wan2.1/Wan2.2、Qwen-Image-Edit、FLUX Kontext、IC-Light等强大模型,轻松实现创意内容的生成与编辑。 无论你是内容创作者、视觉设计师,还是AI技术爱好者,这次更新都将为你打开全新的创作边界。
1426 14
|
存储 人工智能 达摩院
|
人工智能 移动开发 开发工具
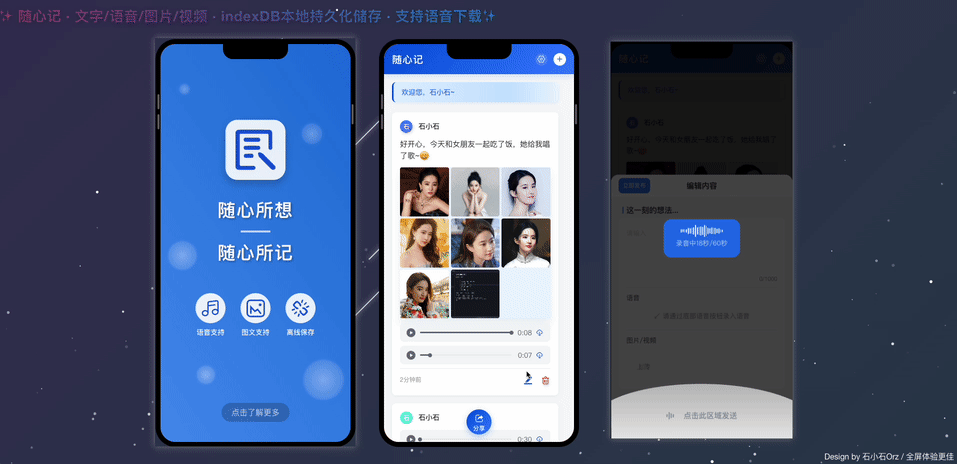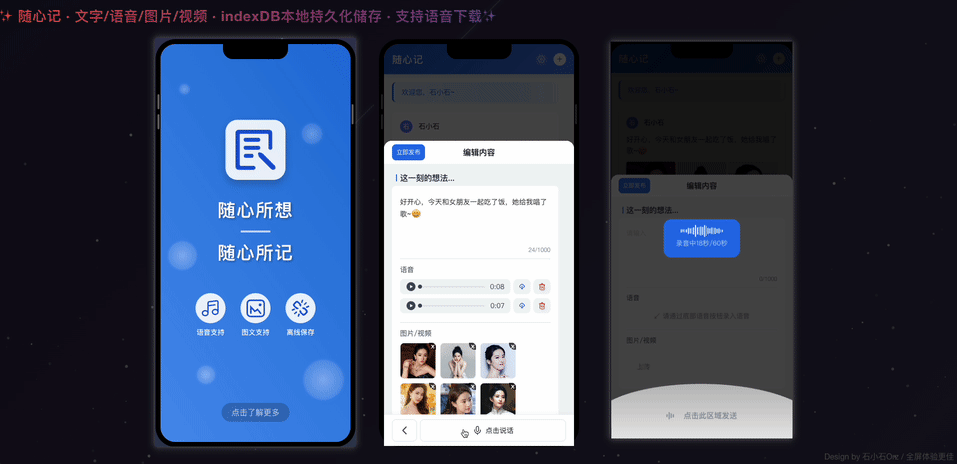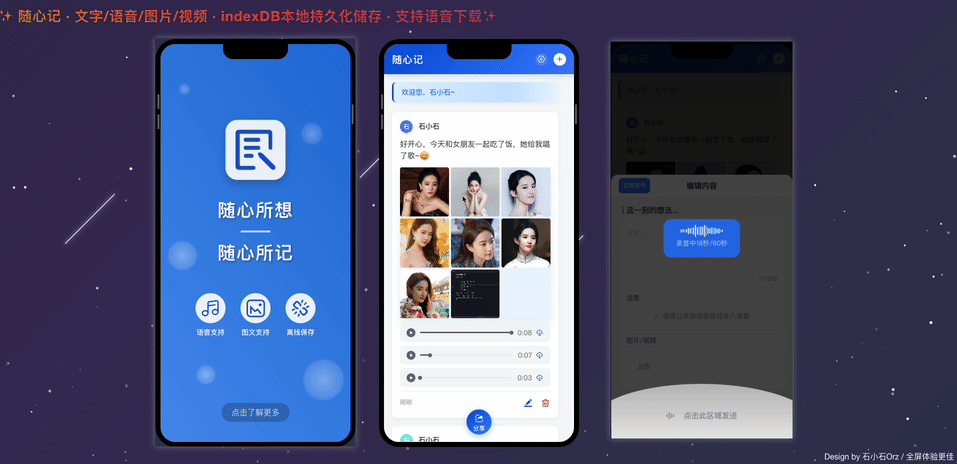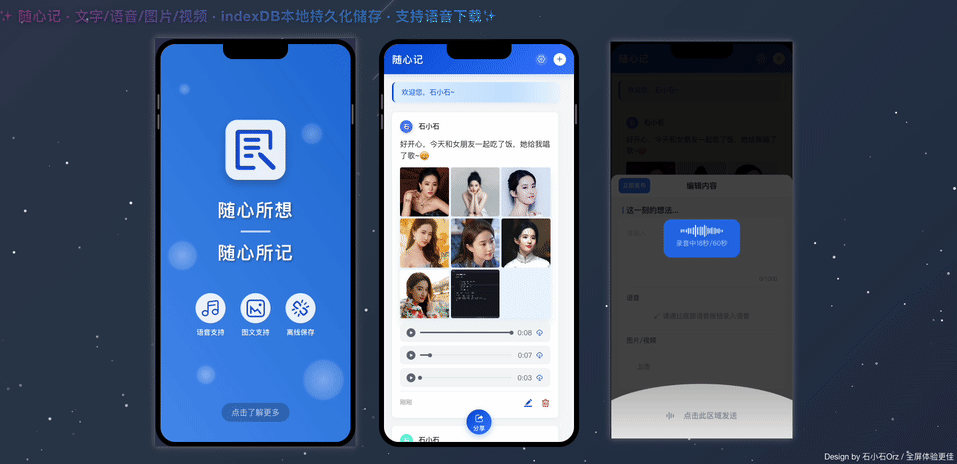
H5录音、图文视频IndexDB储存最佳实践:用AI生成语音备忘录
随心记是一个由 AI 生成的网页备忘录,它支持语音录入(可下载)、图文视频记录。最重要的是,它支持离线使用,所有数据都储存在浏览器中,不依赖后端,刷新页面数据也不会丢失!
649 0
H5录音、图文视频IndexDB储存最佳实践:用AI生成语音备忘录
|
存储 人工智能 自然语言处理
让你拥有一个AI大脑,这个32.1k Github项目是你不错的选择,支持PDF、Markdown、代码、视频成为你的知识内容
Quivr 是开源全栈 RAG 平台,助你打造“第二大脑”,支持多文档类型与多种 LLM,实现智能搜索与聊天。具备语义检索、本地部署、隐私保护等功能,适用于个人知识管理与企业知识库,界面简洁易用,是高效智能问答的理想选择。
879 0
|
机器学习/深度学习 人工智能 自然语言处理
AI 加速科学发现丨Al For Science 专场直播
AI 科学家时代正加速到来,但科研智能体真的做好准备了吗?真实科研场景中,多模态智能体能否在推理、规划与执行等关键能力上达到人类科研人员的水平?我们又该如何准确评估它们的科学认知能力和数据分析表现?
429 0