
4 检测器的选择
公式和标准的Two-Stage检测器的关键区别在于在检测得分中使用了类不可知检测。在概率形式中,分类分数乘以类别不可知检测分数。这需要一个强大的第一阶段检测器,不仅最大限度地召回建议框,而且还可以为每个建议框预测一个可靠的目标概率。在实验中,作者使用比较好的One-Stage检测器来估计这个对数似然概率。
概率Two-Stage检测器的核心部件是Stronge First Stage。第1阶段需要预测一个准确的目标可能性,以告知整体检测分数,而不是最大化目标覆盖范围。在流行的One-Stage检测器的基础上实验了4种不同的设计。对于每一个检测器,作者强调了将它们从One-Stage检测器转换为概率Two-Stage检测器中的第1阶段所需的检测器。
4.1 RetinaNet
RetinaNet与传统的Two-Stage检测器的RPN非常相似,但有三个关键区别:
- 较重的Head设计(4层vs1层 in RPN);
- 更严格的正负锚定定义;
- Focal Loss。
这些组件中的每一个都提高了RetinaNet产生校准的One-Stage检测可能性的能力。
作者在第一阶段的设计中使用了所有这些。默认情况下,RetinaNet使用两个单独的头部来进行边界框回归和分类。在第一阶段设计中发现两个任务有一个共享的Head就足够了,因为对象或非对象分类更容易并且需要更少的网络容量。这也加快了推理速度。
4.2 CenterNet
CenterNet将对象作为位于其中心的关键点,然后回归到方框参数。原始的CenterNet在单个尺度上运行,而传统的Two-Stage检测器使用特征金字塔(FPN)。而本文使用FPN将CenterNet升级到多尺度。
具体来说,使用Retinaanet Style的ResNet-FPN作为主干,从stride=8到128输出特征映射。将四层分类分支和回归分支应用于FPN的所有层次,以产生检测热图和边界框回归图。
在训练过程中,根据对象大小,在固定的分配范围内,将ground-truth center标注分配给特定的FPN级别。受到GFL的启发,在3×3中心附近添加了一些位置,这些位置已经产生了高质量的边界框作为正数。使用到边界的距离作为边界框表示,并使用gIoU损失作为边界框回归损失函数。作者将改进后的CenterNet称为CenterNet*。
4.3 ATSS
ATSS用自适应的IoU阈值对One-Stage检测器的分类概率进行建模,并使用centerness来校准分数。在一个概率的Two-Stage Baseline中使用的是ATSS,并乘以中心和前景分类得分为每个proposal。再次合并分类和回归Head,以稍微加速。
4.4 GFL
GFL使用回归质量来指导目标似然训练。在概率Two-Stage Baseline中删除基于积分的回归,仅使用基于距离的回归来保持一致性,并再次合并2个Head。
5 实验
5.1 基础Two-Stage模型实验
One-Stage架构推断出)。对于每一个将它们与第二阶段的推断相结合。作者实验了2个基本的第二阶段设计:FasterRCNN和CascadeRCNN。
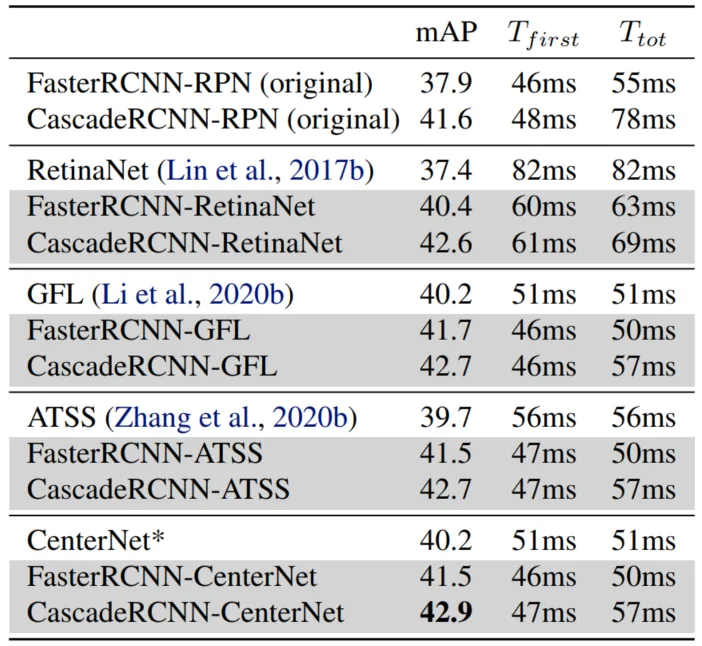
每一个概率Two-Stage FasterRCNN模型在mAP上都比它的一级前身提高了1-2个百分点,在mAP上比原来的两阶段FasterRCNN提高了3个百分点。更有趣的是,由于更精简的头部设计,每个Two-Stage的概率FasterRCNN都比它的一级前身更快。
由于更有效的FPN和概率检测器使用更少的proposal,许多概率Two-Stage FasterRCNN模型比原始的两阶段FasterRCNN更快。
在CascadeRCNN模型中观察到类似的趋势。在这些概率Two-Stage模型中,CascadeRCNN-CenterNet设计表现最好。
5.2 Real-Time模型实验
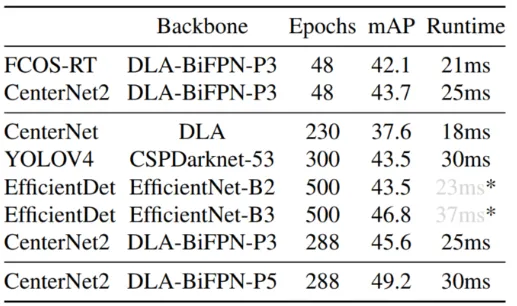
在相同的backbone和训练下,CenterNet2比realtime-FCOS性能好1.6个mAP,并且只慢4毫秒。使用相同的基于FCOS的Backbone和更长的训练,它在原来的CenterNet上改进了7.7mAP,并轻松地超越了流行的YOLOv4和效率更高的检测器,在40fps下有45.6mAP。使用稍微不同的FPN结构,并结合Self-Training,CenterNet2以33帧每秒的速度获得49.2mAP。虽然现有的大多数实时检测都是One-Stage,但在这里,作者展示了Two-Stage检测其也可以像One-Stage一样快,同时提供更高的精度。
5.3 SOTA模型对比
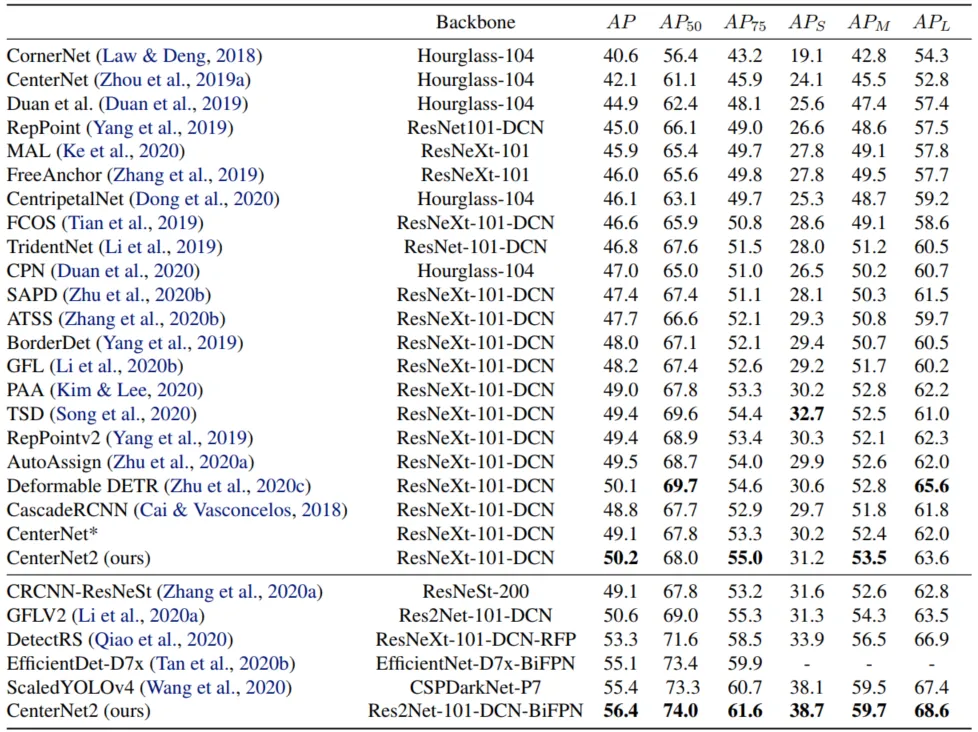
作者这里使用了一个更强的Backbone Res2Net-BiFPN,一个更大的输入分辨率(训练用:1560x1560,测试用:1280x1280测试)和heavy crop augmentation(0.1-2),和一个长的时间Self-Training来标记图像。最终模型单模型达到56.4 mAP,优于所有发表的所有模型。
6 参考
[1].Probabilistic two-stage detection
[2].https://github.com/xingyizhou/CenterNet2
7 推荐阅读
CVPR2021全新Backbone | ReXNet在CV全任务以超低FLOPs达到SOTA水平(文末下载论文和源码)
你的YOLO V4该换了 | YOLO V4原班人马改进Scaled YOLO V4,已开源(附论文+源码)

