

几分钟创建一个带有业务数据的AI智能客服
本文介绍如何利用阿里云百炼和AppFlow快速创建企业微信客服或网页客服。首先,通过上传企业知识文件和创建大模型问答应用,获取AI推理API服务;接着,在AppFlow控制台新建AI助手并导入配置好的模型,设置对话背景、欢迎语及预设问题等;最后,选择Web集成或企业微信集成方式部署客服系统。整个过程简单易操作,无需技术背景,适合非技术人员使用。文章还提到支持自定义域名绑定以及更多渠道发布选项,助力企业高效搭建专属智能客服。
6个Java 工具,轻松分析定位 JVM 问题 !
本文介绍了如何使用 JDK 自带工具查看和分析 JVM 的运行情况。通过编写一段测试代码(启动 10 个死循环线程,分配大量内存),结合常用工具如 `jps`、`jinfo`、`jstat`、`jstack`、`jvisualvm` 和 `jcmd` 等,详细展示了 JVM 参数配置、内存使用、线程状态及 GC 情况的监控方法。同时指出了一些常见问题,例如参数设置错误导致的内存异常,并通过实例说明了如何排查和解决。最后附上了官方文档链接,方便进一步学习。

MCP:让大语言模型不只是聊天,更能"动手做事"的开放协议
MCP(Model Context Protocol,模型上下文协议)是一种开放协议,旨在标准化应用程序向大语言模型提供上下文的方式。通过 MCP,大模型不仅能聊天,还能执行如查数据库、写代码等任务。相比 Function Calling,MCP 解耦了工具调用,提升灵活性和复用性,实现“一次开发,多处调用”。其架构包括 MCP Hosts、Clients、Servers,以及本地数据源和远程服务,支持安全访问多种资源。相关资源可在 GitHub 和 mcp.so 获取。
在阿里云服务器上如何搭建网站,网址怎么建站图文教程详解案例及步骤.
做好一个网站不仅需要我们对站点装修及内容发布,也需要我们学会对网站运营,如进行站长推送,将我们内容快速推送到各大搜索平台,有效的让用户能搜索到我们内容,或者需要在谷歌推广就必须对网站添加SSL证书,这样搜索域名的时候搜索框不会出现<不安全>字符在域名前面,以及运行网站要懂运维,出现BUG时要去及时解决查找原因.自始至终自身要不断学习网络相关知识,遇到问题方能迎刃而解. 本文结束,如还有不懂的同学可联系作者,倾力而为,祝您成功!

快速使用 DeepSeek-R1 满血版
DeepSeek是一款基于Transformer架构的先进大语言模型,以其强大的自然语言处理能力和高效的推理速度著称。近年来,DeepSeek不断迭代,从DeepSeek-V2到参数达6710亿的DeepSeek-V3,再到性能比肩GPT-4的DeepSeek-R1,每次都带来重大技术突破。其开源策略降低了AI应用门槛,推动了AI普惠化。通过阿里云百炼调用满血版API,用户可以快速部署DeepSeek,享受高效、低成本的云端服务,最快10分钟完成部署,且提供免费token,极大简化了开发流程。
浏览器的缓存方式几种
浏览器缓存方式主要包括:1. **强制缓存**,通过 `Expires` 或 `Cache-Control` 控制,缓存有效期内不发起请求;2. **协商缓存**,使用 `ETag` 和 `Last-Modified` 判断资源是否更新;3. **Service Worker 缓存**,适用于 PWA 应用,拦截并返回缓存;4. **浏览器存储**,如 LocalStorage、SessionStorage 和 IndexedDB,用于持久化或会话级数据存储;5. **Push Cache**,仅限 HTTP/2,服务器主动推送资源。选择合适的缓存策略可优化性能和用户体验。
从客服场景谈:大模型如何接入业务系统
本文探讨了大模型在AI客服中的应用。大模型虽具有强大的知识生成能力,但在处理具体业务如订单咨询、物流跟踪等问题时,需结合数据库查询、API调用等手段。文章提出用Function Call连接大模型与业务系统,允许大模型调用函数获取私域知识。通过具体示例展示了如何设计系统提示词、实现多轮对话、定义Function Call函数,并利用RAG技术检索文档内容。最后,展示了该方案在订单查询和产品咨询中的实际效果。

【评测】玩转阿里云《10 分钟构建 AI 客服并应用到网站、钉钉或微信中》
本文介绍了使用阿里云百炼大模型在10分钟内构建AI客服,并应用于网站、钉钉或微信中的体验。作者“JavaDog程序狗”详细描述了从搭建到完成的全过程,包括快速上手、遇到的问题及解决方法、定制化需求以及云产品的整体体验。文档清晰易懂,集成过程顺畅,客服支持响应迅速,定制功能满足特定业务需求,总体体验极佳,适合开发者尝试。
【算法精讲系列】通义模型Prompt调优的实用技巧与经验分享
本文详细阐述了Prompt的设计要素,包括引导语、上下文信息等,还介绍了多种Prompt编写策略,如复杂规则拆分、关键信息冗余、使用分隔符等,旨在提高模型输出的质量和准确性。通过不断尝试、调整和优化,可逐步实现更优的Prompt设计。
AI战略丨阿里云百炼再升级:模型、工具、AI能力,快速接入、应有尽有
阿里云百炼持续加码模型服务,基于丰富的底层计算能力与通义系列模型的最佳实践,构建训练评测、标注、部署全生命周期模型工具,帮助企业、开发者在云上一站式调用、优化大模型,成为大模型时代的商业化基础设施。
阿里云百炼产品月刊【2025年3月】
2025年3月的阿⾥云百炼平台月刊突出展示了其在AI模型和服务上的显著进展。本期亮点包括推出了多个先进的多模态模型,如qwen2.5-omni-7b和视觉推理模型qvq-max系列,大幅提升了文本、图像、语音和视频的处理能力,并降低了计算成本。此外,平台引入了精准的语音识别和翻译模型gummy-realtime-v1及gummy-chat-v1,支持多语言实时交互。为了促进应用开发,阿里云百炼平台还发布了开源推理模型qwq-32b,以及一系列优化的智能体应用模型,增强了自动化和交互性。最后,通过新增周边查询插件和基于MCP的析⾔服务,进一步扩展了平台的功能和服务范围。
在阿里云百炼平台配置您的自定义阿里云MCP Server
alibaba-cloud-ops-mcp-server 是阿里云资源管理的专用工具,集成阿里云 Open API 和系统运维管理(OOS),支持 ECS、RDS 等资源的全生命周期管理。通过百炼平台部署,用户可结合 AI 助手实现自然语言交互式运维,简化复杂任务操作。部署方式简单,包括创建 MCP 服务、配置 JSON 文件并选择极速模式,最后在百炼平台新增智能体应用,完成技能绑定即可使用专属智能运维工具。
6 个漂移模式:AI 生成界面的语义断层证据库
本文提出AI界面语义漂移的6类通用模式(如错误状态未分级、过程阶段不显化等),基于8款AI产品实证归纳,揭示组件级语义令牌缺失(如`error_severity`)是跨产品漂移根源,为构建可约束的语义契约提供关键输入。
企业多工具环境下的 Agent 技能统一分发:百炼 CLI bl skill 的存储模型与治理价值
本文基于阿里云百炼CLI(v1.22.0)实测,剖析其`bl skill`命令组如何通过“单实体+符号链接+带sha256指纹的锁文件”模型,解决多AI工具团队中技能资产的版本不一致、回收困难、来源不可验三大治理痛点,实现免密钥、可审计、可回收的统一分发与管理。(239字)
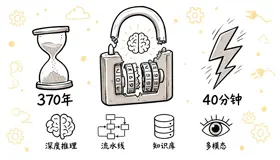
AI推理能力的工程化落地:从Fable破解370年密码看百炼深度推理+Pipeline+RAG三层架构
9月13日,Claude Fable 5.1仅用40分钟破解370年未解古密码,引爆AI推理热议。百炼CLI(bl)由此展现三层工程化能力:深度推理(`--enable-thinking`)、Pipeline编排(YAML多步流水线)、知识RAG增强,标志AI推理迈入可复用、可审计、可集成的落地新阶段。(239字)
Java 设计模式全景拆解:从单例工厂到策略责任链的三大类型实战指南
本文穿透设计模式本质,以单例、工厂、装饰器、代理、策略、责任链六大高频模式为线索,结合双检锁单例多线程崩溃的真实排错案例,剖析根因(指令重排序)与修复闭环。强调模式应由真实痛点驱动,而非炫技背诵。
阿里云Token Plan个人版和团队版怎么选?各自能力与区别及选择指南参考
阿里云Token Plan以统一Credits计量体系整合全品类大模型与多模态能力,拆分出个人版与团队版两大产品线。个人版设Lite/Standard/Pro三档,适配独立开发者轻量化需求;团队版以坐席为单位分三档,新增企业级管理、数据安全与多租户隔离能力。本文将从产品细节、计费机制、权益差异、选购逻辑等维度,对阿里云Token Plan个人版与团队版进行全面拆解,帮助不同需求的用户理清两者的核心区别,找到最适合自己的订阅方案,避免不必要的成本浪费与权益错配。
一个 AI 助手,如何在同一对话里管理维护多家门店?
本文探讨AI如何在同一对话中协同操作多门店(如A、B店):用户预先选定授权范围,AI据此自动匹配对应门店执行查询与修改(如仅改A店备注),避免反复切换。强调权限隔离、动作明确、结果分店呈现与全程可审计。
AI 搜索引擎优化内容筛选:什么类型素材更容易被大模型提取采信
本文探讨AI搜索引擎优化(AISEO)新范式:区别于传统SEO,AISEO需适配大模型信息抽取机制,强调标准化事实、结构化排版、场景化问答、清晰实体关系、多源一致及低噪声内容,助力企业内容高效进入AI答案参考池。
从零开始搭建知识库 · EP06 · 范式篇(一)知识编译 vs 运行时检索
本文为「从零搭建知识库」第六期,对比检索式与编译式范式:前者实时切片检索,后者让模型通读全库生成结构化知识页。实测表明,编译范式能主动发现跨文档冲突、提升复杂问答一致性,并借助隐式前缀缓存显著降本(高频场景约6问回本),但牺牲元信息、不适用权限隔离与高频更新场景。(239字)
使用 UseIO 写代码,如何让技能和大模型能力互补
本文揭示AI前端开发中的两大顽疾:知识过时(如Tailwind v4无配置文件、React 19无需手动useMemo)与事实幻觉(臆造API、张冠李戴)。指出模型缺乏时效感知与“我不知道”机制,仅靠对话纠正效率低下。提出系统性解法——用可滚动更新的《frontend-guidelines》技能文件校准事实:含版本基线、禁用清单、查证红线、设计反AI味约束及验证闭环,实现“模型管能力,文件管事实”的协同范式。
挖掘 AI 搜索提问长尾词,AI 搜索引擎优化如何抓住用户真实检索意图
本文详解AI搜索时代长尾词挖掘新范式:摒弃传统SEO短词思路,以用户真实提问意图为核心,通过多渠道采集、语义蒸馏、分层聚类、价值筛选、衍生拓展及动态校验六步法,构建适配大模型语义检索的高质量提问词库,提升内容被AI采信与转化效果。

二级C语言题解:十进制转其他进制、非素数求和、重复数统计
本文详解三类经典编程题:十进制转任意进制(填空)、非素数求和(修改)与重复数字统计(设计),含完整代码、逐空分析及易错点解析,助你夯实C语言基础。
百炼知识库数据准备实测:五类脏数据在检索层的翻车形态(版本冲突 / 口径 / Excel / 切分 / 表格)
本篇为“从零搭建知识库”系列第三期,聚焦**文档入库前的关键数据准备**:厘清百炼能力栈中知识库导入、文件上传与检索的职责边界;实测三类高频翻车场景(版本混喂、Excel格式失真、长文切分失当),并给出可落地的5项入库前检查清单,助力构建高质量、可维护的知识库底座。(239字)

二级C语言题解:单链表的排序、求单链表的最大值、二维数组按行存入一维数组
本文详解三道经典编程题:①带头结点单链表从小到大排序(填空);②求单链表(不含头结点)最大值(改错);③将M×N二维数组按行优先存入一维数组(设计)。含完整代码、逐行分析与图解,助力夯实数据结构基础。
GEO 生成式引擎优化和传统 SEO 核心区别到底是什么?
本文深度辨析GEO(生成式引擎优化)与传统SEO的本质差异,从流量目标、评判逻辑、用户链路、资产沉淀、实践误区五大维度揭示:二者并非简单迭代,而是适配不同信息分发体系的两套范式——SEO争链接排名,GEO争AI答案引用;SEO重机械指标,GEO重语义可信度。助力运营者建立理性认知,实现双线协同布局。(239字)
GEO 生成式引擎优化通俗解读:重新理解 AI 搜索引擎优化的底层逻辑
本文通俗解析GEO(生成式引擎优化)——面向AI大模型的新型内容优化体系。对比传统SEO,GEO聚焦内容能否被大模型“看见、信任、引用”,强调事实准确、结构清晰、多源可信。厘清误区,拆解检索、甄别、生成三阶段逻辑,助力从业者构建AI时代的内容竞争力。(239字)
深度拆解 Vera1.1 多分镜连续生成:角色漂移到底卡在哪个技术环节
本文针对国风漫剧工业化中「无限画布多分镜连续生成」的角色漂移问题,通过32组对照测试,从参数、架构、流程三维度深度剖析Vera1.1的漂移机理,量化分镜数量与一致性衰减关系,并提供可落地的调参方案(如CFG 6.5–7.5、时序窗口设为4帧等)及标准化工作流,显著提升9分镜角色一致性得分28.8%。
实体商家自学笔记|规避关键词堆砌:GEO语义词布局正确落地实操(适配通义千问轻量化AI曝光)
深圳实体店主亲测:告别关键词堆砌!本文揭秘通义千问GEO优化本质——重语义、轻密度。详解4大堆词红线、语义自然布词法及零门槛实操流程,助门店低成本实现AI稳定曝光。(239字)
技术拆解:Vera1.1 改进时序注意力如何缓解 AI 视频人物漂移问题
AI视频生成中,“人物漂移”是长期痛点:五官走形、服饰突变、多人串脸等,源于扩散模型缺乏身份记忆。星宇智算Vera 1.1首创“滑动时序注意力+帧特征缓存+运动约束”三层架构,结合分层特征锚定,将人物漂移率从41.7%降至4.9%,兼顾稳定性与动态表现。
数字人视频运镜总翻车?Vera 1.1 复杂镜头运动技术难点全拆解
Vera 1.1 是星宇智算推出的图生视频模块,专攻复杂镜头运动难题。通过3D几何约束、运动解耦与分层时空注意力三大技术,将复合运镜合格率从62%提升至89%,支持最高6自由度精准控制,显著改善主体漂移、畸变、断裂等六大失效问题,广泛适配数字人、宣传片与虚拟漫游场景。
已有商城或 CRM,怎么加一个能操作后台的 AI 助手?先跑通“一读一写”
本文提出“一读一写”落地法:面向已有商城、CRM等系统,不重构、不泛化,聚焦一条窄而真实的业务链路——如“查订单+建售后工单”,通过受控API调用、可信身份传递与业务系统终审,实现AI安全介入真实操作。重实践、轻架构,首步验证最小可行闭环。
Java日期工具类:日期转化、今天日期、昨天日期、明天日期、指定日期
程序员常被日期转换困扰?本文分享自研Java日期工具类DateTools,支持今天/明天/昨天获取、日期与字符串双向转换、指定日期前后天计算等功能,代码简洁实用,助你提升开发效率!
阿里云百炼Coding Plan:固定月费解锁AI编程全能力,按次计费告别Token焦虑
在软件开发与AI编程深度融合的当下,开发者面临两大核心痛点:一是传统按Token计费模式下,复杂代码任务、多轮调试与智能体工作流会产生高额、不可控的费用,抑制了AI辅助开发的充分使用;二是主流AI编程工具分散,不同工具需分别配置不同平台的API Key,切换繁琐、效率低下。阿里云百炼Coding Plan正是为解决这些痛点而生,它以**固定月费+按请求次数计费**为核心,整合顶级代码模型,兼容主流AI编程工具,专为交互式代码开发场景设计,让开发者告别Token消耗焦虑,专注于代码创作本身,成为个人与团队AI编程的首选订阅方案。

从对话到管道:基于百炼 CLI 构建文本理解工作流的四个实践场景
本文介绍百炼CLI(`bl`)如何将高频但低效的文本理解任务(分类、抽取、审读、摘要)工程化:通过规则外置、批量输入、结构化输出,结合Qwen多模型梯度与Qwen-VL多模态能力,零代码构建可复用工作流。四类实战场景覆盖评论打标、合同审读、AI特征评估与视频结构化,兼顾效率、成本与落地性。(239字)
Dify 接入业务系统:HTTP 节点能调接口之后,还缺哪些生产边界?
Dify能快速连接模型与业务API,但“调通”不等于“可生产”。本文聚焦AI Agent执行退款、停号等真实写操作时的六大生产边界:能力白名单、可信主体隔离、审批参数绑定、幂等重试、长任务状态协议、跨系统责任追溯,并强调最终授权必须由业务系统保留。
普通用户可以在 OpenAgenet(OAN)上做什么,如何加入这个生态
本文面向普通用户介绍 OpenAgenet(OAN)的使用价值与参与方式。OAN 不是要求用户运行复杂节点,而是提供智能体资源的可信注册、分发与发现基础设施。用户可以在 OAN 上发布 Agent Service、Skill、MCP Server、Tool/API 等资源,也可以通过 Discovery 查询并验证他人发布的资源。文章说明了资源发布流程,包括准备基本信息、创建 did:oan 身份、选择授权域、提交 Registrar、经 Root 验证后进入 Discovery;也介绍了 SDK 和 Community Skill 如何帮助开发者或非技术用户完成注册、发现和结果解释。普通用户
【新版】阿里云 百炼 Token Plan 团队版 功能介绍及配置价格表
阿里云百炼Token Plan团队版是专为企业与团队打造的AI大模型订阅服务,以Credits为统一计量单位,整合通义千问全系列及第三方主流大模型,兼容主流AI编程与智能体工具,提供完善的团队管理、用量监控、数据安全保障能力,支持文本、图像、视频等多模态生成,适配团队日常办公、AI编程、智能体开发等多样化场景。团队版以“坐席”为最小订阅单位,提供多档位套餐与弹性补充方案,兼顾成本可控与使用灵活,助力企业高效、安全地规模化落地AI应用。
Coding工具搜索不够全?我做个 deuseek:一条命令补齐全网搜索
deuseek 是专为国产大模型(如GLM-5.2、Kimi3)Agent设计的CLI工具,填补其联网搜索短板。支持多源检索(HN、B站、微信公众号等)+ 全文抓取(Markdown结构化),含三层智能抓取引擎与DomainKB缓存,兼顾速度与反爬穿透能力,助力Agent真正自主查资料。
最新版阿里云百炼 Token Plan (AI 大模型订阅服务)功能介绍
阿里云百炼Token Plan是面向个人与团队推出的AI大模型订阅服务,以Credits作为统一计量单位,整合文本生成、图像生成、多模态处理等能力,兼容主流AI编程与智能体工具,提供个人版与团队版双版本,覆盖从个人开发到企业协作的全场景需求。该服务打破传统AI服务按模型单独付费的模式,实现“一份订阅、多模型通用、全工具兼容”,同时具备团队管理、用量分析、数据安全等企业级能力,成为开发者与企业接入AI能力的高效、低成本选择。
阿里云AI产品专属活动:从模型到应用最新优惠权益解析
阿里云推出全栈AI产品专属优惠活动,构建从底层大模型、上层AI原生应用到配套云资源的完整优惠体系。核心权益包括Qwen3.7-Max限时5折、HappyHorse1.1文生视频限时6折,百炼平台全模型通用抵扣包季低至4.5折,Qoder全系列工具夜间22点至次日8点调用低至2折,新用户注册QoderWork CN首月0元。同时推出覆盖90%上云场景的AI产品组合购,搭配OPC创新助力计划,为个人开发者、一人公司及中小微企业提供最高100万元Token按量达标返券补贴,全方位降低不同阶段用户接入AI生产力的门槛。
OpenClaw小白安装操作手册,TopClaw一键脚本及部署日志查看功能
本文为OpenClaw小白安装指南,推荐汉化优化版TopClaw:无需编程基础,双击安装、5分钟搞定;内置一键部署脚本,适配国内网络;提供中文日志排查功能,错误定位清晰。全本地运行,安全隐私有保障。
大模型算力成本管控与资源节流:GPU显存精细化管理、弹性扩缩容、资源回收.168
本文系统阐述大模型算力成本管控体系,涵盖GPU显存精细化管理、弹性扩缩容、闲置资源自动释放、量化推理降本及API额度节流五大核心策略,强调在保障服务质量前提下实现“降本不降质”,助力企业高效、稳定、低成本落地大模型应用。

设计师作为"语义翻译者" 当AI生成界面时怎么用规则锁住设计意图
阶段二聚焦设计师作为“语义翻译者”,通过 Schema-As-Code 将设计意图转化为 YAML 语义契约——定义语义令牌、域与不可变边界,实现对 AI 生成的上游约束,从源头锁住语义漂移,让规范可读、可编、可验。(239字)
OpenClaw中文专用版TopClaw下载,3分钟免费安装部署!
TopClaw是OpenClaw官方中文版,专为国内用户优化:一键安装、全中文界面、本地存储、零配置。支持Win10/11、Mac(Intel/M1/M2),3分钟极速部署,免注册、纯免费、无隐私风险,新手也能轻松上手。
内容产品接入中文 TTS 的一个轻量方案:音色、流式生成和字幕时间轴
这篇记录一个内容产品接入中文 TTS 的轻量方案:使用 OpenAI 风格接口,处理音色 ID、流式/非流式生成、方言/风格提示、额度和字幕时间轴等生产接入问题。
阿里云百炼工作流搭建中小学教材生成系统完整实操教程
依托阿里云百炼可视化工作流编排能力,无需深度代码开发,即可搭建标准化教学内容生成引擎。教师仅输入教材名称与适配学段,系统自动完成目录规划、章节正文撰写,产出贴合义务教育课程标准的完整教学材料,大幅压缩备课周期,缓解基层教师内容创作压力,助力区域教育资源均衡。整套方案采用低代码画布拖拽搭建,依托Qwen3.7-Max大模型承载内容生成能力,完整拆解节点设计、提示词配置、流程串联、测试发布全流程,同时拓展多类教育延伸应用场景