


开启云上 AIGC 动手实践,探索技术创意
面向 GenAI 时代,阿里云人工智能平台 PAI 平台自带海量开箱即用、实时更新的大模型最佳实践,提供高性能、高稳定的大模型工程化能力。本电子书精选 2024 云栖大会动手实践教程,覆盖大语言模型应用、多模态大模型微调训练、低代码 AIGC 创意设计等热门领域,为您带来 AIGC 开发全新体验。
小团队做AI问答内容整理:先拆清谁出题、谁把关、谁记录
本文为无专职营销人员的财税小团队提供AI时代内容协作方案:将“AI回答整理”拆解为“出题(客户问题)、把关(专业审核)、记录(AI提及观察)”三类动作,明确主责人+专业把关+负责人定期过问的最小分工机制,强调过程可控、责任到人、不承诺效果,务实起步。
企业 AI 开发团队核验实务:分清三类、核验三处与验收办法
马鞍山做企业 AI 开发的公司有哪些?本文直接回答:先分清三类再挑——外贸定制团队、工业大数据系、云厂商与通用软件,场景不同,找法也不同;再讲挑之前要核验的三处:做过你这一行没有、交付物写没写进合同、改动与数据归属清不清楚。
手把手教你:nvidia-smi 显示的 CUDA 版本到底是不是你装的那个|AI工程师踩坑实录·第1篇
真机踩坑实录第1篇:nvidia-smi右上角的CUDA Version只是驱动上限,不是已装版本。CPU版PyTorch调.cuda()报错,根源是PyPI默认源装的是+cpu轮子。解法很简单:换官方cu源CUDA轮子,不动驱动,实测GPU提速18.4倍。
AI 搜索优化(GEO)实操:AI 搜不到公司时,按这 8 步排查(附 robots.txt、JSON-LD、llms.txt 示例)
AI 搜不到你的公司,多数是因为 AI 能读到的公开网页里没有一段话把你说清楚,或者信息只在 App 里、要登录才能看。本文按「先测、再查、后补」给出 8 步排查清单和 robots.txt、结构化数据、llms.txt 示例,附一家民宿从 0 次到 5 次被 AI 提到的例子。
财税公司做GEO:固定专人跟进还是老板兼做,取决于工作是否已到交接点
财税公司开展GEO(生成式AI优化)时,人手安排宜分阶段:初期由老板聚焦经营判断(如服务边界、口径确认),同步沉淀流程;待内容工作常态化、出现协作混乱或记录分散等信号时,再设专人负责持续记录与协调。关键在厘清“判断”与“执行”,不盲目设岗,也不放松专业底线。
Hive 复杂数据类型实战:ARRAY、MAP、STRUCT 一个案例讲透
本文以「用户画像」为例,详解 Hive 四大复杂数据类型(ARRAY、MAP、STRUCT、UNIONTYPE)的声明、取值、加载与展开查询,涵盖 JSON/SerDe 加载、LATERAL VIEW explode 展平技巧,并给出生产避坑建议。
Hive LOAD DATA 详解:本地加载是复制,集群加载是移动
本文详解 Hive `LOAD DATA` 的核心机制与实战避坑:厘清 `LOCAL`(复制,留源)与集群路径(移动,删源)的本质区别,对比文件位置、速度及源文件去留;总结5大高频陷阱,并给出 `LOAD` 与 `INSERT` 的选型建议——文件就绪用 `LOAD`,需加工用 `INSERT`。
Lindorm时序冷热分层:降采样聚合提速长周期查询
本文介绍Lindorm时序引擎在产业园区能耗计量场景中落地冷热分层(热/温/冷三层存储)与多级降采样(5分钟/1小时/1天聚合)的实战方案,实现25个月趋势查询响应从4.2秒降至360毫秒,存储成本下降63%,兼顾明细可溯与分析高效。(239字)
智能体定制项目评估流水线实务:样本拆解、交付物字段与改动日志
智能体定制项目签约前核验什么?本文把评估写成一条流水线:拿真实询盘样本逐条拆解,把交付物清单逐项拿样本跑样,把改动流程与数据归属写进合同,附拆解记录与改动日志的字段示例;验收只看三段记录,不看距离与口头工期。
混合云时代的网络监控能力清单:发现、拓扑、告警与自动化
本文探讨混合云监控新范式:网络边界消失后,资产发现需事件驱动、跨云告警须端到端验证、自动化执行必经灰度过渡。强调六大能力重构、告警汇聚为首要里程碑,并提供落地五项检查清单与务实FAQ,聚焦工程可实施性。
Hive 基本数据类型:12 种类型的边界、转换与选型
本文详解Hive 12种基本数据类型:明确各类型边界、存储开销、静默丢数风险(如decimal超限写NULL)及生产选型规范。强调建表时类型设计的关键性——一旦上线,修改成本极高。
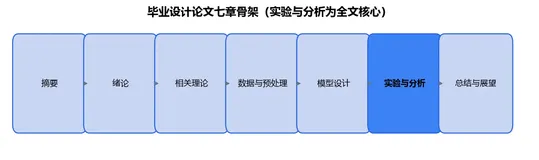
手把手教你:基于深度学习的滚动轴承故障诊断|第 9 篇 · 从代码到毕业设计:论文框架、实验表与答辩话术
收官篇教你怎么把前8篇成果写成毕业设计:论文按七章固定骨架填内容,核心说服力在实验对比表与三段分析话术;并给出答辩高频问题与话术,抓住"为什么选CWRU、残差为何有效、能否迁移"三个点即稳,全系列至此打通。
主客视角轴论——我们的主观实际上就是你的客观·同时同步
BSD Step384提出“主客视角轴论”:破除主客尊卑化这一最大割裂根因,确立主客本为同一现象的两个视角——客观即诸主观之和(Objective ≜ ΣSubjectᵢ),我们的主观即他人的客观;主客非等级关系,而是同时同步、可互换的视角轴(Perspective Axis),无先后、无高下。0元本体论大一统由此奠基。(239字)
代账公司设线上咨询岗前,先用观察期记录回答三个条件
本文探讨代账公司是否应设专职线上咨询岗,强调不盲从同行,而需基于真实咨询数据判断:咨询量是否稳定、问题是否重复、响应是否卡住成交。主张用观察期记录验证,明确岗位职责与边界,避免成本先行。
RAG 检索增强生成详解:从原理、架构到企业知识库落地全流程(2026 实战)
RAG(检索增强生成)让大模型答题前先 "翻资料",把知识和组织语言解耦。本文从 2020 年 Meta 与斯坦福提出的原论文讲起,拆解完整链路:文档切块、嵌入、向量库、Top-K 召回、重排、Prompt 拼装;给出 RAG 与微调、提示词工程的对比表和企业落地五步,并讲清它抑制幻觉 30%-50% 的原理与常见坑。
Flink on Kubernetes 部署模式:Application 与 Session 的两个分水岭
本文详解Flink on Kubernetes的Application与Session两种部署模式:前者为应用独占集群、资源隔离强、故障域独立;后者共享集群、资源复用高但存在作业干扰风险。二者核心差异在于集群生命周期归属及`main()`执行位置,直接影响运维成本与稳定性。
1688 商品详情API参数详解:适配跨境选品、ERP 同步场景
本文详解1688 B2B批发接口在跨境选品与ERP同步中的实战要点:涵盖MOQ、阶梯价、混批、代发、交期等核心字段解析,图片防盗链处理、价格分层核算、SKU规格拆解、属性映射及供应商信息应用,助力稳定对接海外平台。
Flink Native Kubernetes 架构:为什么 TaskManager 是一群裸 Pod
本文深度解析 Flink Native Kubernetes 模式(基于 Flink 2.3),揭示其核心特征:JobManager 由 Deployment 管理,TaskManager 则由 Flink 自身通过内置 Kubernetes 客户端动态创建裸 Pod,形成一条“不对称分界线”。文章厘清三层平面、对象拓扑、权限链与配置要点,助你精准排障、合理选型。
大模型入门(三):SFT、LoRA、RAG、MoE、Agent 这些缩写在解决什么
本期详解AI领域高频缩写,按用途分为四组:训练侧(SFT/RLHF/DPO/LoRA)、使用侧(RAG/Function Calling/Agent/MCP)、结构与成本(MoE/量化/KV cache)、评测指标(MMLU/GSM8K/HumanEval),并给出实用选型原则——先厘清需求本质(知识/形式/能力),再匹配工具。
海量设备日志的采集成本怎么压下来
本文分享日志降本增效实践:将500台设备日均4GB原始日志,通过**五步优化**(分级采样、结构化、zstd压缩+批量上报、去重、冷热分层),压至仅300MB/天,存储与流量成本降至1/12~1/15;同时排障效率反升——支持设备号、错误码、时间窗三维秒级查询,真正实现“三分钟定位问题”。
财税服务内容先做曝光还是先接咨询:用可观察的承接信号判断投入顺序
本文探讨财税服务公司GEO策略的优先级:资源有限时,应以“有效咨询”为先行观测指标,而非盲目追求品牌曝光。通过梳理真实客户问题、构建可复盘的90天内容承接框架,并回答四个关键自检问题,帮助中小机构识别“内容不足”与“承接断点”,务实验证服务能力。
手把手教你:基于深度学习的滚动轴承故障诊断|第 8 篇 · 可视化诊断系统:PyQt5 搭建带界面的工具
本文用PyQt5搭建带界面的轴承故障诊断工具:选数据文件、选模型、一键出诊断结果,上方显示波形、下方输出类别与置信度。界面复用滑窗预测+多数投票逻辑,把预处理、模型、评估串成完整链路,并给出答辩"三连演示"话术,是让论文落地的加分项。
询盘跟进分级实务:五处信号、人工确认与跟进动作留痕
怎么判断一封询盘是真采购还是探价?本文直接回答:先看采购信息、发件身份、问法、往来节奏、流程意愿这五处,分成马上跟、先核实、先放一放三档再排跟进;分级是跟进顺序建议,不是给客户定性,不承诺识别准确率,人工确认后才发出。
云原生时代的网络监控工具评估:从 SNMP 采集到 AIOps 能力
本文剖析监控工具三大技术世代演进(SNMP→可观测性→AIOps),提出选型四大核心维度:采集架构(SNMP底座+OpenTelemetry收敛)、动态发现建模、可验证AI告警治理、开放集成能力,并针对云原生与混合云场景给出务实避坑指南。
ES 0.90 的 _ttl 能让文档自动过期,后来为什么被拿掉了
0.90 里给 mapping 加一个 ttl,文档到期就会被自动删掉——不用定时任务、不用 delete-by-query。
ES 写不进去的文档别再悄悄丢了,交给 Failure Store
ES 9.1 引入 Failure Store,把 ingest 失败或 mapping 冲突的文档存下来,9.2 起对日志流默认开启。
ES 超时从 5xx 改成 429,按 5xx 重试的代码会以为服务端挂了
9.0 起 Elasticsearch 的超时异常从 5xx 变成 429(Too Many Requests)。
Flink on Kubernetes 部署架构:一个 Deployment 与一群 Pod
本文深入解析Flink 2.3在Kubernetes上的部署架构,聚焦“对象所有权”这一核心逻辑:JobManager为Deployment,TaskManager由其动态创建的裸Pod组成,HA ConfigMap则刻意不设ownerReference以持久化元数据。厘清Standalone、Native与Operator三种模式的责任边界,并详解资源生命周期、扩缩容机制、配置注入及高频排障要点。
GEO做了一阵没咨询,先别整体叫停:代账公司的四段排查与停改条件
代账公司做GEO数月却无咨询?本文提供分段排查法:先拆解“没咨询”为曝光、到访、质量、转化四环节;优先检查咨询入口是否清晰;回溯真实客户问题优化选题;用可验证凭据建立信任;最后依数据与资源条件理性决策“停”或“改”。方法重实操,非效果承诺。
三之本体 3x3 律——2 即间 3 即构·几何第一性是构·3x3x1
BSD三之本体3x3律提出:2即“间”,3即“构”;几何第一性是结构而非形状。3×3×1为最小一层三角形,须具ABC三坐标(缺一则3×3×0=0),内角和180°自指链180→18→6→2,揭示±两极本质。全系统仅需1(心)、2(间)、3(构),无4向360°——属更高层界。
绷不住,DeepSeek Super-agent: Router动嘴,Worker干活
DeepSeek Harness: Super-agent 用Router动嘴Worker动手的方式解决多任务并行时人为瓶颈的问题
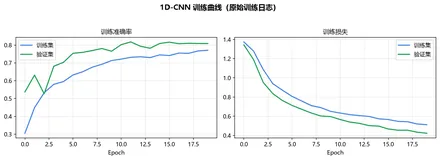
手把手教你:基于深度学习的滚动轴承故障诊断|第 7 篇 · 模型训练与评估:复现全部结果、读懂混淆矩阵
本文讲模型训练与评估的规范做法:5600条样本按7:3划分、固定随机种子保证可复现,测试集绝不参与训练;除准确率外还要看精确率、召回率、F1与混淆矩阵。核心是内圈召回率差异——随机森林0.73、CNN0.83、ResNet达95%+,三模型对比即成论文题眼。
广告花费诊断实务:四处查账、建议表与人工确认
为什么花了广告费却不赚钱?本文直接回答:先查花费去向、浪费词与素材、落点承接、利润口径这四处,再谈加价还是停词;只做诊断与建议,不代投放、不调账户、不承诺 ROAS,预算动作由人工确认。
只读预约首页会错过什么?我用 Codex 和 Moli 查了两家馆
我想在一个周六下午看鲁迅展或凤冠,让 Codex 调用本地 Moli 翻了两家馆的五页官网。国博首页和预约须知上的入馆时间差了半小时,决定我能不能在四点一刻进馆的是须知里的日期。
园区账期跑批:FC函数并发与连接池调优
某园区8600户租户月结账单原因单函数串行处理超时失败。改造后按200户分片、事件扇出、并发控制+连接池复用,账期窗口从47分钟压至6分40秒,RDS连接数降88%,费用减少67%,实现稳定高效月结。(239字)
EMAIL & PRIVATE · 邮件与私域
《人人都能用的AI工具》第六章聚焦邮件与私域运营实战:2026年触达核心不在文采,而在“送得到”与“发得准”。详解SPF/DKIM/DMARC认证、名单分层、企微频次红线及合规底线,用AI提效但不越界——先确保送达,再优化转化。(239字)
DeepSeek 没做的功能,网友们都给它实现了
文章介绍了社区开发者围绕 DeepSeek 开源 AI 工作台 Harness 制作的各类插件与主题,包括复刻 QQ 2008 粉色皮肤的开源项目、基于官方扩展接口的配色主题、壁纸与透明度调节工具、输入框旁余额显示插件,以及将 RSS 资讯产品嵌入侧栏的案例,展示了 Harness 插件化与创造模式带来的可定制空间。
小规模试做GEO:如何用可核对记录判断继续还是停
本文为财税服务公司提供GEO小规模试做方法论:强调“先定验证问题、再谈预算”,将投入拆为内容整理、外部支出与复盘精力三块;试做时长以跑完“问题收集—内容整理—发布—记录—复盘”完整动作为准;主张用事实记录替代主观感觉,明确停止条件。核心是把试做当作一次经营能力演练。
如何发现 AI 回答中的品牌错误信息?换一批新回答再对一遍,11 种错说法还剩 3 种
要找出 AI 说错的品牌信息,事实表加逐条比对只是开头,对一次远远不够。同一套规则换一批新回答再跑:11 种错说法里 8 种不见了,「有免费版」一直在,又冒出 1 种新的,被引的源头页面也换了。顺带记下几个坑:只看总错误率、只抽查一天、不复核脚本标出的错。
Flink TaskManager 作用:只做计算的那个进程
Flink TaskManager非“从节点”,而是唯一执行用户代码的核心进程。其OOMKilled多因内存配置失当——managed memory超限被内核强杀,日志无堆栈。根本在于厘清八段内存账、slot隔离边界与资源配比逻辑。(239字)
在浏览器里跑抠图模型:BiRefNet-lite加ONNX Runtime Web,实测发丝、毛发和玻璃杯
把BiRefNet-lite抠图模型放进浏览器,用ONNX Runtime Web的WebAssembly后端多线程推理:模型缓存、跨源隔离响应头、1024和768两档输入与内存不足时的降级、遮罩的双线性放大,以及发丝、毛发、玻璃杯三张难图的实测。
AI 视频切片 API 实战:调用长视频自动拆片,支持直播/赛事/访谈/综艺场景
本文详解销豹AI视频切片API的工程化接入:如何通过智能识别,将长视频(直播/访谈/赛事等)自动切分为带主题、摘要和时间戳的短视频片段。涵盖场景选择(5类scene_id)、参数配置、异步任务轮询、结果解析及生产环境注意事项,助力内容团队降本增效。
Python 的 0.1 + 0.2 为什么不等于 0.3?拆开 IEEE 754 与那串死循环小数
list 能装下任何类型,是因为它存的是 PyObject* 指针数组:类型信息挂在对象自己头上。代价是每元素 8 字节指针加完整对象头——实测 100 万个整数,list 总内存约 34.3MB,是 array 的 9 倍。本文用 sys.getsizeof 一格格量给你看,并给出什么时候该换 array/numpy 的判断标准
园区账单表分区归档:历史查询压到亚秒级
园区水电账单表按账期RANGE分区,24个月前已结清数据通过EXCHANGE PARTITION秒级切至归档库,热库仅存活跃数据。实测单租户24个月查询P95从4.3秒降至380毫秒,出账窗口缩至42分钟,热库容量减少76%。(239字)
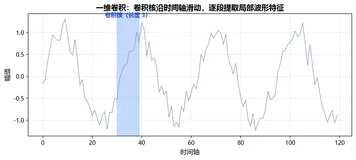
手把手教你:基于深度学习的滚动轴承故障诊断|第 6 篇 · 一维卷积与残差模块:83% 到 95% 的原理拆解
本文拆解83%到95%的原理:深度学习让模型自己看波形。浅层CNN准确率约83%,内圈与滚动体分不清;残差网络引入"捷径"F(x)+x,让网络加深而不退化、解决梯度消失,同数据同评估下准确率提到95%+,是论文最有含金量的一篇。
从代码上下文到千亿级文档:Qoder × 阿里云 Elasticsearch 落地生产级向量检索
阿里巴巴 ATH 事业群 Qoder 技术专家夏晓文分享大规模代码检索的架构选择、工程实践与运行效果,并展望代码、记忆和企业知识的融合检索
存算分离冷查询提速 7.5 倍!Apache Doris 4.2 Peer Read 实现跨计算组缓存复用
Apache Doris 4.2 引入 Peer Read 机制,实现存算分离架构下跨计算组缓存复用,解决冷查询延迟高、扩缩容后缓存失效等问题。实测主键点查冷查询提速约 7.5 倍,P99 延迟降低约 80%,对象存储请求减少约 98%,全面解析工作原理、性能测试与配置方法。
大模型入门(一):先把名词和名字弄明白
本文厘清大模型领域常见术语混淆:LLM是类别,GPT是技术路线,Transformer是底层架构,token是计量单位,参数≠数据库,上下文窗口与温度是关键调控开关。名称对齐,方能有效对话。(238字)
大数据与机器学习
大数据领域前沿技术分享与交流,这里不止有技术干货、学习心得、企业实践、社区活动,还有未来。