前言
在这里学习介绍一种快速完成人脸检测,实测检测FPS超越OpenCv自带 haarcascade 系列。 直接执行:
pip install mediapipe
复制代码
概述
MediaPipe 人脸检测是一种超快的人脸检测解决方案,具有 6 个地标和多面支持。它基于BlazeFace,这是一种为移动 GPU 推理量身定制的轻量级且性能良好的人脸检测器。该探测器的超实时性能使其能够应用于任何需要准确的面部感兴趣区域作为其他特定任务模型的输入的实时取景器体验,例如 3D 面部关键点估计(例如,MediaPipe Face Mesh)、面部特征或表情分类,以及人脸区域分割。BlazeFace 使用轻量级特征提取网络,其灵感来自但不同于MobileNetV1/V2 ,这是一种由Single Shot MultiBox Detector (SSD)修改的 GPU 友好型锚方案(arxiv.org/abs/1512.02…
示例demo
修改model_selection整数索引0或1. 用于0选择最适合距离相机 2 米以内的人脸的短距离模型,以及1最适合 5 米内人脸的全距离模型。min_detection_confidence取值在[0.0, 1.0],表示为人脸检测模型中的最小置信度值被认为是成功的检测。默认为0.5。
检测到的人脸集合,其中每个人脸都表示为一个检测原型消息,其中包含一个边界框和 6 个关键点(右眼、左眼、鼻尖、嘴巴中心、右耳和左耳)。边界框由xmin和width(均由[0.0, 1.0]图像宽度归一化)和ymin和(均由图像高度height归一化)组成。[0.0, 1.0]每个关键点由x和组成,分别由图像宽度和高度y归一化。[0.0, 1.0]
import cv2
import mediapipe as mp
mp_face_detection = mp.solutions.face_detection
mp_drawing = mp.solutions.drawing_utils
# For webcam input:
cap = cv2.VideoCapture(0)
with mp_face_detection.FaceDetection(model_selection=0,
                                     min_detection_confidence=0.5) as face_detection:
    while cap.isOpened():
        success, image = cap.read()
        if not success:
            print("Ignoring empty camera frame.")
            # If loading a video, use 'break' instead of 'continue'.
            continue
        # To improve performance, optionally mark the image as not writeable to
        # pass by reference.
        image.flags.writeable = False
        image = cv2.cvtColor(image, cv2.COLOR_BGR2RGB)
        results = face_detection.process(image)
        # Draw the face detection annotations on the image.
        image.flags.writeable = True
        image = cv2.cvtColor(image, cv2.COLOR_RGB2BGR)
        if results.detections:
            for detection in results.detections:
                mp_drawing.draw_detection(image, detection)
        # Flip the image horizontally for a selfie-view display.
        cv2.imshow('MediaPipe Face Detection', cv2.flip(image, 1))
        if cv2.waitKey(5) & 0xFF == 27:
            break
cap.release()
复制代码
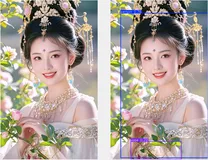
使用单张图像进行检测可得如下测试效果:


拓展
我们可以在代码中检测到处理图像的shape=(480, 640, 3),经过归一化后检测数据映射到[0,1],在这里按照比例可以反归一化获取目标坐标在shape上的坐标,建立人脸图像及五官坐标矩阵可以辅助完成人脸识别项目,提高识别率。