CV:基于Keras利用CNN主流架构之mini_XCEPTION训练性别分类模型hdf5并保存到指定文件夹下

简介: CV:基于Keras利用CNN主流架构之mini_XCEPTION训练性别分类模型hdf5并保存到指定文件夹下

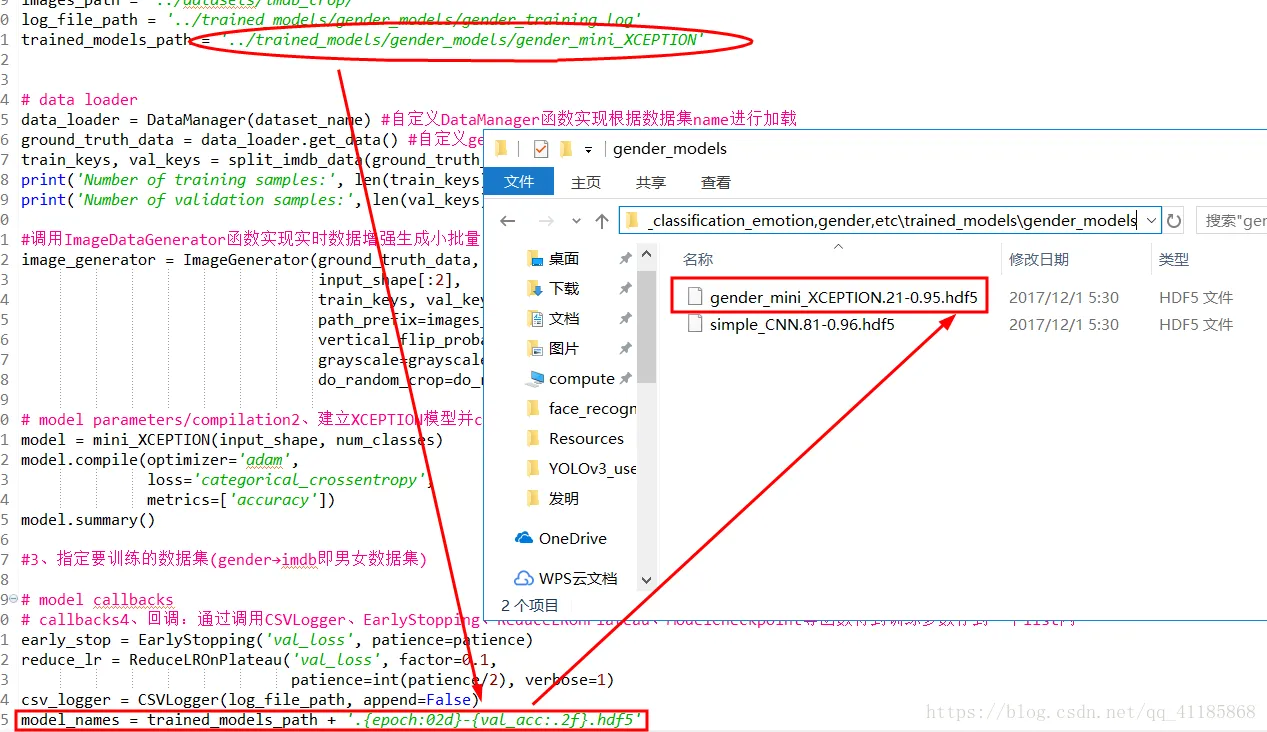
图示过程

image.png


核心代码

from keras.callbacks import CSVLogger, ModelCheckpoint, EarlyStopping

from keras.callbacks import ReduceLROnPlateau

from models.cnn import mini_XCEPTION

# parameters1、定义参数:每个batch的采样本数、训练轮数、输入shape、部分比例分离用于验证、冗长参数、分类个数、patience、do_random_crop

batch_size = 32

num_epochs = 1000

validation_split = .2

do_random_crop = False  #random crop only works for classification since the current implementation does no transform bounding boxes

patience = 100

num_classes = 2

dataset_name = 'imdb'

input_shape = (64, 64, 1)

#if判断,然后指定图像、log、loghdf5各自保存路径

if input_shape[2] == 1:

   grayscale = True

images_path = '../datasets/imdb_crop/'

log_file_path = '../trained_models/gender_models/gender_training.log'

trained_models_path = '../trained_models/gender_models/gender_mini_XCEPTION'

# data loader

data_loader = DataManager(dataset_name) #自定义DataManager函数实现根据数据集name进行加载

ground_truth_data = data_loader.get_data() #自定义get_data函数根据不同数据集name得到各自的ground truth data,

train_keys, val_keys = split_imdb_data(ground_truth_data, validation_split)

print('Number of training samples:', len(train_keys))

print('Number of validation samples:', len(val_keys))

#调用ImageDataGenerator函数实现实时数据增强生成小批量的图像数据。

image_generator = ImageGenerator(ground_truth_data, batch_size,

                                input_shape[:2],

                                train_keys, val_keys, None,

                                path_prefix=images_path,

                                vertical_flip_probability=0,

                                grayscale=grayscale,

                                do_random_crop=do_random_crop)

# model parameters/compilation2、建立XCEPTION模型并compile编译配置参数,最后输出网络摘要

model = mini_XCEPTION(input_shape, num_classes)

model.compile(optimizer='adam',

             loss='categorical_crossentropy',

             metrics=['accuracy'])

model.summary()

#3、指定要训练的数据集(gender→imdb即男女数据集)

# model callbacks

# callbacks4、回调:通过调用CSVLogger、EarlyStopping、ReduceLROnPlateau、ModelCheckpoint等函数得到训练参数存到一个list内

early_stop = EarlyStopping('val_loss', patience=patience)

reduce_lr = ReduceLROnPlateau('val_loss', factor=0.1,

                             patience=int(patience/2), verbose=1)

csv_logger = CSVLogger(log_file_path, append=False)

model_names = trained_models_path + '.{epoch:02d}-{val_acc:.2f}.hdf5'

model_checkpoint = ModelCheckpoint(model_names,

                                  monitor='val_loss',

                                  verbose=1,

                                  save_best_only=True,

                                  save_weights_only=False)

callbacks = [model_checkpoint, csv_logger, early_stop, reduce_lr]

# training model5、调用fit_generator函数训练模型

model.fit_generator(image_generator.flow(mode='train'),

                   steps_per_epoch=int(len(train_keys) / batch_size),

                   epochs=num_epochs, verbose=1,

                   callbacks=callbacks,

                   validation_data=image_generator.flow('val'),

                   validation_steps=int(len(val_keys) / batch_size))

相关文章
|
机器学习/深度学习 人工智能 监控
大型动作模型LAM:让企业重复任务实现80%效率提升的AI技术架构与实现方案
大型动作模型(LAMs)作为人工智能新架构,融合神经网络与符号逻辑,实现企业重复任务的自动化处理。通过神经符号集成、动作执行管道、模式学习、任务分解等核心技术,系统可高效解析用户意图并执行复杂操作,显著提升企业运营效率并降低人工成本。其自适应学习能力与上下文感知机制,使自动化流程更智能、灵活,为企业数字化转型提供坚实支撑。
739 0
大型动作模型LAM:让企业重复任务实现80%效率提升的AI技术架构与实现方案
|
存储 BI Shell
Doris基础-架构、数据模型、数据划分
Apache Doris 是一款高性能、实时分析型数据库,基于MPP架构,支持高并发查询与复杂分析。其前身是百度的Palo项目,现为Apache顶级项目。Doris适用于报表分析、数据仓库构建、日志检索等场景,具备存算一体与存算分离两种架构,灵活适应不同业务需求。它提供主键、明细和聚合三种数据模型,便于高效处理更新、存储与统计汇总操作,广泛应用于大数据分析领域。
1432 2
|
人工智能 负载均衡 API
长连接网关技术专题(十二):大模型时代多模型AI网关的架构设计与实现
随着 AI 技术快速发展,业务对 AI 能力的渴求日益增长。当 AI 服务面对处理大规模请求和高并发流量时,AI 网关从中扮演着至关重要的角色。AI 服务通常涉及大量的计算任务和设备资源占用,此时需要一个 AI 网关负责协调这些请求来确保系统的稳定性与高效性。因此,与传统微服务架构类似,我们将相关 API 管理的功能(如流量控制、用户鉴权、配额计费、负载均衡、API 路由等)集中放置在 AI 网关层,可以降低系统整体复杂度并提升可维护性。 本文要分享的是B站在大模型时代基于多模型AI的网关架构设计和实践总结,希望能带给你启发。
1510 4
|
人工智能 缓存 自然语言处理
Bolt DIY架构揭秘:从模型初始化到响应生成的技术之旅
在使用Bolt DIY或类似的AI对话应用时,你是否曾好奇过从输入提示词到获得回答的整个过程是如何运作的?当你点击发送按钮那一刻,背后究竟发生了什么?本文将揭开这一过程的神秘面纱,深入浅出地解析AI对话系统的核心技术架构。
579 5
|
人工智能 算法 网络安全
基于PAI+专属网关+私网连接:构建全链路Deepseek云上私有化部署与模型调用架构
本文介绍了阿里云通过PAI+专属网关+私网连接方案,帮助企业实现DeepSeek-R1模型的私有化部署。方案解决了算力成本高、资源紧张、部署复杂和数据安全等问题,支持全链路零公网暴露及全球低延迟算力网络,最终实现技术可控、成本优化与安全可靠的AI部署路径,满足企业全球化业务需求。
|
机器学习/深度学习 数据可视化 网络架构
PINN训练新思路:把初始条件和边界约束嵌入网络架构,解决多目标优化难题
PINNs训练难因多目标优化易失衡。通过设计硬约束网络架构,将初始与边界条件内嵌于模型输出,可自动满足约束,仅需优化方程残差,简化训练过程,提升稳定性与精度,适用于气候、生物医学等高要求仿真场景。
1146 4
PINN训练新思路:把初始条件和边界约束嵌入网络架构,解决多目标优化难题
|
数据采集 机器学习/深度学习 搜索推荐
MIT新论文:数据即上限,扩散模型的关键能力来自图像统计规律,而非复杂架构
MIT与丰田研究院研究发现,扩散模型的“局部性”并非源于网络架构的精巧设计,而是自然图像统计规律的产物。通过线性模型仅学习像素相关性,即可复现U-Net般的局部敏感模式,揭示数据本身蕴含生成“魔法”。
446 3
MIT新论文:数据即上限,扩散模型的关键能力来自图像统计规律,而非复杂架构
|
机器学习/深度学习 数据采集 并行计算
多步预测系列 | LSTM、CNN、Transformer、TCN、串行、并行模型集合研究(Python代码实现)
1136 2
|
机器学习/深度学习 数据采集 运维
基于WOA-CNN-BiLSTM-Attention、CNN-BiLSTM-Attention、WOA-CNN-BiLSTM、CNN-BiLSTM、BiLSTM、CNN6模型单变量时序预测一键对比研究
399 7
|
机器学习/深度学习 存储 缓存
115_LLM基础模型架构设计:从Transformer到稀疏注意力
大型语言模型(LLM)的架构设计是其性能的核心决定因素。从2017年Transformer架构的提出,到如今的稀疏注意力和混合专家模型,LLM架构经历了快速的演进。本文将全面探讨LLM基础架构的设计原理,深入分析Transformer的核心机制,详细介绍稀疏注意力、MoE等创新架构,并展望未来架构发展方向。通过数学推导和实践案例,为构建高效、强大的LLM提供全面指导。
1349 0