以我的经验来讲,理解K8S集群服务的概念,是比较不容易的一件事情。尤其是当我们基于似是而非的理解,去排查服务相关问题的时候,会非常不顺利。
这体现在,对于新手来说,ping不通服务的IP地址这样基础的问题,都很难理解;而就算对经验很丰富的工程师来说,看懂服务相关的iptables配置,也是相当的挑战。
今天这边文章,我来深入解释一下K8S集群服务的原理与实现,便于大家理解。
K8S集群服务的本质是什么
概念上来讲,K8S集群的服务,其实就是负载均衡、或反向代理。这跟阿里云的负载均衡产品,有很多类似的地方。和负载均衡一样,服务有它的IP地址以及前端端口;服务后边会挂载多个容器组Pod作为其“后端服务器”,这些“后端服务器”有自己的IP以及监听端口。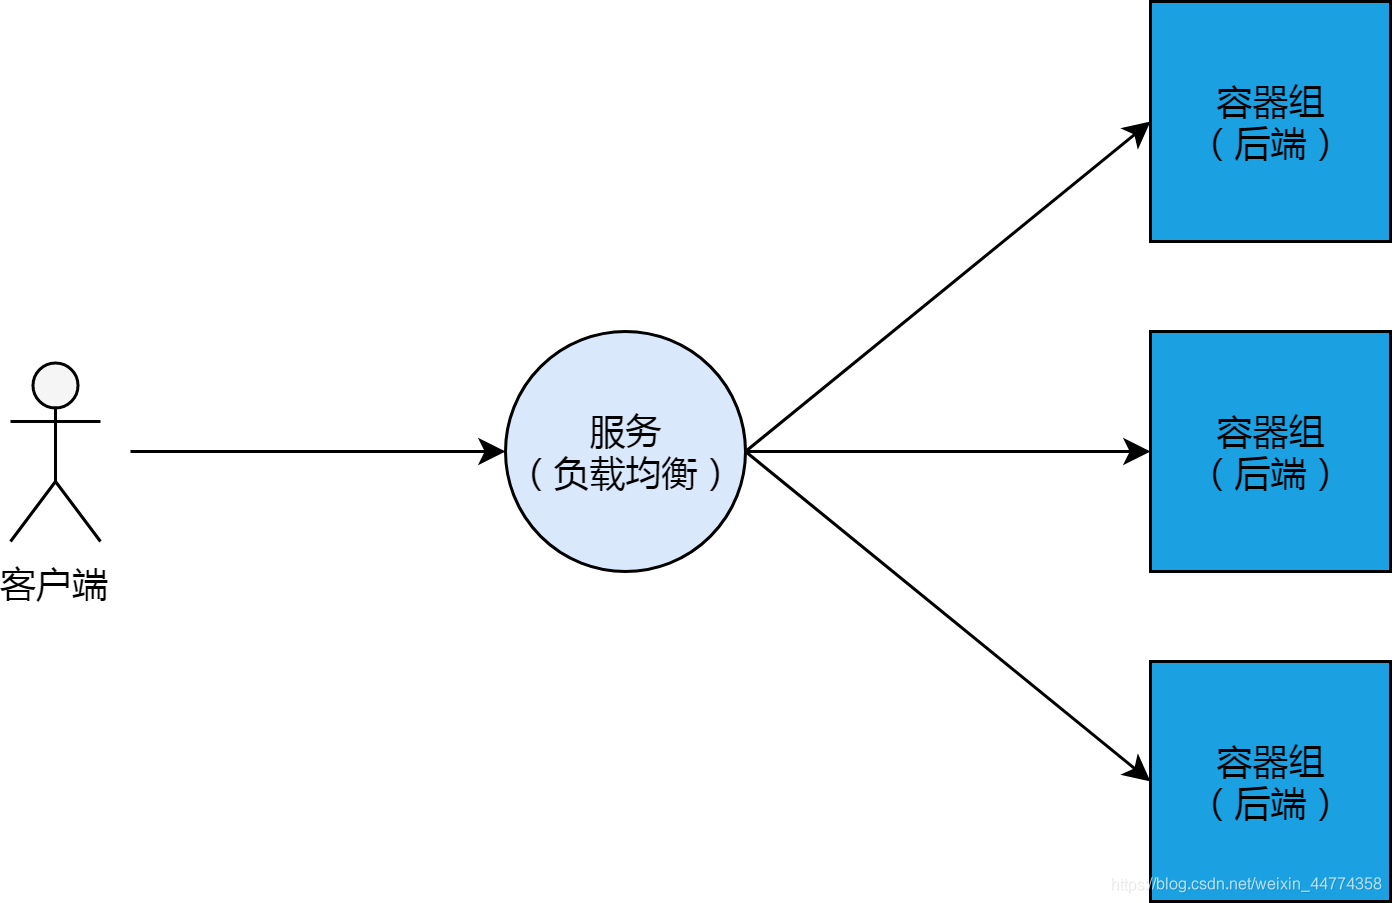
当这样的负载均衡和后端的架构,与K8S集群结合的时候,我们可以想到的最直观的实现方式,就是集群中某一个节点专门做负载均衡(类似LVS)的角色,而其他节点则用来负载后端容器组。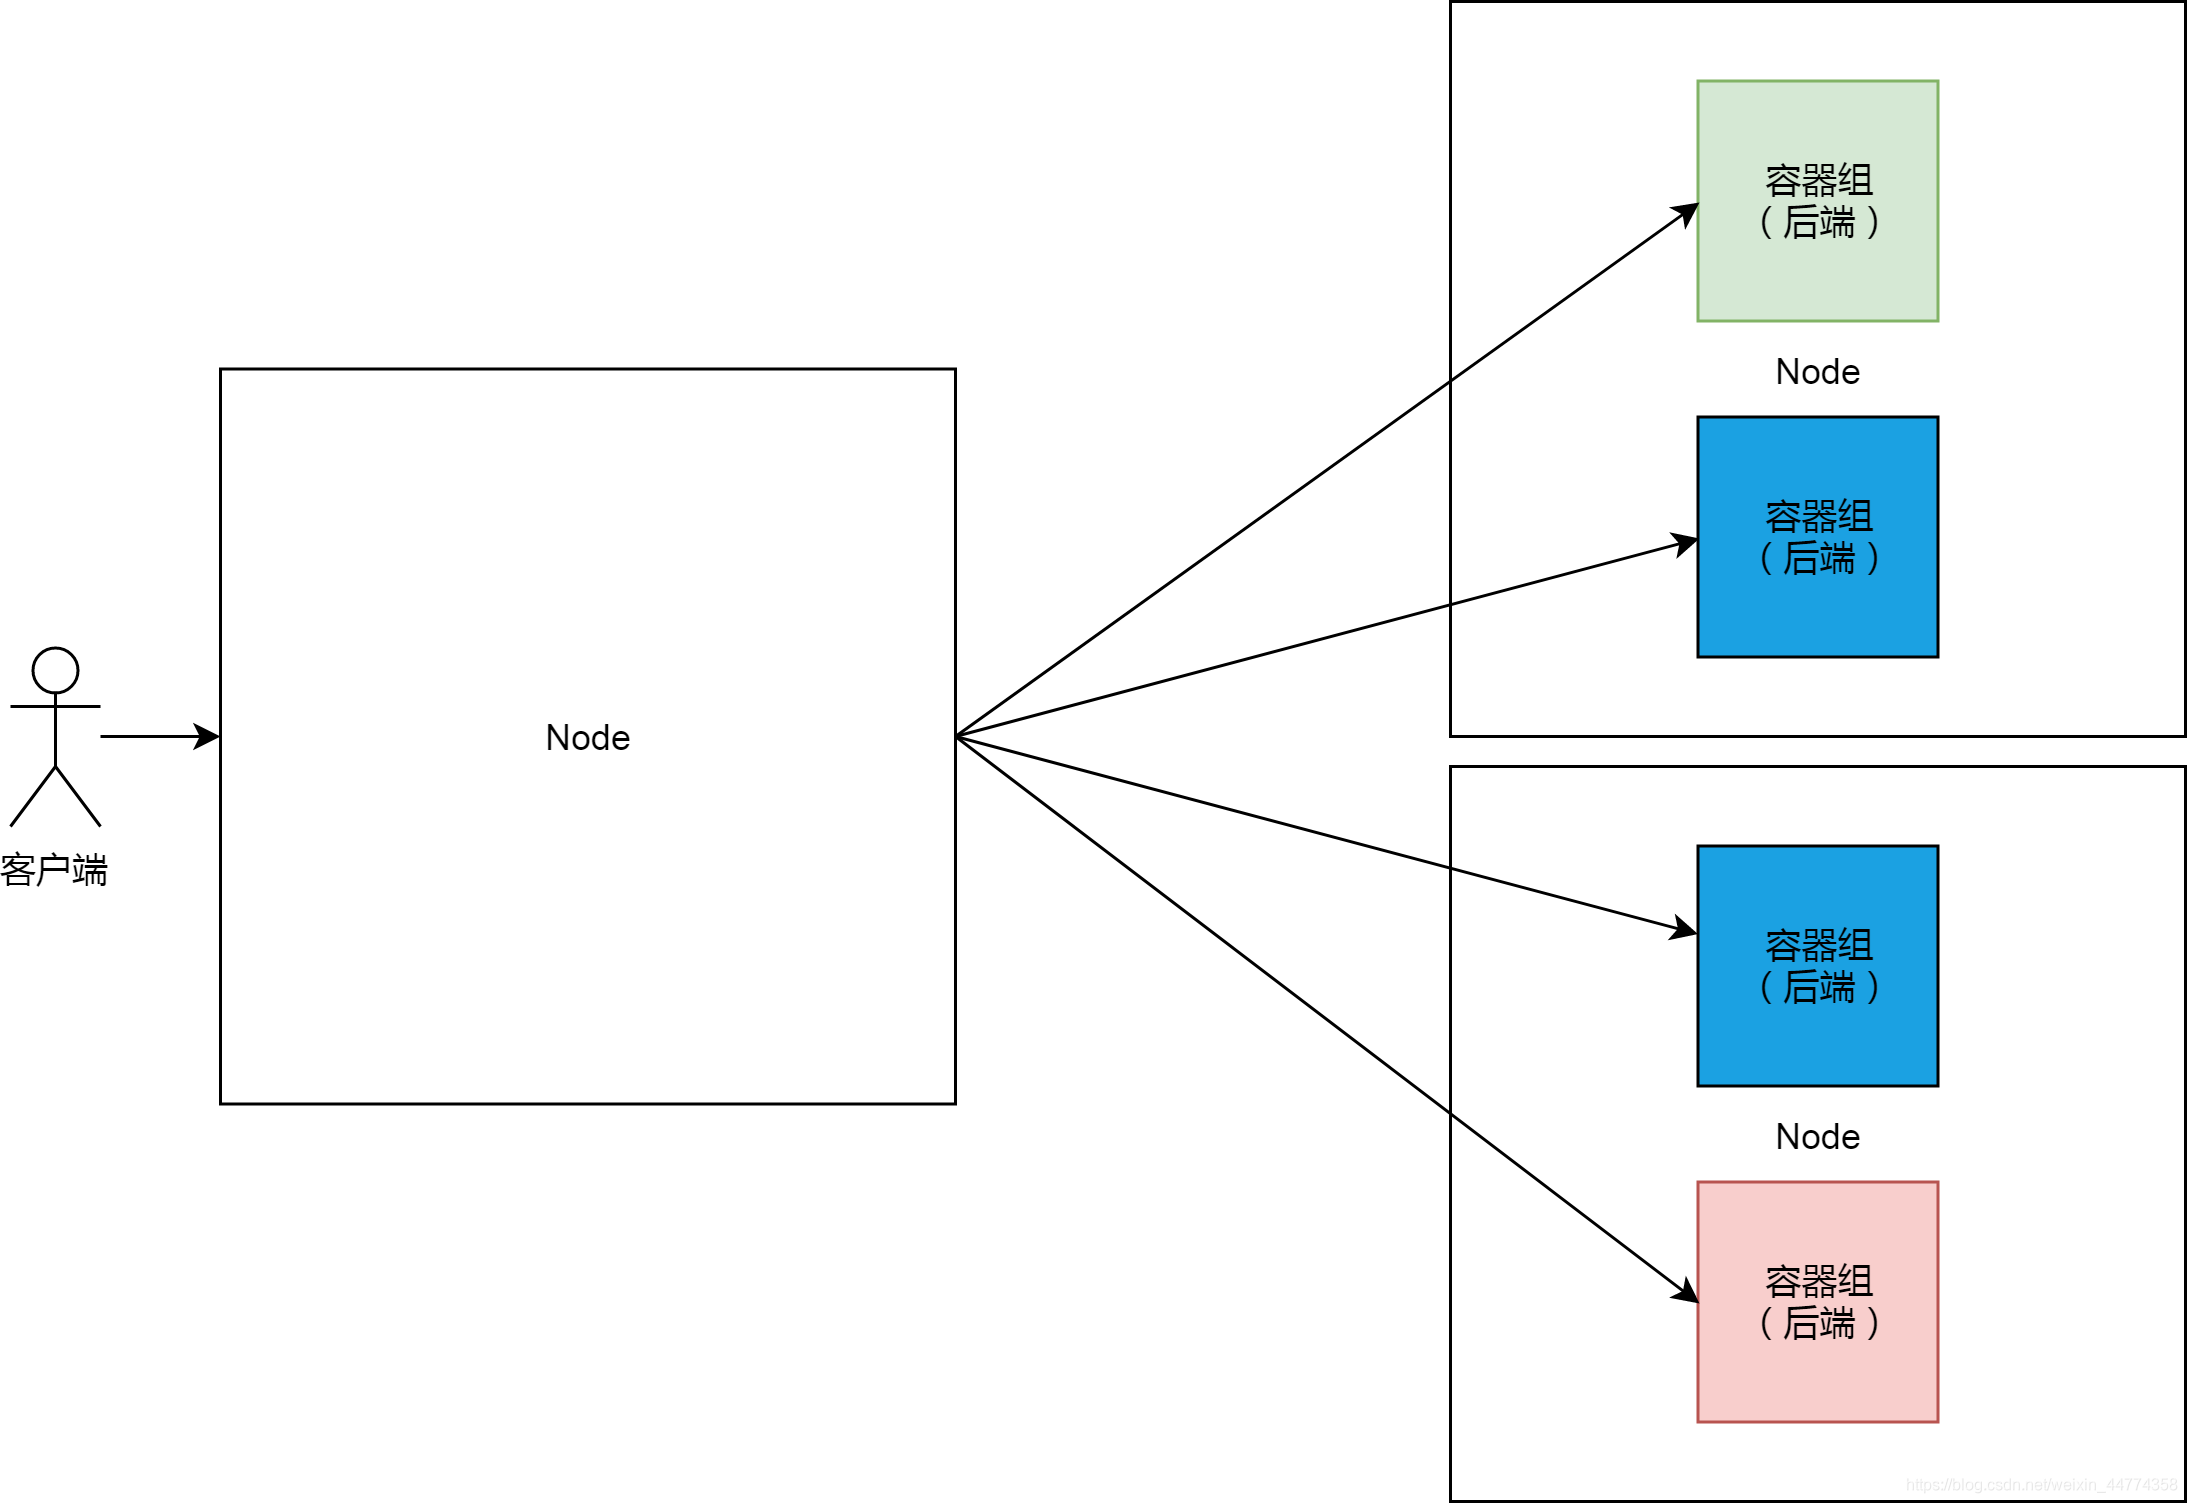
这样的实现方法,有一个巨大的缺陷,就是单点问题。K8S集群是Google多年来自动化运维实践的结晶,这样的实现显然与其智能运维的哲学相背离的。
自带通信员
边车模式(Sidecar)是微服务领域的核心概念。边车模式,换一句通俗一点的说法,就是自带通信员。熟悉服务网格的同学肯定对这个很熟悉了。但是可能比较少人注意到,其实K8S集群原始服务的实现,也是基于Sidecar模式的。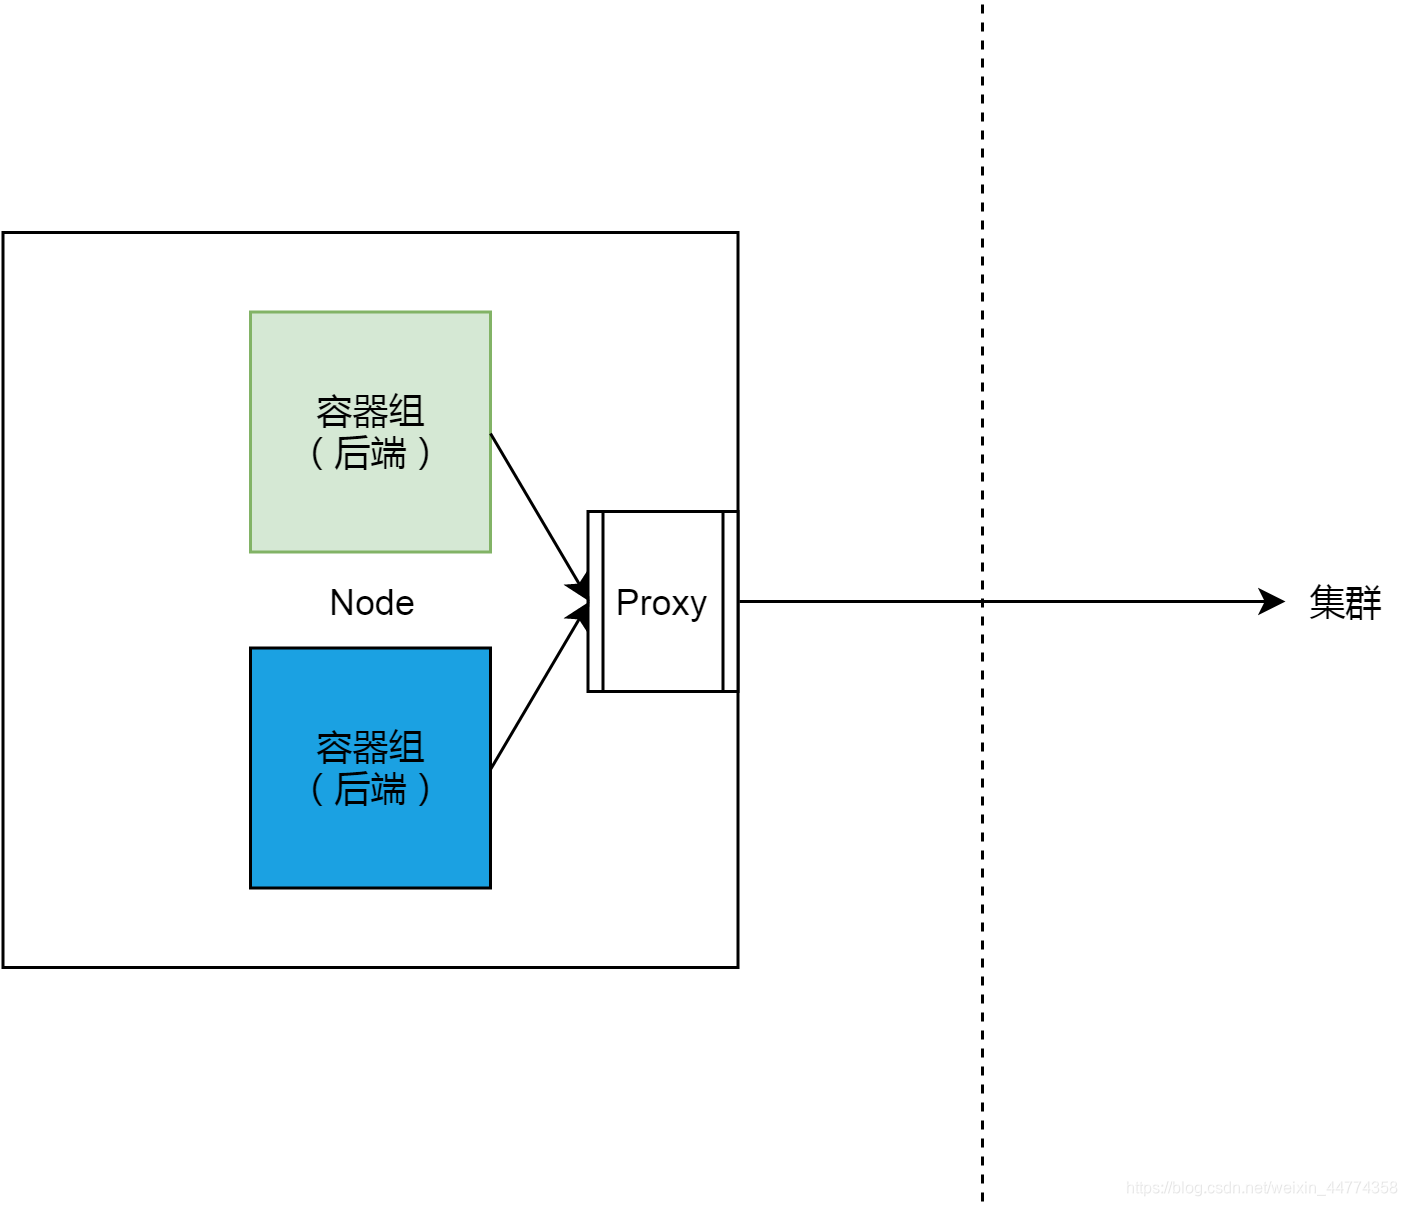
在K8S集群中,服务的实现,实际上是为每一个集群节点上,部署了一个反向代理Sidecar。而所有对集群服务的访问,都会被节点上的反向代理转换成对服务后端容器组的访问。基本上来说,节点和这些Sidecar的关系如下图所示。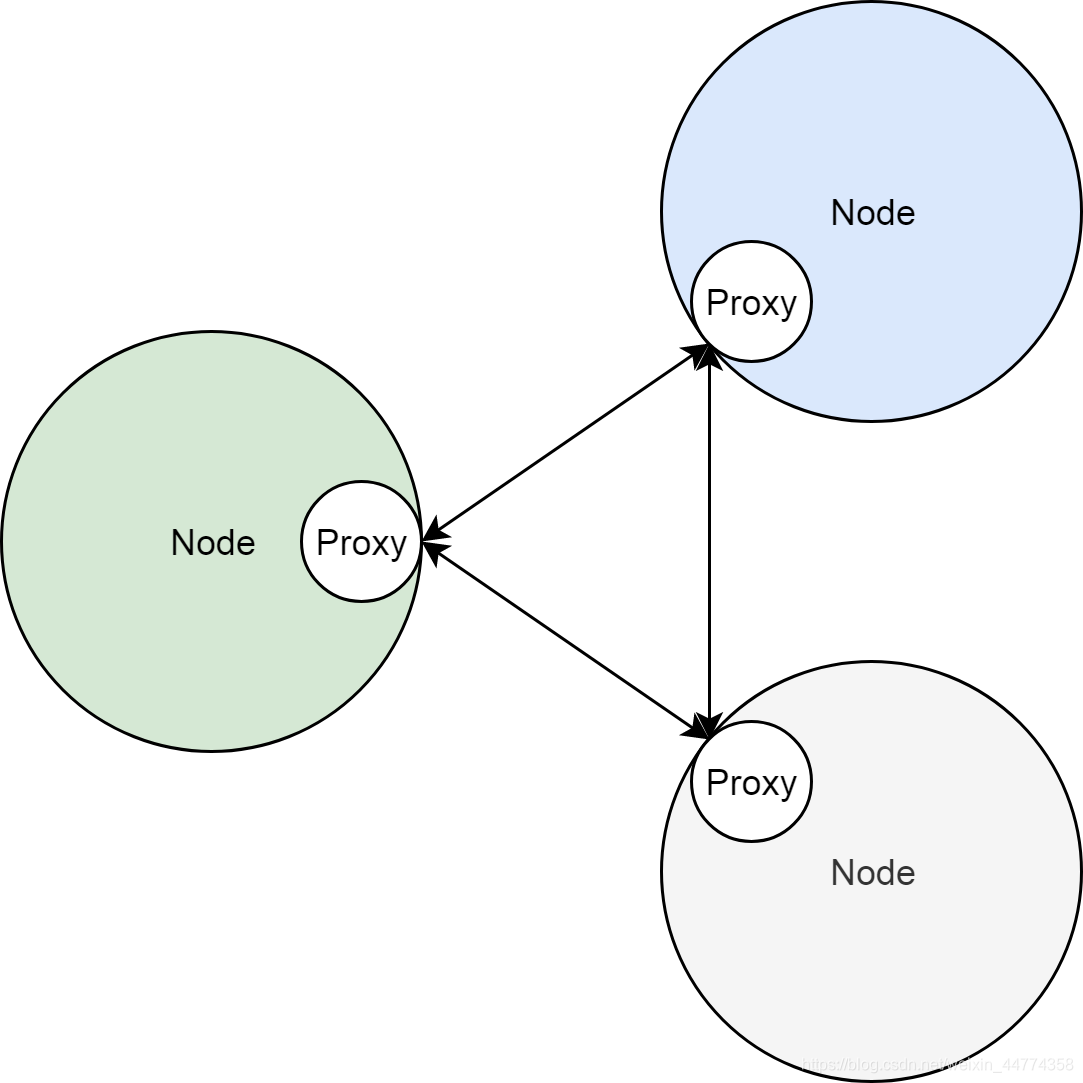
把服务照进现实
前边两节,我们看到了,K8S集群的服务,本质上是负载均衡,即反向代理;同时我们知道了,在实际实现中,这个反向代理,并不是部署在集群某一个节点上,而是作为集群节点的边车,部署在每个节点上的。
在这里把服务照进反向代理这个现实的,是K8S集群的一个控制器,即kube-proxy。关于K8S集群控制器的原理,请参考我另外一篇关于控制器的文章。简单来说,kube-proxy作为部署在集群节点上的控制器,它们通过集群API Server监听着集群状态变化。当有新的服务被创建的时候,kube-proxy则会把集群服务的状态、属性,翻译成反向代理的配置。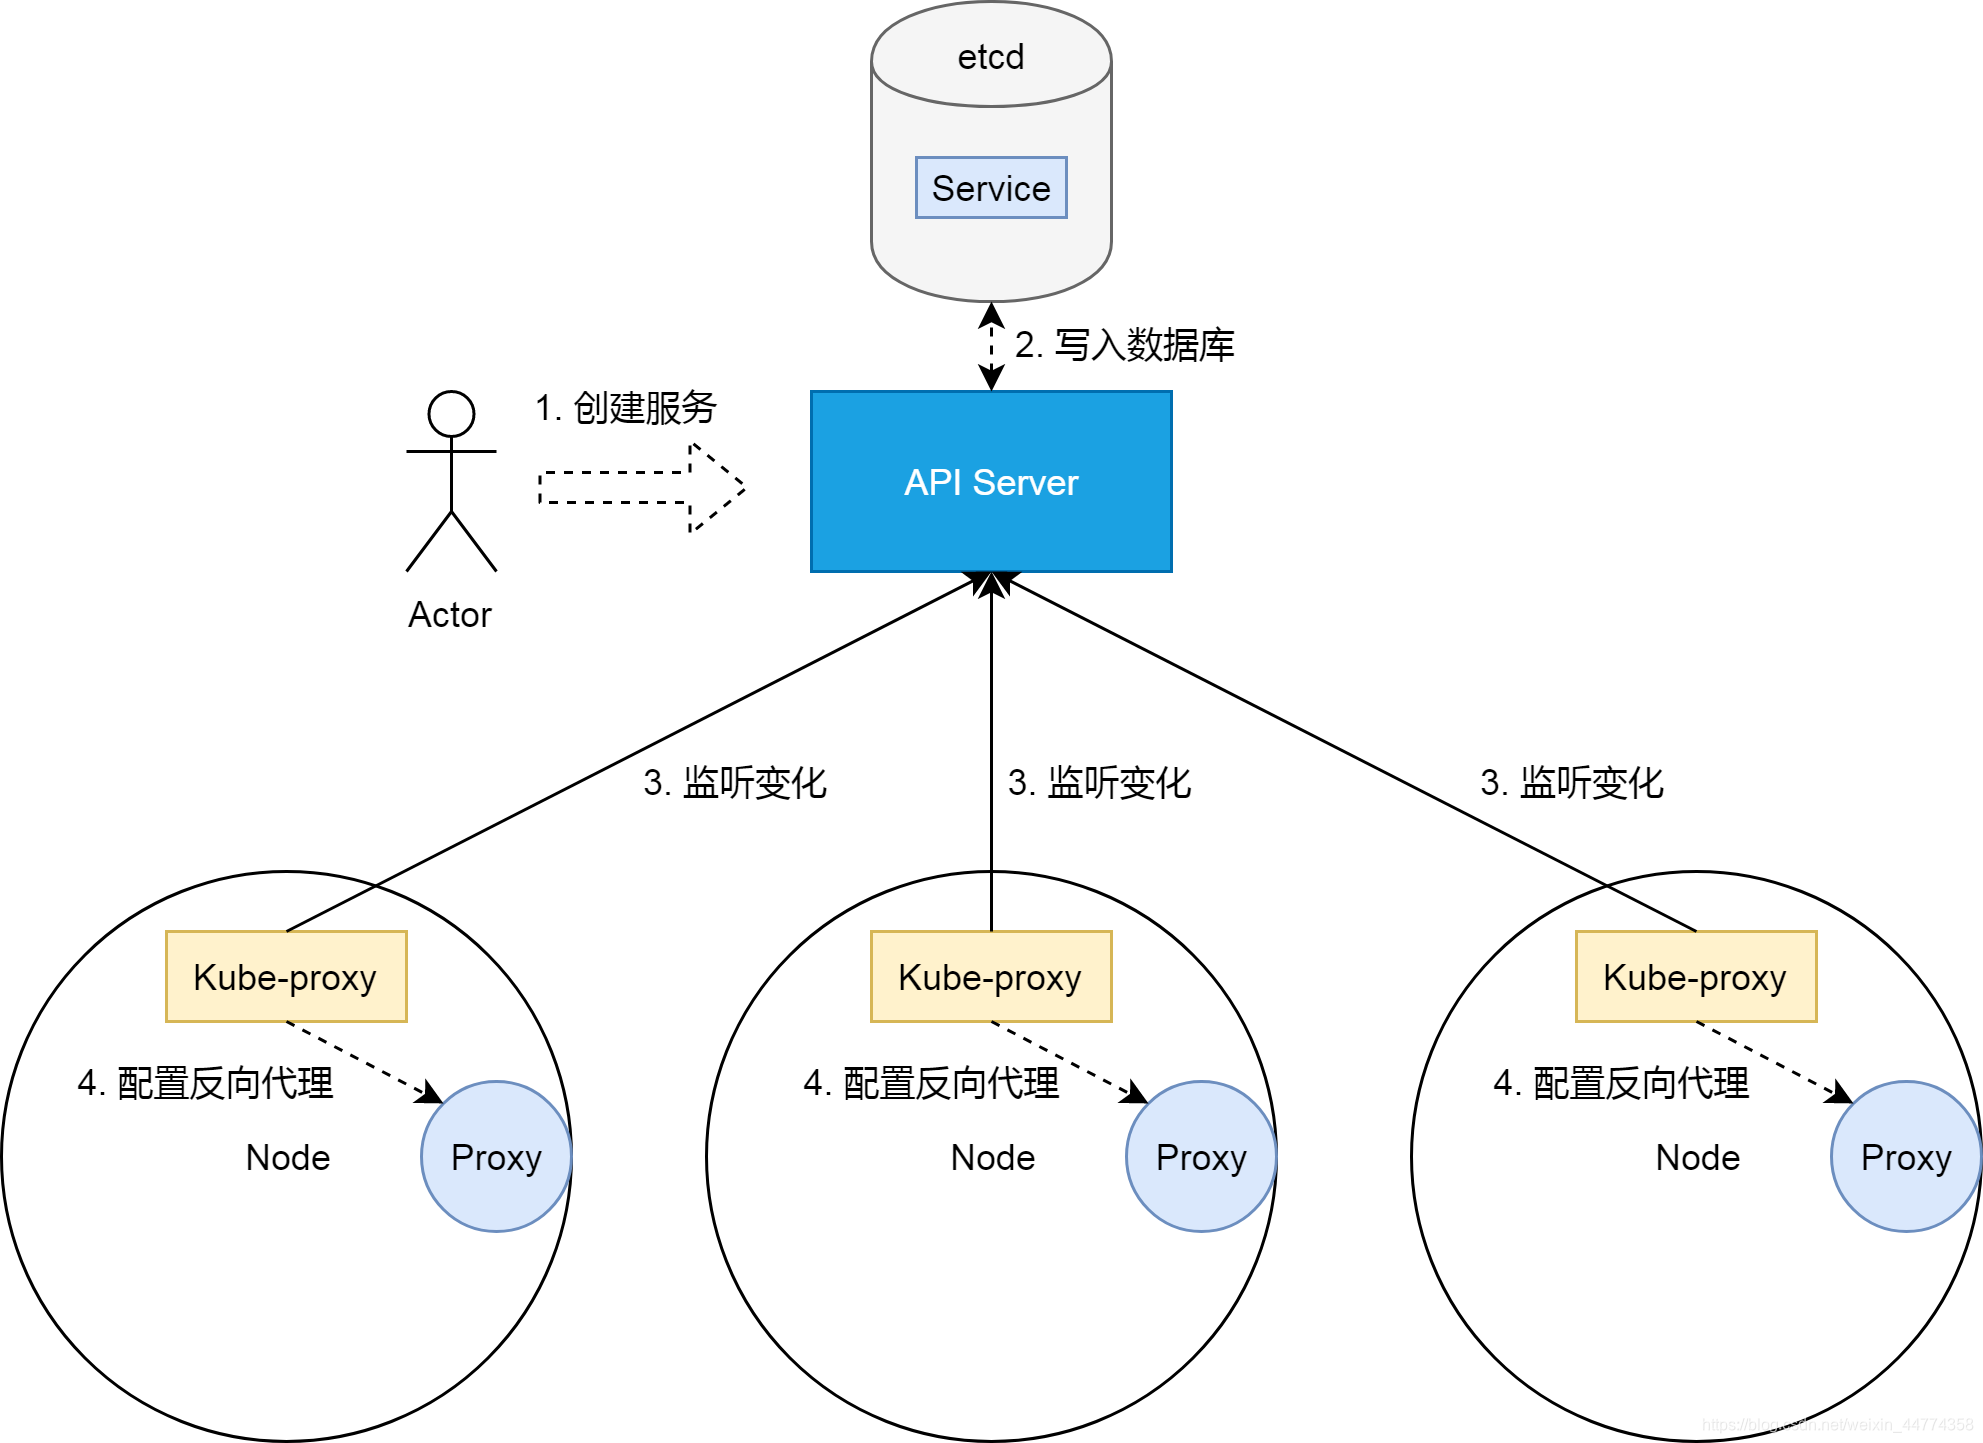
那剩下的问题,就是反向代理,即上图中Proxy的实现。
一种实现
K8S集群节点实现服务反向代理的方法,目前主要有三种,即userspace、iptables以及ipvs。今天我们只深入分析iptables的方式,底层网络基于阿里云flannel集群网络。
过滤器框架
现在,我们来设想一种场景。我们有一个屋子。这个屋子有一个入水管和出水管。从入水管进入的水,是不能直接饮用的,因为有杂质。而我们期望,从出水管流出的水,可以直接饮用。为了达到目的,我们切开水管,在中间加一个杂质过滤器。
过了几天,我们的需求变了,我们不止要求从屋子里流出来的水可以直接饮用,我们还希望水是热水。所以我们不得不再在水管上增加一个切口,然后增加一个加热器。
很明显,这种切开水管,增加新功能的方式是很丑陋的。因为需求可能随时会变,我们甚至很难保证,在经过一年半载之后,这跟水管还能找得到可以被切开的地方。
所以我们需要重新设计。首先我们不能随便切开水管,所以我们要把水管的切口固定下来。以上边的场景为例,我们确保水管只能有一个切口位置。其次,我们抽象出对水的两种处理方式:物理变化和化学变化。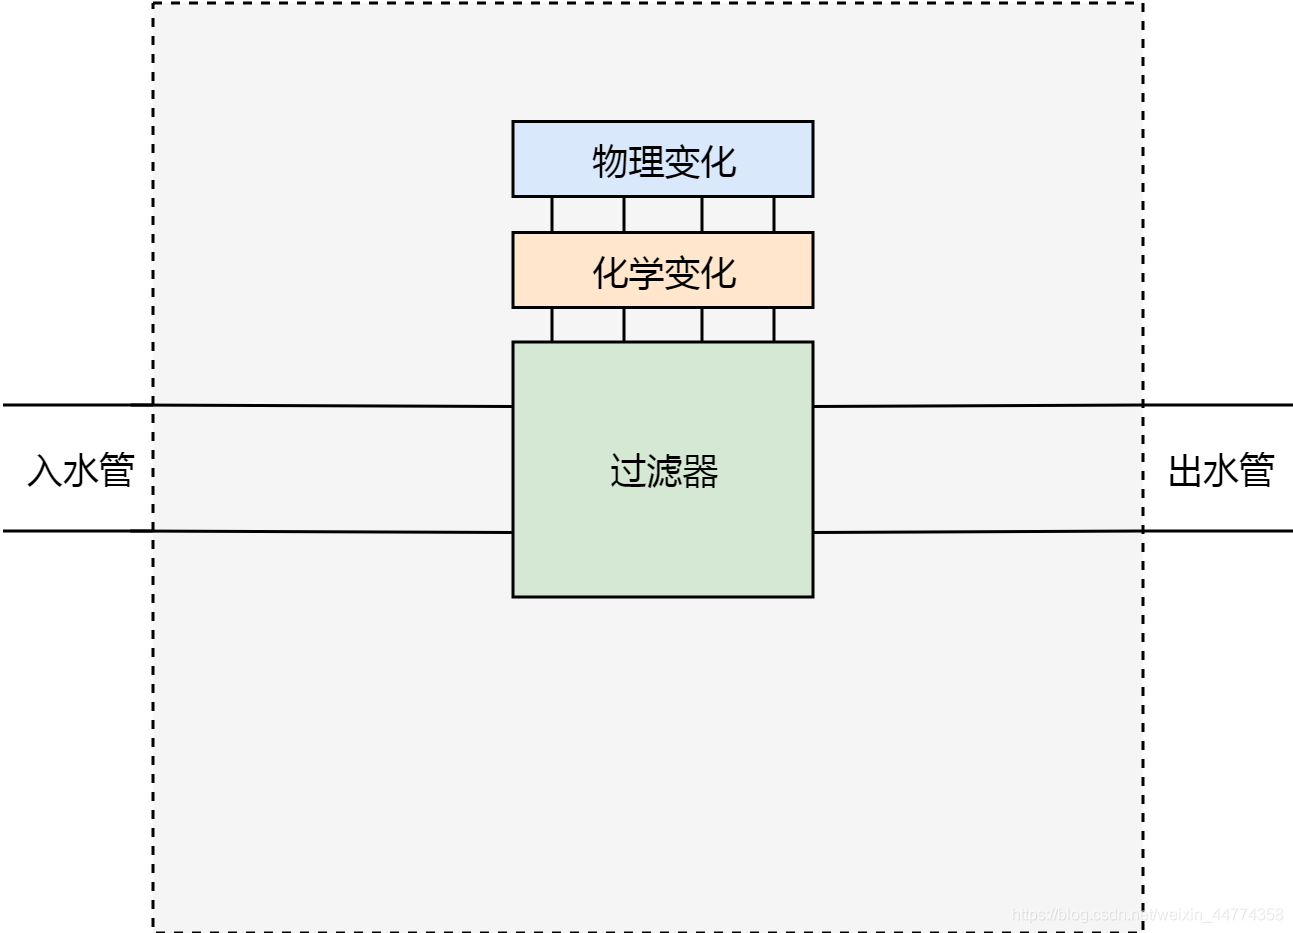
基于以上的设计,如果我们需要过滤杂质,就可以在化学变化这个功能模块里增加一条过滤杂质的规则;如果我们需要增加温度的话,就可以在物理变化这个功能模块里增加一条加热的规则。
以上的过滤器框架,显然比切水管的方式,要优秀很多。设计这个框架,我们主要做了两件事情,一个是固定水管切口位置,另外一个是抽象出两种水处理方式。
理解这两件事情之后,我们可以来看下iptables,或者更准确的说法,netfilter的工作原理。netfilter实际上就是一个过滤器框架。netfilter在网络包收发及路由的管道上,一共切了5个口,分别是PREROUTING,FORWARD,POSTROUTING,INPUT以及OUTPUT;同时netfilter定义了包括nat、filter在内的若干个网络包处理方式。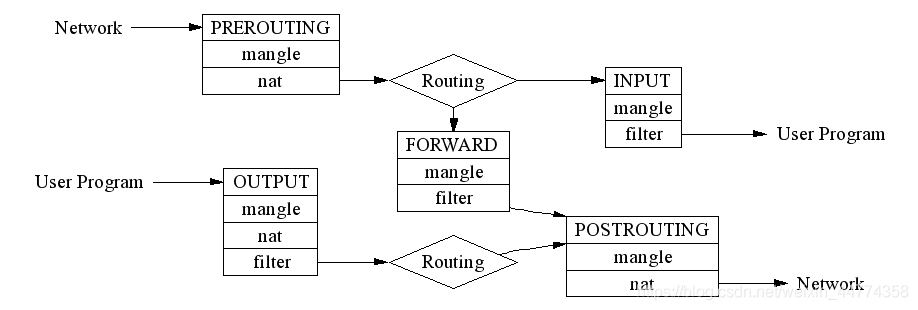
需要注意的是,routing和forwarding很大程度上增加了以上netfilter的复杂程度,如果我们不考虑routing和forwarding,那么netfilter会变得更我们的水质过滤器框架一样简单。
节点网络大图
现在我们看一下K8S集群节点的网络全貌。横向来看,节点上的网络环境,被分割成不同的网络命名空间,包括主机网络命名空间和Pod网络命名空间;纵向来看,每个网络命名空间包括完整的网络栈,从应用到协议栈,再到网络设备。
在网络设备这一层,我们通过cni0虚拟网桥,组建出系统内部的一个虚拟局域网。Pod网络通过veth对连接到这个虚拟局域网内。cni0虚拟局域网通过主机路由以及网口eth0与外部通信。
在网络协议栈这一层,我们可以通过编程netfilter过滤器框架,来实现集群节点的反向代理。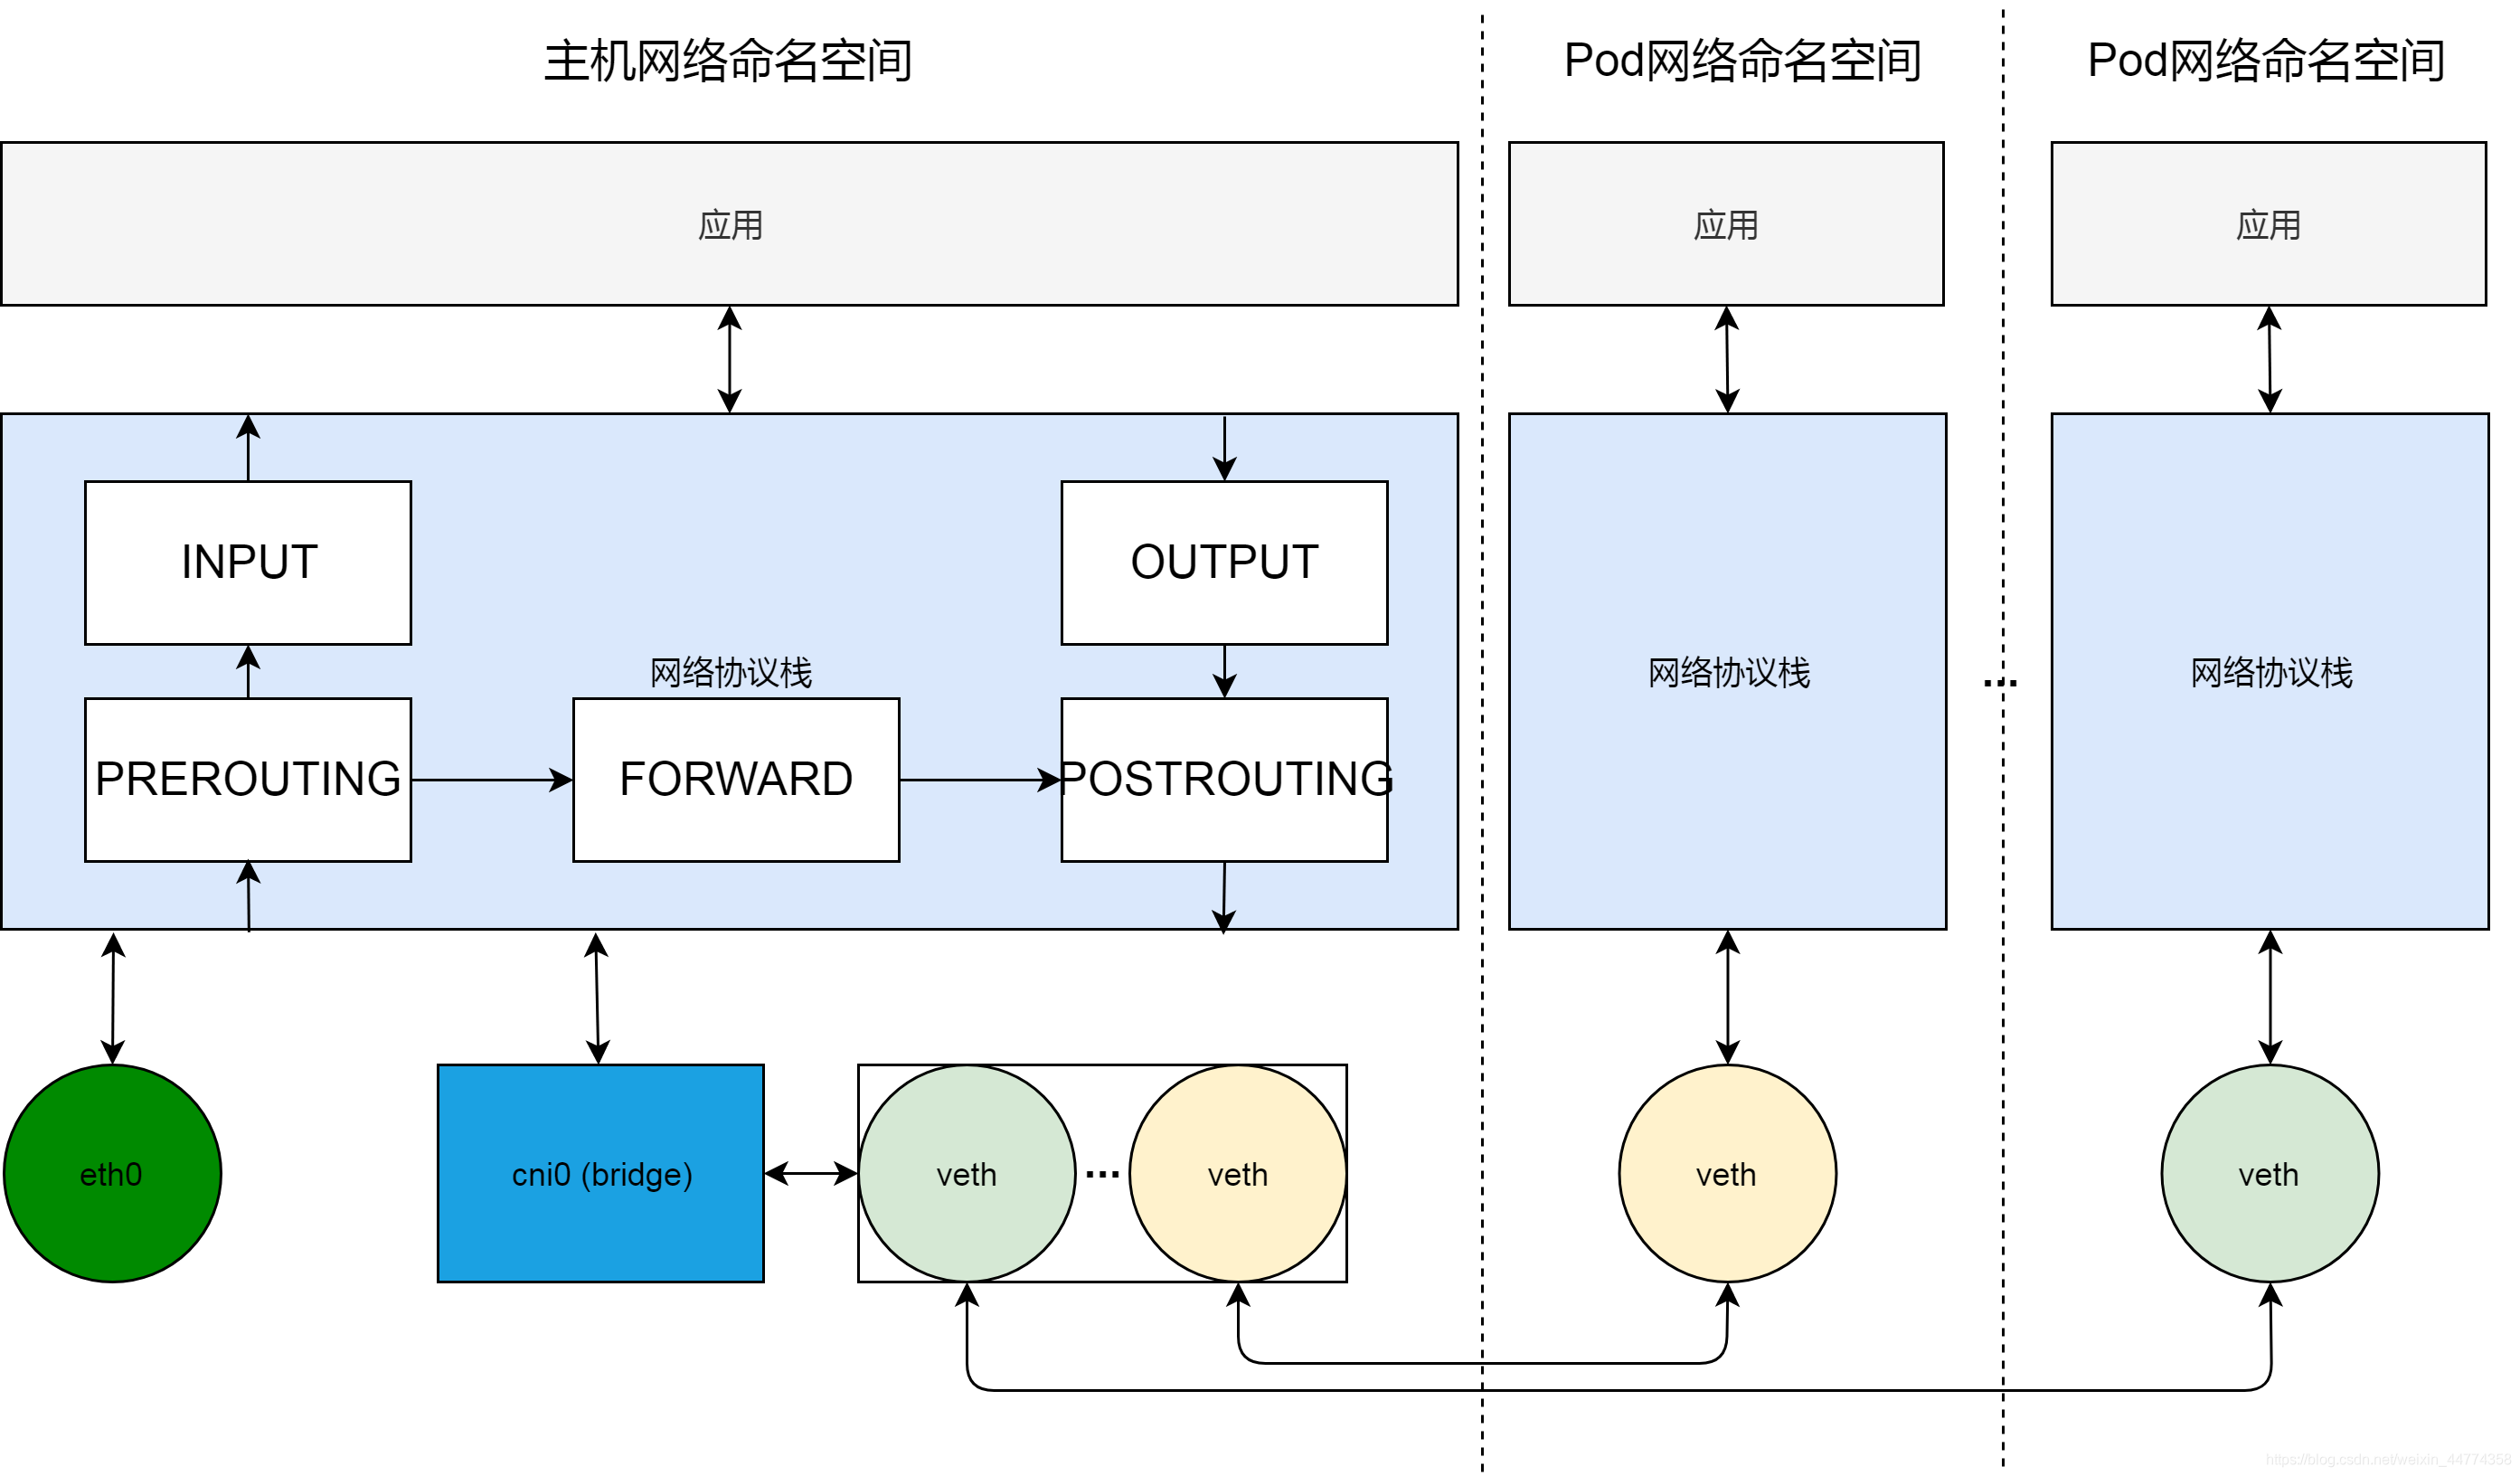
实现反向代理,归根结底,就是做DNAT,即把发送给集群服务IP和端口的数据包,修改成发给具体容器组的IP和端口。
参考netfilter过滤器框架的图,我们知道,在netfilter里,可以通过在PREROUTING,OUTPUT以及POSTROUGING三个位置加入NAT规则,来改变数据包的源地址或目的地址。
因为这里需要做的是DNAT,即改变目的地址,这样的修改,必须在路由(ROUTING)之前发生以保证数据包可以被路由正确处理,所以实现反向代理的规则,需要被加到PREROUTING和OUTPUT两个位置。
其中,PREOURTING的规则,用来处理从Pod访问服务的流量。数据包从Pod网络veth发送到cni0之后,进入主机协议栈,首先会经过netfilter PREROUTING来做处理,所以发给服务的数据包,会在这个位置做DNAT。经过DNAT处理之后,数据包的目的地址变成另外一个Pod的地址,从而经过主机路由,转发到eth0,发送给正确的集群节点。
而添加在OUTPUT这个位置的DNAT规则,则用来处理从主机网络发给服务的数据包,原理也是类似,即经过路由之前,修改目的地址,以方便路由转发。
升级过滤器框架
在过滤器框架一节,我们看到netfilter是一个过滤器框架。netfilter在数据“管到”上切了5个口,分别在这5个口上,做一些数据包处理工作。虽然固定切口位置以及网络包处理方式分类已经极大的优化了过滤器框架,但是有一个关键的问题,就是我们还是得在管道上做修改以满足新的功能。换句话说,这个框架没有做到管道和过滤功能两者的彻底解耦。
为了实现管道和过滤功能两者的解耦,netfilter用了表这个概念。表就是netfilter的过滤中心,其核心功能是过滤方式的分类(表),以及每种过滤方式中,过滤规则的组织(链)。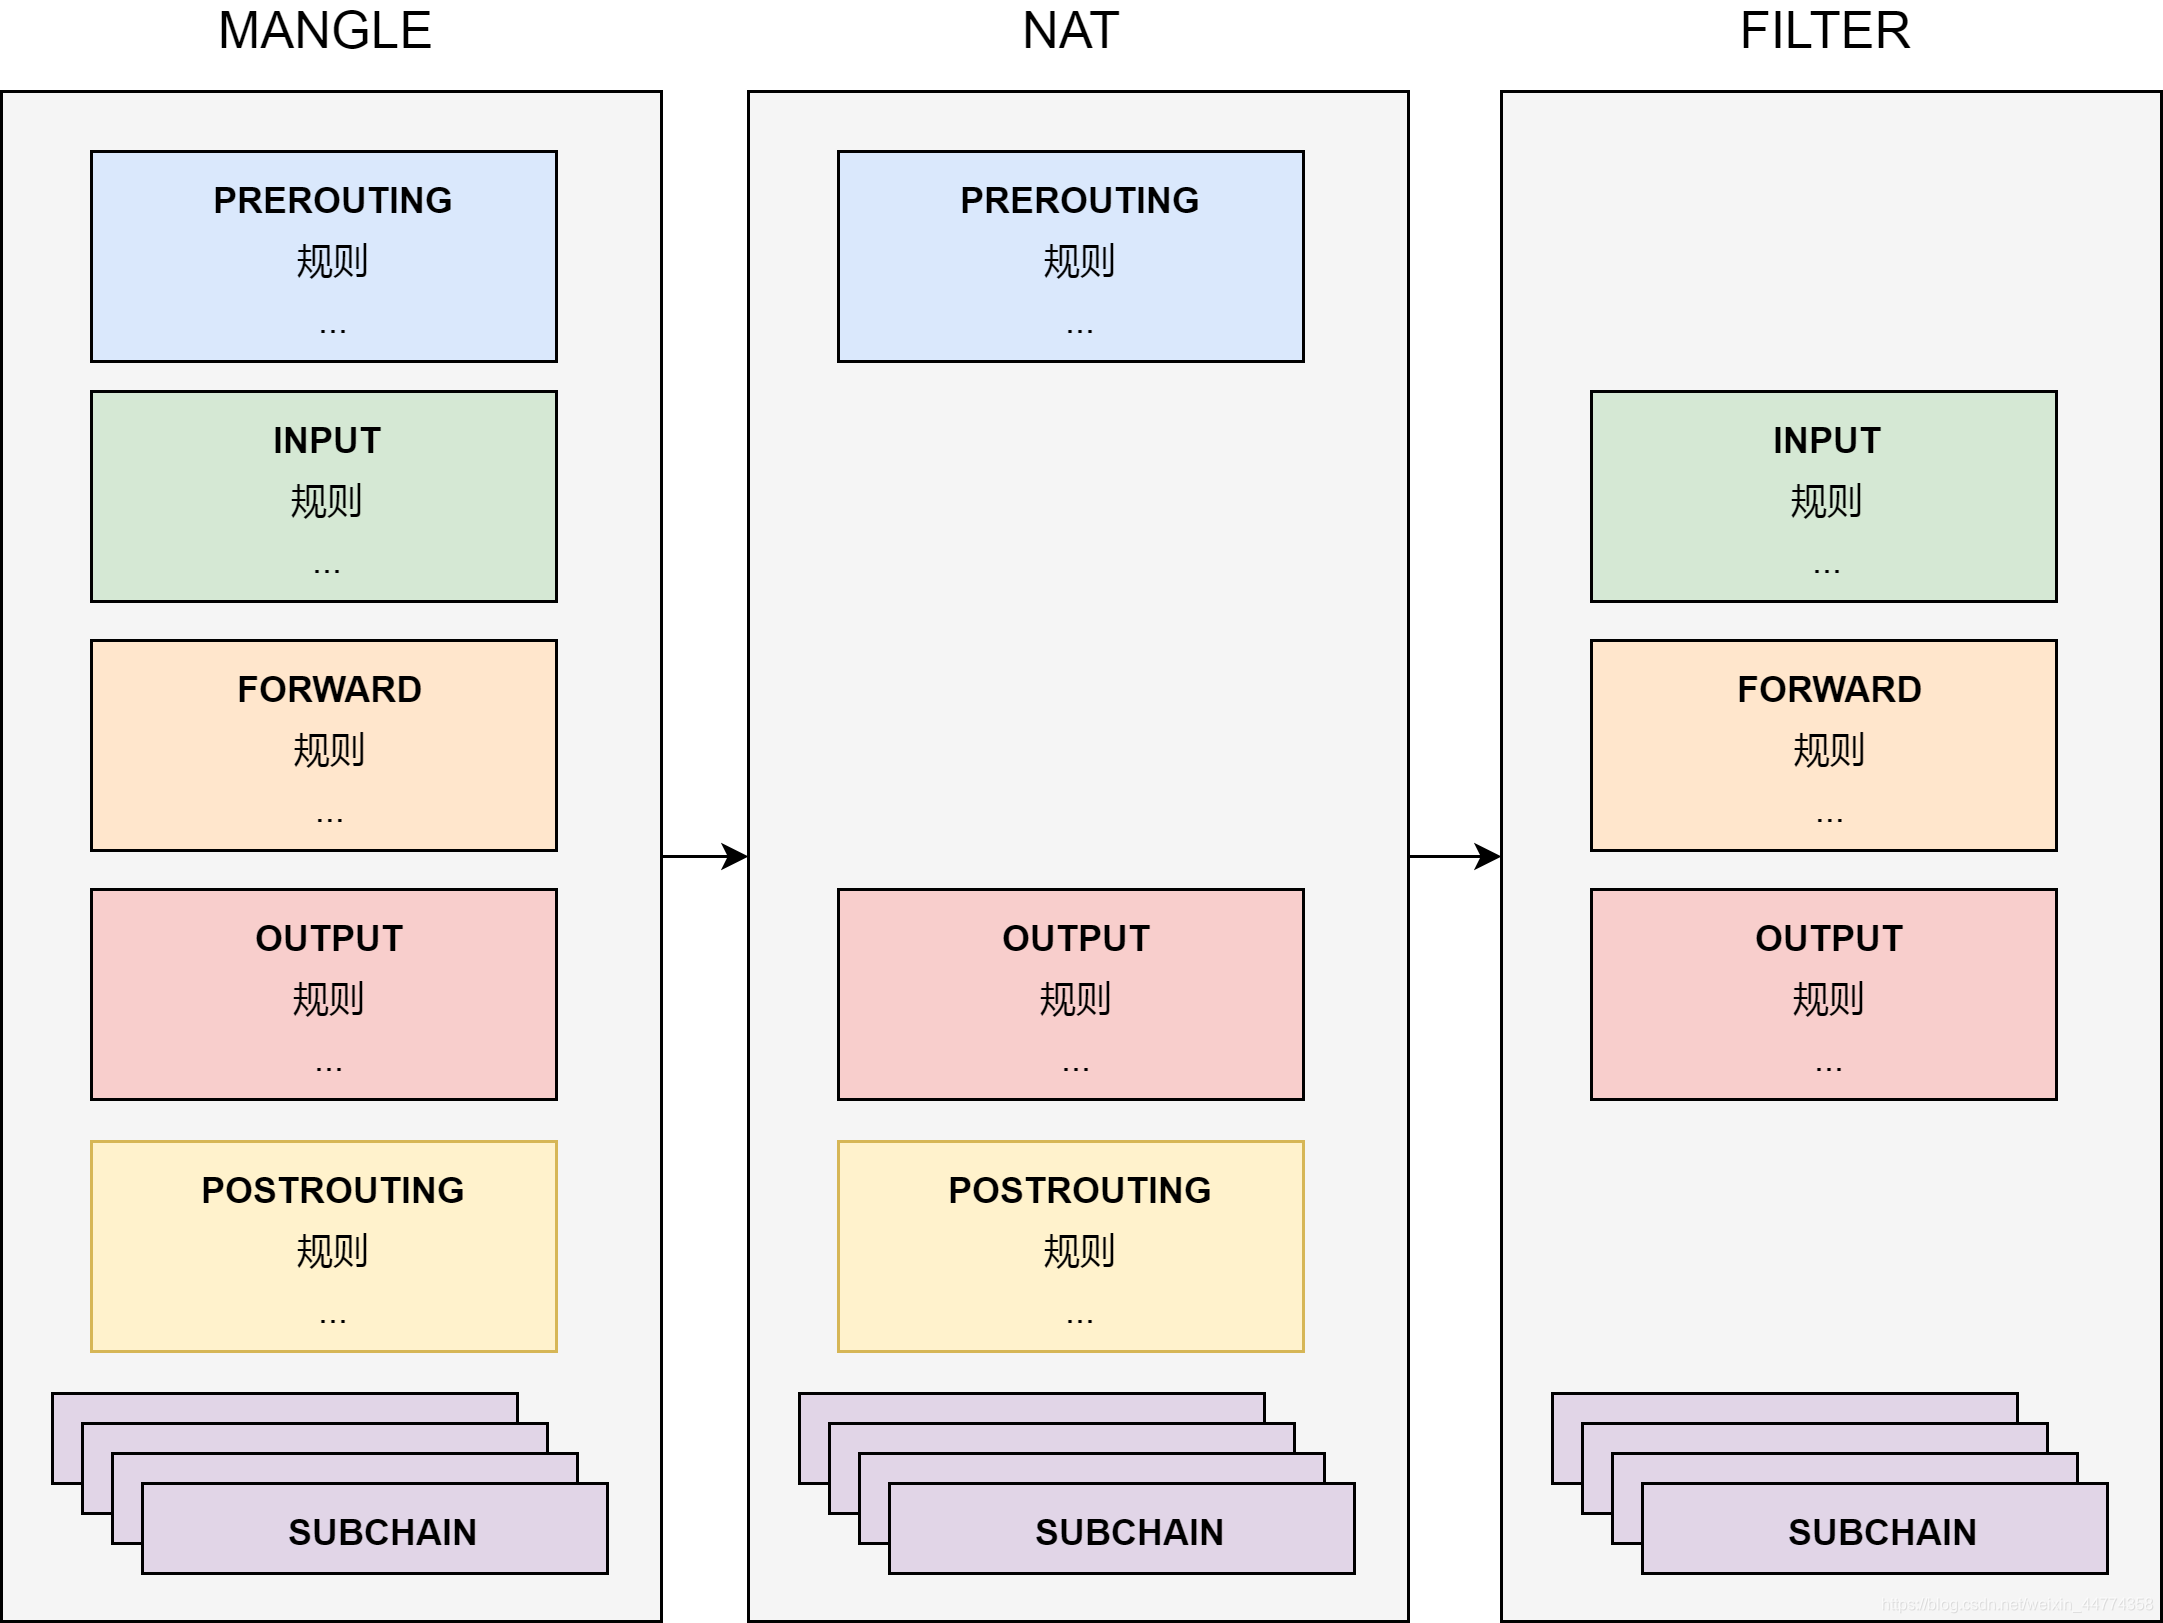
把过滤功能和管道解耦之后,所有对数据包的处理,都变成了对表的配置。而管道上的5个切口,仅仅变成了流量的出入口,负责把流量发送到过滤中心,并把处理之后的流量沿着管道继续传送下去。
如上图,在表中,netfilter把规则组织成为链。表中有针对每个管道切口的默认链,也有我们自己加入的自定义链。默认链是数据的入口,默认链可以通过跳转到自定义链来完成一些复杂的功能。这里允许增加自定义链的好处是显然的。为了完成一个复杂过滤功能,比如实现K8S集群节点的反向代理,我们可以使用自定义链来模块化我们规则。
用自定义链实现服务的反向代理
集群服务的反向代理,实际上就是利用自定义链,模块化地实现了数据包的DNAT转换。KUBE-SERVICE是整个反向代理的入口链,其对应所有服务的总入口;KUBE-SVC-XXXX链是具体某一个服务的入口链,KUBE-SERVICE链会根据服务IP,跳转到具体服务的KUBE-SVC-XXXX链;而KUBE-SEP-XXXX链代表着某一个具体Pod的地址和端口,即endpoint,具体服务链KUBE-SVC-XXXX会以一定算法(一般是随机),跳转到endpoint链。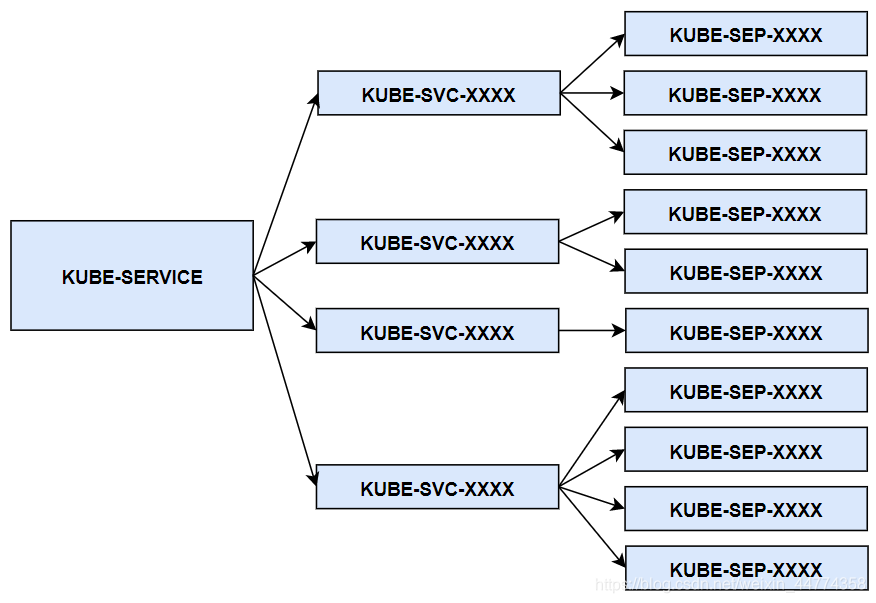
而如前文中提到的,因为这里需要做的是DNAT,即改变目的地址,这样的修改,必须在路由之前发生以保证数据包可以被路由正确处理。所以KUBE-SERVICE会被PREROUTING和OUTPUT两个默认链所调用。
总结
通过这篇文章,大家应该对K8S集群服务的概念以及实现,有了更深层次的认识。我们基本上需要把握三个要点。一、服务本质上是负载均衡;二、服务负载均衡的实现采用了与服务网格类似的Sidecar的模式,而不是LVS类型的独占模式;三、kube-proxy本质上是一个集群控制器。除此之外,我们思考了过滤器框架的设计,并在此基础上,理解使用iptables实现的服务负载均衡的原理。