阿里云PB级实时数仓AnalyticDB通用解决方案解析
摘要:大数据上云特惠活动系列直播,阿里巴巴技术部悦畅对PB级实时数仓AnalyticDB通用解决方案进行解析。分析型数据库(AnalyticDB)是由阿里巴巴自主研发的海量数据实时高并发在线分析(Realtime OLAP)云计算服务,可以在毫秒级针对千亿级数据进行及时的多维分析透视和业务探索。悦畅主要通过产品简介、客户需求与挑战、解决方案、性能比对、价值总结五个部分进行分享。
数十款阿里云产品限时折扣中,赶快点击这里,领券开始云上实践吧
[直播视频请点击]
下载PPT请点击
以下是精彩视频内容整理:
AnalyticDB简介
分析型数据库(AnalyticDB), 是阿里巴巴自主研发的海量数据实时高并发在线分析(Realtime OLAP)云计算服务,可以在毫秒级针对千亿级数据进行及时的多维分析透视和业务探索。具备海量数据的自由计算和响应计算能力,能让用户在瞬息之间进行灵活的数据探索,快速的发现数据价值,并可直接嵌入业务系统为终端客户提供分析服务。
分析型数据库的特点:
- 全面的值索引和块索引技术
全面的MySQL协议兼容和SQL2003兼容能力
超大规模的MPP+DAG融合引擎
智能的CBO/HBO优化器技术
多版本的行列混存技术
互联网级别分布式高可用与低延迟机制
AnalyticDB架构主要包括应用层、分析型数据库、数据互通、辅助系统和联邦计算。
需求和挑战
客户的计算层主要包括应用层、计算层、数据采集和数据源。计算层采用了Impala+Druid。Impala是架构的查询引擎,底层使用的是HDSS作为存储引擎,但是底层的存储引擎只对文件进行均衡,不对单张表的数据进行均衡,导致单张表数据存储倾斜。当前的实时写入使用的Druid,Druid适合过滤条件比较多的查询分析,Druid可以进行海量数据的实时写入。当前计算层存在实时性差、查询局限、扩展性差和运维难问题。
客户的业务特点:
- 广告运营分析平台,主要提供容量、曝光、收入和点击等指标,在广告位、终端类型等各个维度下的统计分析。
- 要针对历史数据的交互式查询和实时数据的统计分析。
- 数据量增长非常的快,需要提供毫秒级响应能力。
解决方案
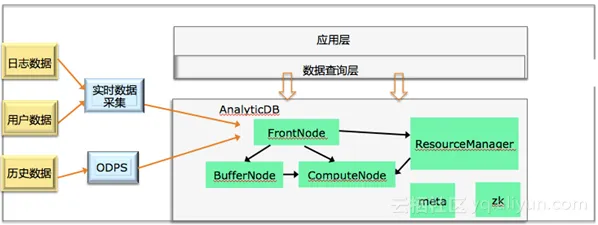
新的架构如上图所示,上图中的Impala+Druid完全可以由AnalyticDB来代替,开发者只需要学习一个AnalyticDB就可以实现以上Impala+Druid的全部功能,而且节省了链路,用户的查询速度非常的快。由上图知用户的历史数据直接从ODPS中抽取然后导入到AnalyticDB中,用户数据和日志数据通过实时的数据采集导入到AnalyticDB中。同时用户可以将更多的细粒度的数据存入ADS中实时计算粗粒度的报表数据,减少数据表和数据源的数量,使得业务可以将原有外置的统一数据查询层简介后内置在Web业务系统中。
db类型和表设计
db类型和表的设计非常的重要,如果按照一定的规范把表设计好后续的很多问题变得非常的简单。一般建议客户购买两种类型db。一种是大存储的,成本低,存储数据量大,其缺点是查询速度慢。另一种是高性能的,成本相对较高,换来的是速度快。大存储是高性能的一种备份,当高性能出问题时,可以路由到大存储,主要的存储还是在高性能里。表的设计,表按属性划分,可以分成实时表和维度表。根据表的实时性划分可以分为事实表和批量表,历史数据是从ODPS上批量导入到AnalyticDB,实时数据支持秒级延迟,数据是实时的导入到AnalyticDB。AnalyticDB支持字段的二级分区,一般选择时间字段作为二级分区。有时候业务存在多个维度,每次选择查询的时候只选择一个值,可以选择此字段进行分表,减小表的行数加快查询的速度。上面讲述了横向分表,如果建立Rollup则是必须纵向分表。我们从分区剪裁、多值列支持的关键词关联功能和高性能维度聚合函数进行性能的优化。
分区裁剪
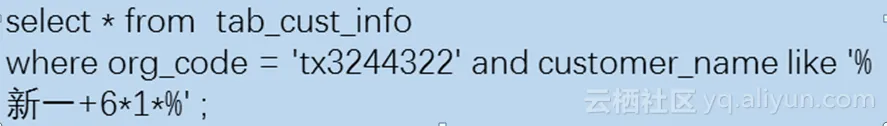
SQL语句1如上图所示是模糊查询,查询的性能非常的慢,性能需要优化,耗时在15-20s之间。
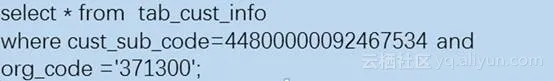
SQL语句2,耗时约为20-50ms。
我们主要是从建表语句、分区列、聚集列选择和模糊查询下的分区裁剪进行优化。前三个分别对表结构进行调整,一级分区进行更换,从上面的语句我们知道一级分区数是256个,256个一级分区列太多,然后改成64个进行优化,增加了聚集列。当前三点改完后,不进行模糊查询,发现跑完只需要0.67秒。所以模糊查询耗费了大量的时间,我们对模糊查询进行分区裁剪。当第四个优化完成后只需0.27-0.5秒就可以跑完。
多值列支持的关键词关联功能
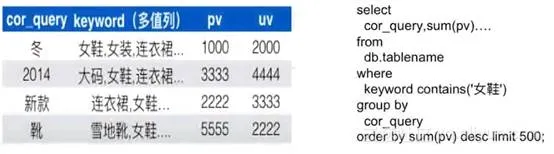
多值列支持的关键词关联功能的一个例子如上图所示,当我们查询2014连衣裙是PV、UV的数量基础上想继续查询女鞋,传统的方法是再增加一个表,然后把两张表进行Druid,这样做非常的麻烦。现在给出的方案是用户不用在进行建表,只需在原有表的基础上增加一列,也就叫做多值列。只需要在where里添加keyword contains(‘女鞋’),就可以实现这个功能。
性能比对
从入库数据可见性、查询平均时间和可承载的并发量进行比对。
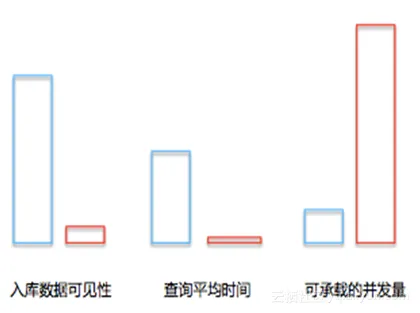
如上图所示,蓝色代表使用AnalyticDB之前,红色代表使用AnalyticDB之后。从数据上看,日增实时数据约1T,数据可见性由分钟级别上升到秒级可见,入库数据可见性提升了60倍;查询时间由1min降低到300ms以内,查询平均时间提升200倍;并发量由10并发提升到1000以上,并发量提升了100倍;数据总量达到5T,还在持续的增加中。
价值总结
助力用户上云,完全释放数据价值。在这之前用户用自建的数据库,运维非常复杂。如果是开源的,当社区发生变化时,客户需要自己进行运维,需要耗费大量的人力物力进行研究。用户上云后,无需用户运维,支持平滑的升级,不需要客户停服,用户是无感知的,可以在升级的过程中进行查询;客户无需忍受分析耗时时间长,用户上云后是毫秒级返回,且并发能力提升百倍;扩展性能强,支持弹性扩缩容,当客户的数据量变大时,可以后续进行购买扩容,无需为后续数据装载不下而担心,当用户数据量变少时还可以进行缩容;用户不仅要考虑时间成本,同时也需要考虑金钱成本。用户上云后降低了70%的成本,云上五种资源类型,都提供了最高性价比。