10月16日云栖精选夜读:阿里云ApsaraCache的正式开源 中国科技再次回馈世界

简介: 10月14日,在2017杭州·云栖大会上,阿里云宣布飞天缓存ApsaraCache项目正式开源,Redis创始人Salvatore见证了这一时刻,这是中国科技力量贡献世界的又一个里程碑。 ApsaraCache是在社区 2.8 版本基础上开始维护的分支,并 backport 了部分 3.0 分支的功能。

10月14日,在2017杭州·云栖大会上,阿里云宣布飞天缓存ApsaraCache项目正式开源,Redis创始人Salvatore见证了这一时刻,这是中国科技力量贡献世界的又一个里程碑。 ApsaraCache是在社区 2.8 版本基础上开始维护的分支,并 backport 了部分 3.0 分支的功能。


热点热议

阿里云ApsaraCache的正式开源 中国科技再次回馈世界

作者:云攻略小攻

【云栖大会】阿里云移动云Apsara Mobile重磅发布 推出Cloud Native App全新研发范式

作者:yunqi_share  发表在:云栖大会

阿里云启动异构与高性能计算生态共建与DLI课程

作者:云上未来  发表在:虚拟化平台


知识整理

Mysql group replication复制原理

作者:白海生

MySQL 数据恢复方法(二)

作者:knightzxh

使用Cobbler批量安装操作系统

作者:xiaoshuaigege

centos7.3实现基于源码编译安装LAMP的wordpress应用

作者:xiaoshuaigege

Mysql group replication复制原理

作者:白海生


美文回顾

【云栖大会】让人敬佩的白发程序员 MySQL之父Monty 的云栖之旅

作者:yunqi_share  发表在:云栖大会

云栖大会移动安全专场——APP加固新方向(演讲速记)

作者:聚安全平台

前端工程师做事的三重境界:我的进阶之路

作者:茶花盛开

我们采访了阿里云云数据库SQL Server的产品经理,他说了解这四个问题就可以了

作者:云攻略小攻  发表在:云攻略 >> 新闻资讯

【云栖大会】阿里云生态 开启智能“大航海时代”

作者:云攻略小攻  发表在:云攻略 >> 新闻资讯

弹性与性能兼俱,阿里云神龙云服务器全解析

作者:云攻略小攻  发表在:云攻略 >> 新闻资讯

1秒10亿数据!阿里云日志服务再次升级

作者:云攻略小攻  发表在:云攻略 >> 新闻资讯


往期精选回顾

目录
相关文章
|
算法 安全 Linux
Linux粘滞位(Sticky Bit)与文件权限的深度解析
853 0
|
10月前
|
算法 数据处理 异构计算
南京观海微电子----Verilog流水线设计——Pipeline
本文介绍FPGA设计中提升数据处理效率的流水线(Pipeline)技术。针对传统复制电路资源消耗大的问题,Pipeline通过将操作分解为时序均衡的多级处理段,实现数据并行处理,显著提高吞吐率与系统时钟频率,兼顾资源利用率与处理速度,适用于高速、大型FPGA系统设计。
南京观海微电子----Verilog流水线设计——Pipeline
|
7月前
|
人工智能 安全 Linux
90分钟挖出20年Linux漏洞,Claude 5.0内测曝光:软件工程正在被重写
Claude 5.0(Mythos)内测标志开发范式革命:从“人写代码”迈向“人调度AI”。它具备系统级漏洞挖掘、自主安全研究、多智能体协同等能力,推动工程师转型为任务拆解者与智能体调度者。AI不是替代,而是重构角色——人类专注定义问题与掌控系统。
|
8月前
|
SQL 安全 测试技术
Python字符串拼接全攻略:从基础到进阶的6种方法
本文详解Python字符串拼接6种方法(+、join、f-string、format、%、Template及bytearray),通过性能测试对比与场景分析,揭示效率差异:join最快,f-string兼顾格式化与性能,Template最安全,+号仅适合少量拼接。附最佳实践与避坑指南。(239字)
1003 2
|
10月前
|
缓存 Java Docker
【Docker实战】如何写出“性感”的Dockerfile?从1GB瘦身到100MB的秘籍
本文介绍如何编写高效、安全的Dockerfile,以Java和Python为例,分享四大核心技巧:多阶段构建减小镜像体积,利用缓存加速构建,选用轻量基础镜像,配置.dockerignore忽略无用文件。助你打造小巧、快速、安全的容器镜像,提升部署效率与安全性。
|
10月前
|
算法
模型压缩与量化
模型压缩通过量化、稀疏化、知识蒸馏等技术,减小模型体积与计算开销,助力大模型在端侧部署。涵盖INT8/INT4、GPTQ、SmoothQuant等方法,平衡压缩比、精度与速度,并支持实战量化加载,提升推理效率。
|
12月前
|
JSON 供应链 监控
批量获取1688商品数据,精准筛选与分页查询
1688商品列表API(alibaba.product.list.get)支持按关键词、类目、价格等条件批量获取商品信息,适用于B2B场景下的商品管理与竞品分析。返回JSON格式数据,含商品ID、标题、价格、库存等核心字段,支持分页查询、动态筛选与排序,实时性强,字段可定制。
|
运维 调度 数据安全/隐私保护
ERP系统开发中的技术难点与应对策略分析
开发ERP系统面临架构设计、数据整合、流程建模、性能优化与安全运维等多重挑战。本文详解五大技术难点及应对策略,涵盖微服务与单体架构平衡、数据迁移集成方案、流程引擎设计、高并发处理及权限控制等关键点,并提供实用技术栈建议与渐进式开发路线。
1112 0
|
人工智能 自然语言处理 算法
2025 年 7 月境内深度合成服务算法备案情况分析报告
2025年7月,中央网信办发布第十二批深度合成算法备案信息,全国389款产品通过备案,服务提供者占比超七成。截至7月14日,全国累计备案达3834款,覆盖文本、图像、音视频等多模态场景,广泛应用于生活服务、医疗、金融等领域。广东以135款居首,数字人、AI客服等C端应用主导,民营企业成主力,国企聚焦公共服务。随着AI政策推动,备案已成为AI产品合规上线关键环节。
|
机器学习/深度学习 自然语言处理 搜索推荐
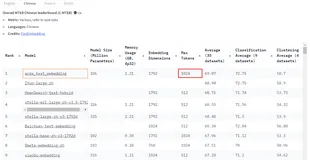
探索文本向量化的新高峰:合合信息acge_text_embedding 模型原创
文本向量化方法包括词袋模型、TF-IDF、词嵌入和预训练模型(如BERT、GPT)。词嵌入如Word2Vec、GloVe和FastText捕捉单词语义,预训练模型则保留上下文信息。C-MTEB是中文文本嵌入评估平台,测试模型在检索、相似性、分类等任务的性能。合合信息的acge_text_embedding模型在C-MTEB中表现优秀,适用于情感分析、文本生成等任务,具有高分类聚类准确性、资源效率和场景适应性。技术突破涉及数据集优化、模型训练策略和持续学习,提供Demo展示如何使用acge模型计算句子相似度。acge_text_embedding是提升文本处理效率和智能化的有力工具。
2173 2
探索文本向量化的新高峰:合合信息acge_text_embedding 模型原创

热门文章

最新文章