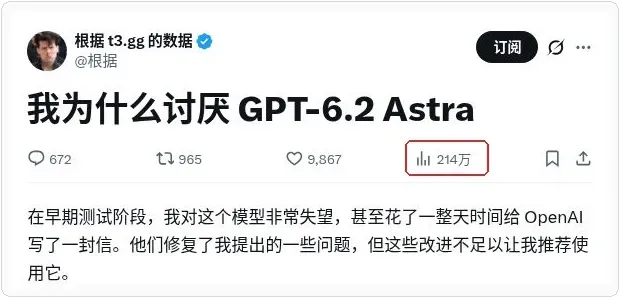
6.2上线两天了,刚上线那天,我就刷到一篇长文,标题叫《我为什么讨厌GPT-6.2 Astra》。
这篇吐槽已经有两百多万次阅读了。
作者是个开发者,他拿Astra写代码、查故障,还让它给《星际拓荒》做一个新关卡。
结果呢,你猜怎么着,Astra做了两个小时,关卡还没交,就停下来问作者了。
负责测试的AI跟你来提问了,把录像存成 24_g521.mp4,还是 24_p11.mp4?
不是,大**哥,这俩文件名**不是你AI自己定的吗?咋还问上我了?
我自己用了两天下来,也或多或少发生了很多次这样的情况,懂他为什么烦。
就像带团队的时候,别人一次次来问你一些细节问题,但是和你的管理工作并没有关联,很多时候,你并不知道细节。
你要做,就得重新全捋一遍,所以每次AI这样,都能给人搞炸。
可我接着刷到另一段演示,就有意思了。
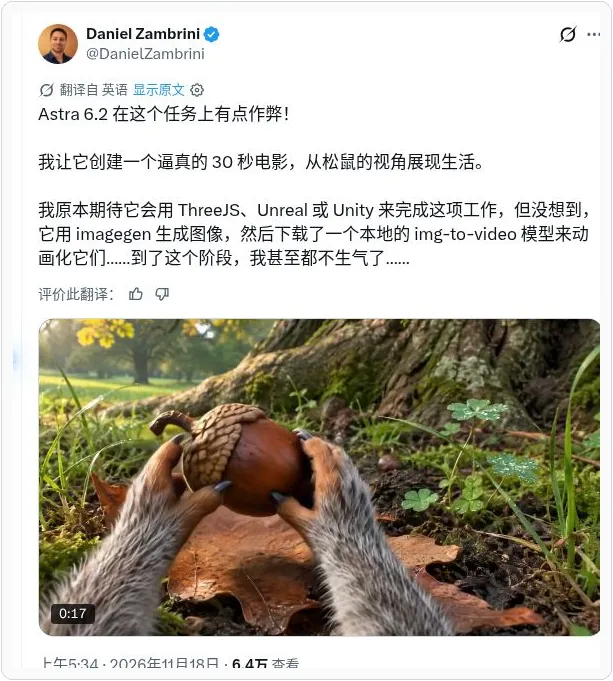
有人让Astra做一条松鼠短片,6.2本身不会生成视频,结果 Astra 先用 ImageGen 出图,又自己找了个能在本地跑的图生视频模型,把静态图做成了会动的镜头。
看到这儿,我就俩字:niubi。
同一个模型,做关卡的时候连个文件名都要问人,做短片的时候却能自己找到原本没有的工具。
我想知道,换成咱们自己的活,怎么能少碰上前一种?
我把那篇差评和自己用下来的感觉对了一遍,总结了四个问题,你可能也遇到过,今儿告你咋弄来适合我们这个新模型。
四个问题分别是:
第一,它讲得挺多,你还是不知道该干嘛,它很有可能给你讲一堆你看不懂的词汇。
第二,它自己能查的事,也停下来问你,做不完。
第三,你让它改一处,它把旁边的也改了。
第四,忙了半天,结果还不如原来。
我先讲这四件事怎么处理,再用几段实际演示看看,6.2到底强在哪儿,哪些活儿值得你换模型。
01|这四个问题,我会怎么处理
第一,它讲了一堆,我还是不知道该查哪儿
接上上面那个开发者还提到的一个具象的问题。
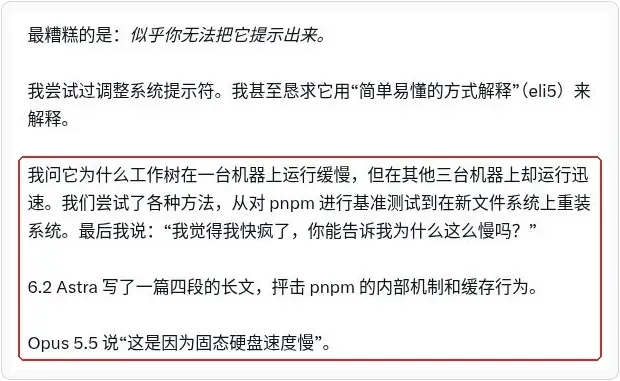
他说同一个代码项目,要在四台电脑上各开一份独立的工作目录,其中一台特别慢。
他问Astra该查哪儿,Astra却给他讲了四段缓存原理,简直就是一个不干人事。
后来他换了个opus5.5,对方给了一个能查的方向,看看那台电脑的固态硬盘读写是不是比其他几台慢。
这里有两种烦法:
一是那些词我们普通人压根儿没听懂。
二是我都听懂了,还是不知道该查哪儿。
词太难,OpenAI的Codex负责人Tibo给了解决方案,就是我们的初代提示词。
ELI5,就是先按五岁小孩能听懂的方式讲。
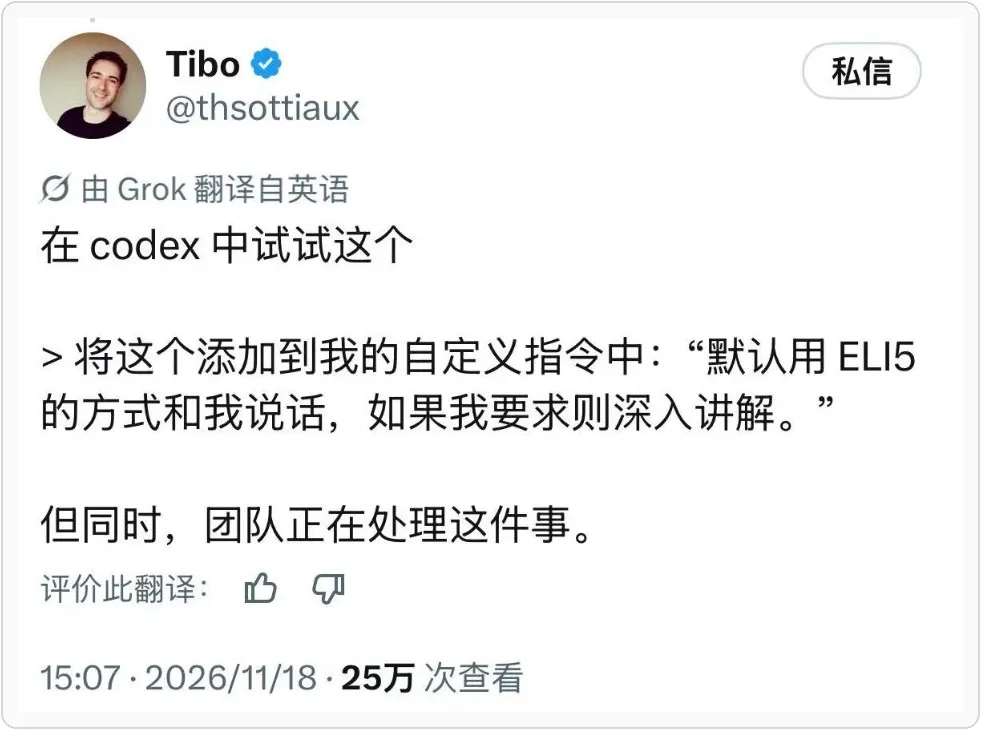
老金把他转成我们中文的形式,下面这条可以放进自定义指令,也可以直接接在问题后面:
先用一句大白话把我问的事说清楚,再举个生活里的例子。先按五岁小孩也能听懂的方式讲,我追问了再讲原理和细节。
比如他这个事儿,如果是我处理,我会把日志贴上,先让它只给我一个排查动作,比如拿同一个项目在两台机器上跑一次,看看慢的那台是不是一直在等硬盘读写。
比如这样说:
看我贴的日志,告诉我先查哪一项、怎么查。不同的结果会说明什么?已经能确定的,直接说。
第二,它自己能查的事,也停下来问你
还是上面这个事儿,AI 应该可以自己去查找,不应该来问我们人类。
因为这个事儿本来就是它自己在负责的。
除了我作为人类要判断的内容以外,我根本不想回答其他任何事情。
比如做PPT也是一样,拿去教同事上手,和拿去让老板在两个方案里拍板,头一页根本不是一回事。
谁来看、看完要做什么,我可以告诉它,至于怎么排,它应该自己搞定。
OpenAI的提示词指南里也提到了:咱们已经说好让它做的事,能做完就接着做。
你要的是PPT,它不能交一张“如何做PPT”的待办清单就收工。
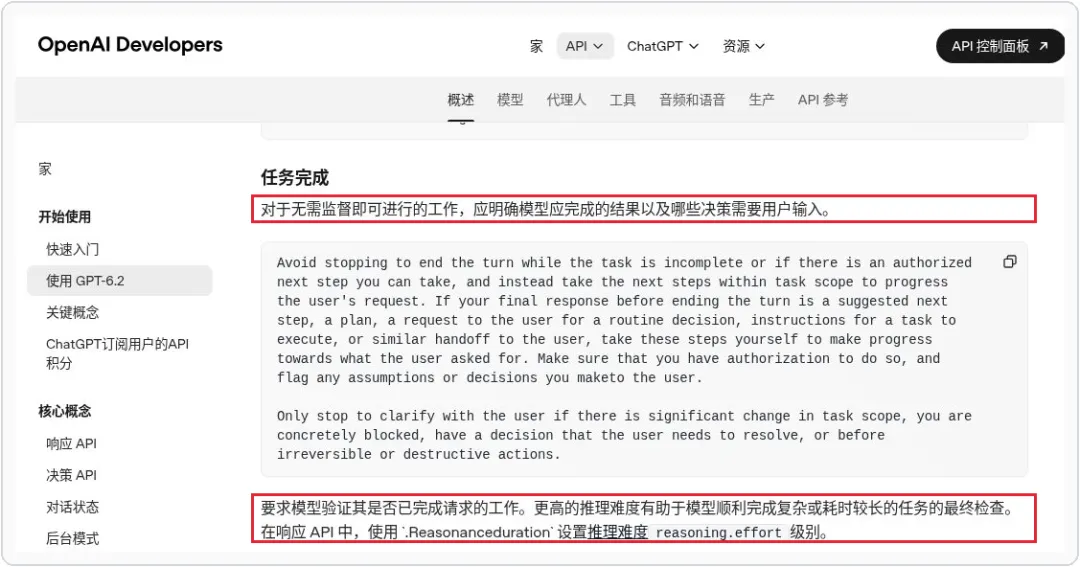
比如咱可以这样说:
用附件做一份给老板看的PPT,让他能从两个方案里选一个。
交可编辑的 .pptx,交前打开检查。
缺资料先查附件,查不到再告诉我缺什么。
第三,我只想改一处,它顺手把别的也改了
还有这种情况,假设网页都上线了,我就让它在底下加个报名区。
好家伙,刷新一看,配色换了,标题还发起了光。
我就想加个表单,谁让你给我重新装修了?
所以我会截图直接圈给它看,并且在旁边注释:表单加这儿,按钮照旁边那个做。
交的时候也别光截个图给我,我要它在测试环境提交一条报名,再打开后台看看收没收到。
只在标记处加报名区,沿用原来的字体和按钮,其他部分别动。交前在测试环境提交一条报名,确认后台收到记录。
可如果我要的就是一张全新的首页,那我会给它一张参考图,再说清楚图里哪部分我想借。
比如我喜欢它的颜色和留白,可不想把人家的菜单也搬到我的咖啡店里。
用附件里的文案做咖啡店首页,只参考示例图的配色和留白。交前用手机尺寸打开,看看文字和按钮有没有挤出屏幕。
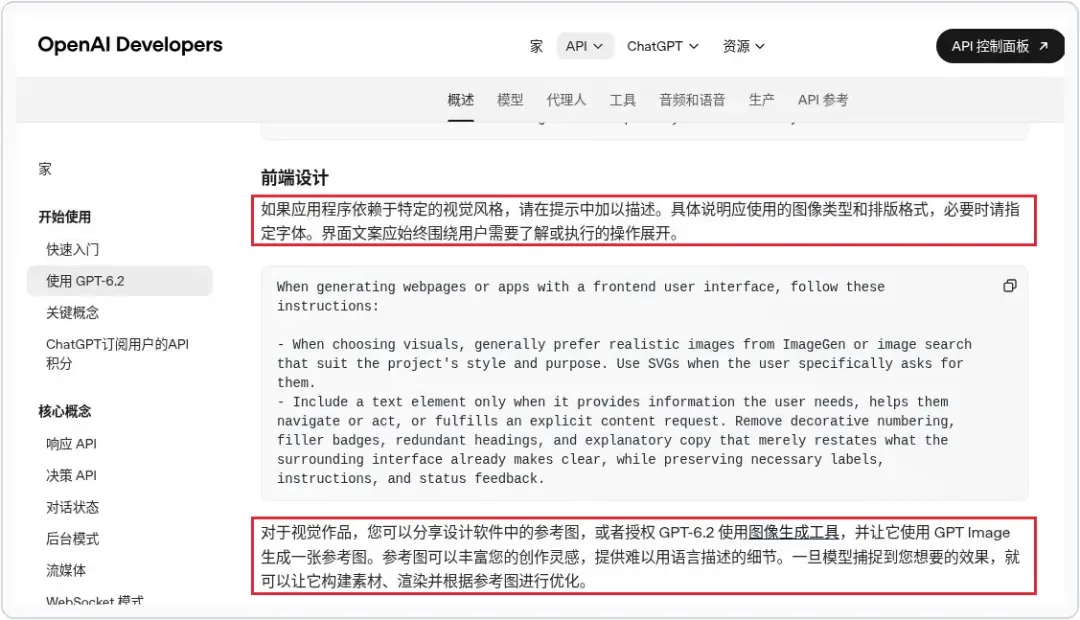
参考图还有个坑:你给它的照片可能只拍了木屋正面。要是你的意思是“我想走进去”,就得说清楚,门要能开,里面得有东西。
照参考图做一间能进出的三维木屋,补上背面和屋内。
交可打开试玩的工程,交前自己从门口进去再出来。
第四,它忙是挺忙,结果还不如原来
报名有没有成功,去后台查一条就知道,可你让AI把程序改快,原来跑几秒你都不知道,改完拿什么比?
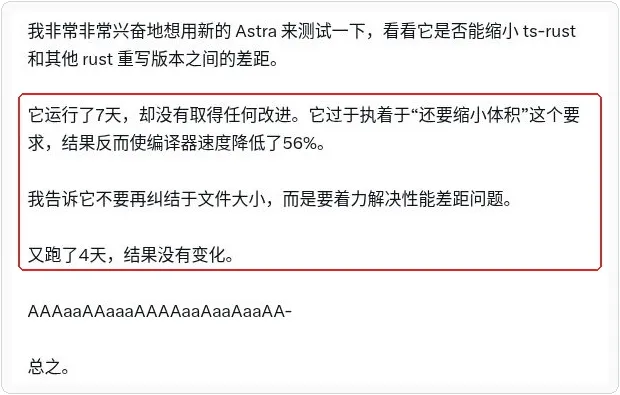
开头那位开发者就让Astra给一个编译器提速,顺带说最好能缩小体积。
结果Astra折腾了七天,按作者的说法,能用的改动一个没留下,试出来的版本反倒慢了56%。
作者索性说,体积先别管,就给我提速。又过了四天,还是没有可用的改动。
换我来,我会先用同一份输入,把原版多跑几次,记下耗时和输出。
每改一处就照原来的条件再跑几次,免得把电脑刚好没那么忙,当成了它的功劳。
要是跑快了,算出来的东西却变了,这个提速我不要。
如果是我,我会这么说:
用同一环境、同一份输入,各跑几次原版和改版,比较耗时和输出。
一次只改一处。
输出不对,或者没稳定变快,就撤回刚改的那一处。
试了几轮还没快,我宁可换个模型写,再让Astra来审。
那位开发者骂归骂,也认可它审代码的本事,别人漏掉的地方,它有时还真能挑出来。
上面这些话,不用全塞进规则文件。可是像“东西找不到,先告诉我缺什么”这句,我是真不想一遍遍说。
我用Codex的时候,每个项目都要守的规矩,就加到全局规则里。
像报名区要沿用原来的按钮,只管这个网站,我就写进这个项目的 AGENTS.md。
Windows和WSL到哪儿找文件、怎么合并旧规则,我在《集万家所长,一键复制的Agent.md!》里写过。
比如这样:
先查清Codex正在用哪份全局规则文件,再加上我选的这条。
重复的合并,其他规则保留。改完告诉我文件路径和改了哪句。
加完我会在项目目录新开一个Codex会话,问它:你读了哪些规则文件?我刚加的是哪一条?
先确认它读的正确,事情,我们要一步步来。
规则写了没用?看看 Codex 读的是哪份
如果Codex还是老样子,别急着重写。比如同一个目录里既有 AGENTS.md,又有 AGENTS.override.md,它会优先读带 override 的那份。
你刚才可能改的是它根本没看的文件。
我看到有人让Astra按官方手册查Codex配置,这招我觉得挺好。
把规则文件说明和6.2使用指南给它,像默认模型开得太重、同一条规矩写了三遍,就让它把文件和行号指出来。
我看完建议再决定怎么改。
直接让他去搜下官方指南和6.2使用手册就行:
搜一下官方指南和6.2的使用手册,对照这两份官方文档,
检查我现在生效的Codex配置、项目规则和默认模型。
每条建议标出本地文件和官方章节,只提必要的改动。
读不到就说明,先别改文件。
02|骂归骂,它哪儿确实变强了?
前面这四个问题,我最烦的还是活干到一半,又退回到我手上,对于我这种懒人来讲,最好就是一步到位,哪怕错了。
不过这不是个好习惯,因为在复杂项目中,很容易形成垃圾堆。
不好的说完了,我们来看看哪些是好的,我挑了几段能直接看见区别的。
先跟上一代比,看看水面和木屋
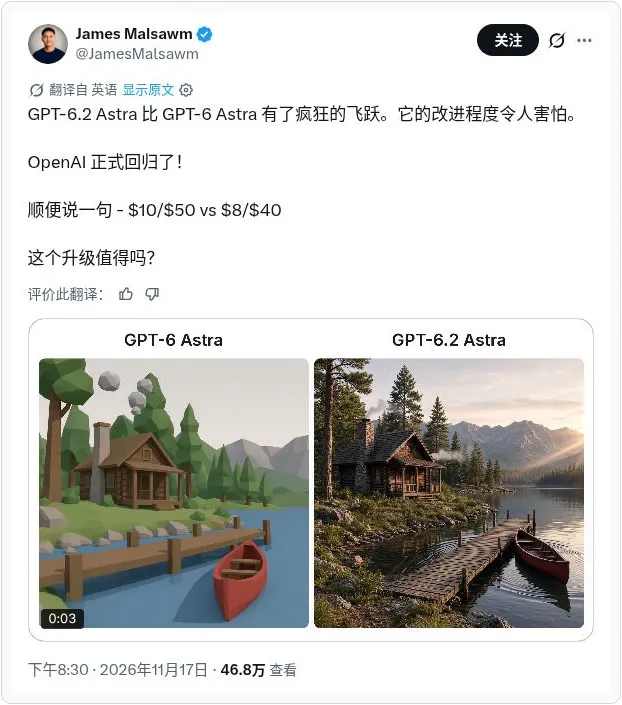
@JamesMalsawm 做了一组湖边木屋的对比。
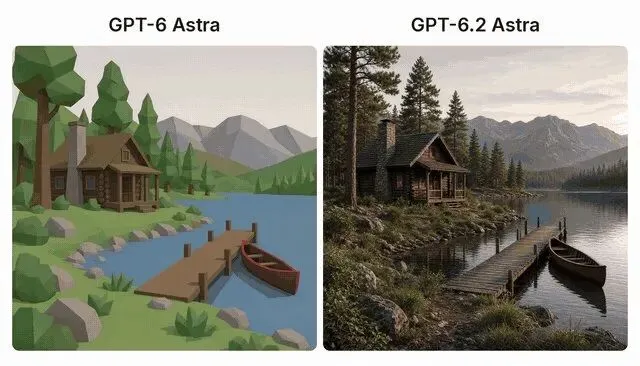
而且价格反而低了。
只看画面,和能走进去玩,是两回事
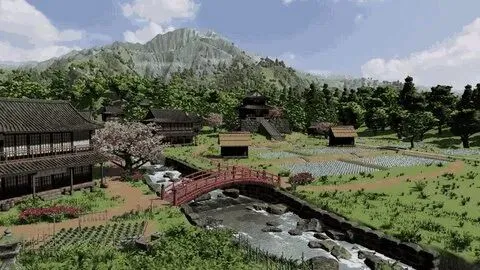
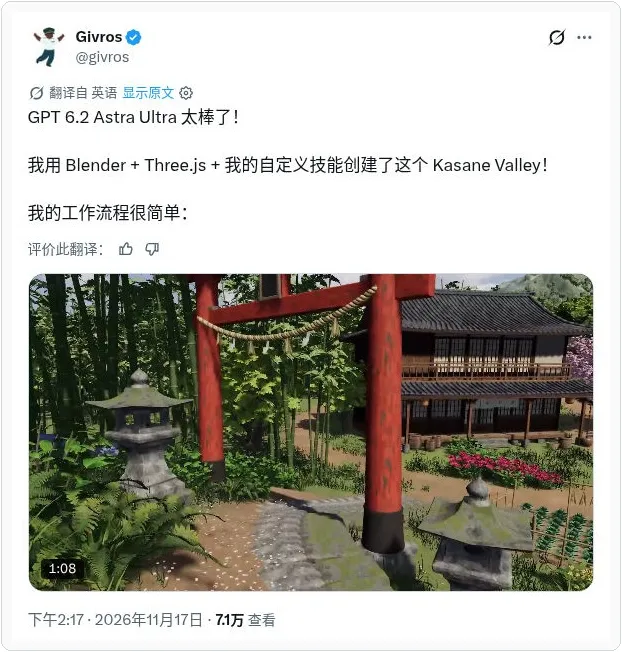
@givros 用Astra Ultra、Blender和Three.js做了个日式山村。
他先用ChatGPT出参考图、整理提示词,再交给自己的Skill,做出了一个3D复杂场景。
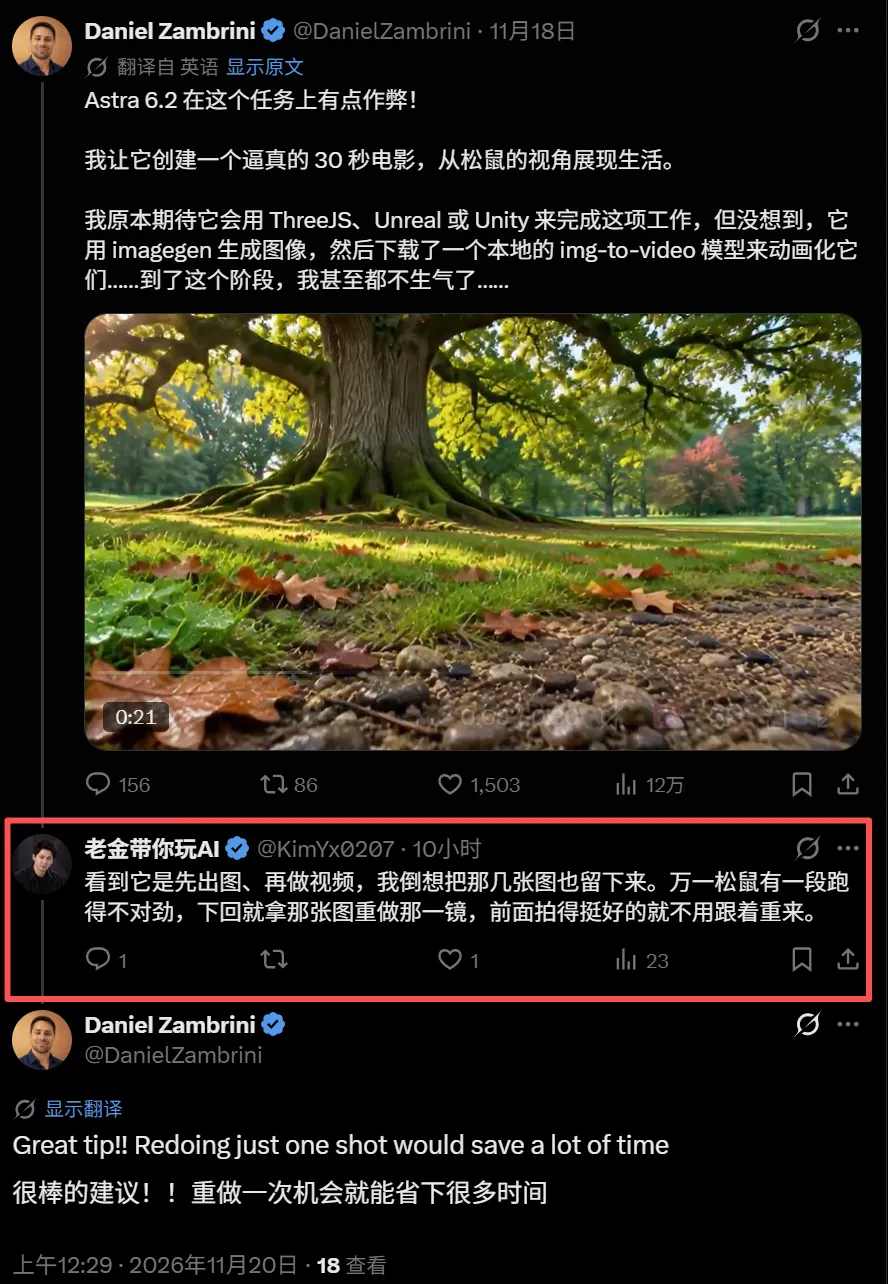
还有这个,@DanielZambrini 想要一条30秒的写实短片,镜头贴着地,从松鼠的视角穿过树林。
他本来以为Astra得用Three.js、Unity或者Unreal先搭场景,因为Astra本身不会生成视频。
结果它先让ImageGen出静态图,又自己去Hugging Face下了个能在本地跑的图生视频模型 LTX-Video 2B v0.9.8 distilled,把静态图做成了会动的镜头。
作者本来觉得它钻了空子,看到效果之后,他说自己已经不生气了。。
跟别家旗舰比,我还得看看花了多少钱
好看归好看,价格是咱最在意的。
@EnvolDev 拿同一句提示词,让6.2 Sol、6.2 Astra、Claude Fable 5.2和Opus 5.5各做了一架水上飞机。
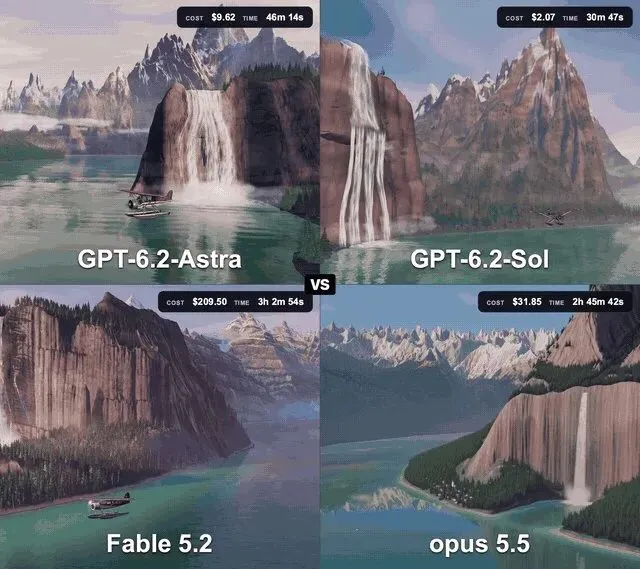
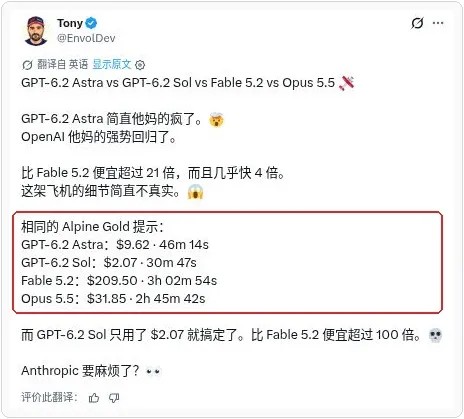
做这架飞机,Astra花的钱不到Fable 5.2的二十分之一。。惊了!
写在最后
所以,整篇文章大家可能看到了这个细节,那个做法,亦或者对比起来那个模型更强。
其实6.2更厉害了,而且厉害了很多,只是它不会说人话了,就跟老金前两天6.2刚上线时候的那个文章一样。
可能需要给它做个翻译器。
但老金在本篇里其实翻来覆去在讲一件事,流程。
不论是它说不了人话,还是不能接续任务,还有乱改,以及做的不好,其实都是没有管理好流程,进一步来讲,是每个流程的规则规范根本就没讲清楚。
就比如,松鼠视频这个作者回复我的,是我改了一个流程。
昨儿在我群里还有兄弟在说,在这个时代已经不需要在提示词里说角色这种写法了,这其实我看过很多次这种说法了。
我说不是,因为大家不知道的还是这个流程。
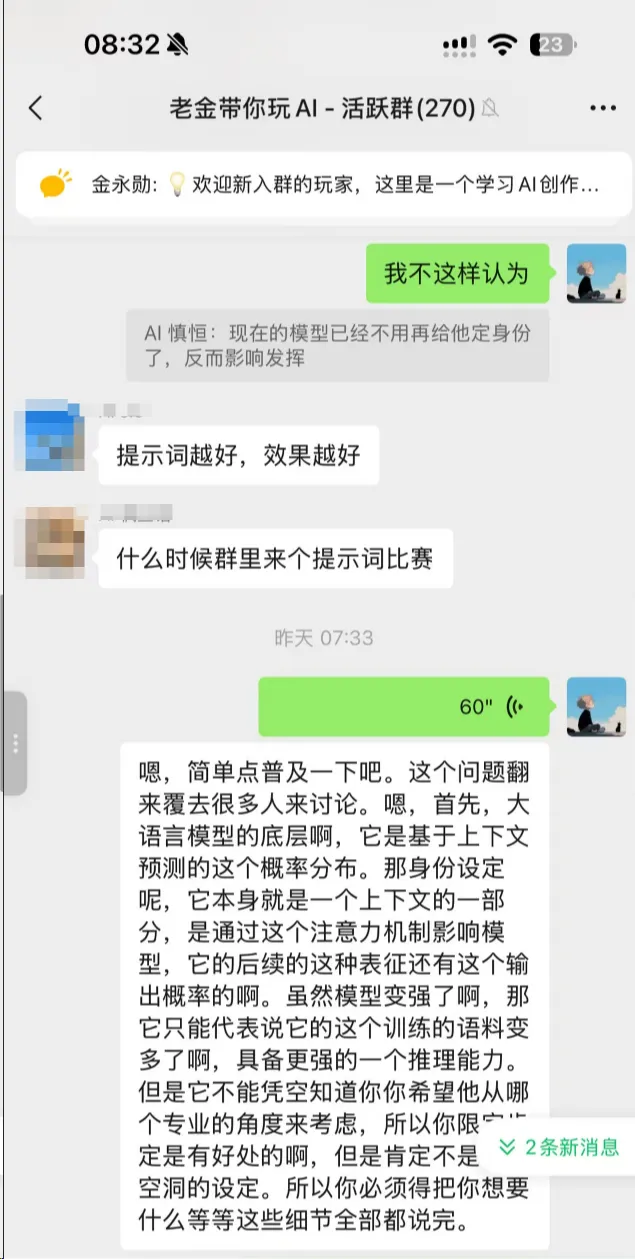
首先,大语言模型的底层啊,它是基于上下文预测的概率分布。
那身份设定呢,它本身就是一个上下文的一部分,是通过注意力机制影响模型、后续的这种表征,还有这个输出概率的。
虽然模型变强了,那只能代表说它的训练的语料变多了,以及训练带来的更强的推理能力。
但是它不能凭空知道你希望他从哪个专业的角度来考虑,所以你限定肯定是有好处的,但肯定不是只有一个空洞只有角色的设定。
所以你必须得把你想要什么等等这些细节全部都说完。
提示词,进一步说是上下文,依旧是人类和AI沟通的唯一桥梁。
下课!
谢谢你读我的文章。
如果觉得不错,随手点个赞、在看、转发三连吧🙂
如果想第一时间收到推送,也可以给我个星标⭐~谢谢你看我的文章。
开源知识库(实时更新 交流群):
https://my.feishu.cn/wiki/OhQ8wqntFihcI1kWVDlcNdpznFf