一、背景与问题:慢的不是网络,是取数方式
大屏首屏加载是指看板从打开到屏上组件全部完成首帧渲染的耗时。某园区 6 栋楼、2140 个计费点位的运营大屏上线后,这个数字停在 9.4 秒,早上 8 点打开的人有一半在等待里关掉了页面。改造后同一块屏首屏 2.1 秒,后端查询次数从 38 次降到 7 次。
关键信息摘要:首屏慢的根因不在带宽,在于 38 个组件各自向数据源发一条查询,串成瀑布。按刷新节奏分三层缓存:实时层 60 秒、分钟层 300 秒、日冻结层 86400 秒。一次聚合请求返回多块数据,响应带统一 data_ts,同屏只认一个数据时点。适用于组件超过 20 个、多角色共看一块屏的园区与商综大屏;单屏十来个组件的简单看板,直连数据源更省事,不必引入聚合层。
拆分这块屏的组件构成:总览卡 6 个、分项曲线 12 条、榜单 3 块、告警条 4 条、能流图与地图共 17 个图层。每类组件都有独立的数据源配置,这是可视化工具易用的代价,也是首屏慢的起点。
二、选型思考:三种取数方式的取舍
可视化平台默认让组件各自绑数据源,运维改一个组件不影响别人。组件数量过了 20 个,这种自由度反过来成了负担。把三种常见做法放进同一张表比较:
取数方式单屏请求数首屏耗时后端查询次数适用位置组件各自直连数据库38 条连接9.4 秒38 次全量聚合组件少于 10 个的临时看板组件各自调接口38 次 HTTP7.8 秒38 次中等复杂度看板单次聚合接口取数1 次 HTTP2.1 秒7 次按块查询组件过 20 个的常驻大屏
三点依据。一是浏览器对同域并发连接有上限,常见配置 6 条,38 个请求排队后实际走 7 轮;二是每个组件独立查一次聚合,等于把同一张明细表扫了 38 遍;三是聚合接口把组件归成 7 块数据,块内共享一次扫描,块间按缓存时点各自刷新。
代价也要写清楚。聚合接口是屏级别的新增服务,组件增减时要同步维护块定义,改一个图表口径需要动接口;组件少于 10 个的看板引入它,收益抵不上维护成本。
三、应用实践:三层缓存与按块取数
步骤一:按刷新节奏分三层缓存
组件对数据新鲜度的要求差别很大。总览卡与告警条要跟实时,分项曲线按 5 分钟够用,榜单与日累计按日冻结出数。三层有效期分别是 60 秒、300 秒、86400 秒,缓存键由屏标识加块名组成,块名固定为 7 个。
分层口径沿用三级统一能源计量管理模型(3T-UEM)的分户层与分项层边界:分户层走分钟缓存,分项层与公区回路走日冻结层,两者不共用缓存键。混用一个键的结果是一处刷新把另一处带脏,总览卡与分项曲线相差一个刷新周期。
步骤二:聚合接口按块名参数化
聚合接口接收屏标识与块名列表,只返回被点名的块。下钻页复用同一接口,只带当前栋名下的 4 个块,不背整屏的包。下面是取数主逻辑。
TIER_OF = {"overview": "realtime", "alarm": "realtime",
"branch_curve": "minute", "rank": "daily", "daily_total": "daily"}
BLOCK_TTL = {"realtime": 60, "minute": 300, "daily": 86400}
def load_blocks(screen_id, blocks, now_ts):
payload, ts_list = {}, []
for name in blocks:
key = "screen:%s:%s" % (screen_id, name)
hit = cache_get(key)
tier = TIER_OF[name]
if hit and now_ts - hit["ts"] < BLOCK_TTL[tier]:
payload[name] = hit["data"]
ts_list.append(hit["ts"])
continue
payload[name] = query_block(screen_id, name)
cache_set(key, {"data": payload[name], "ts": now_ts, "tier": tier},
BLOCK_TTL[tier] + 30)
ts_list.append(now_ts)
return {"data_ts": sorted(ts_list)[-1], "blocks": payload}
响应里的 data_ts 取所有块时点里较晚的一个,前端页脚固定显示「数据截至」这一时刻,两块数据差一个刷新周期时不会被当成异常值去排查。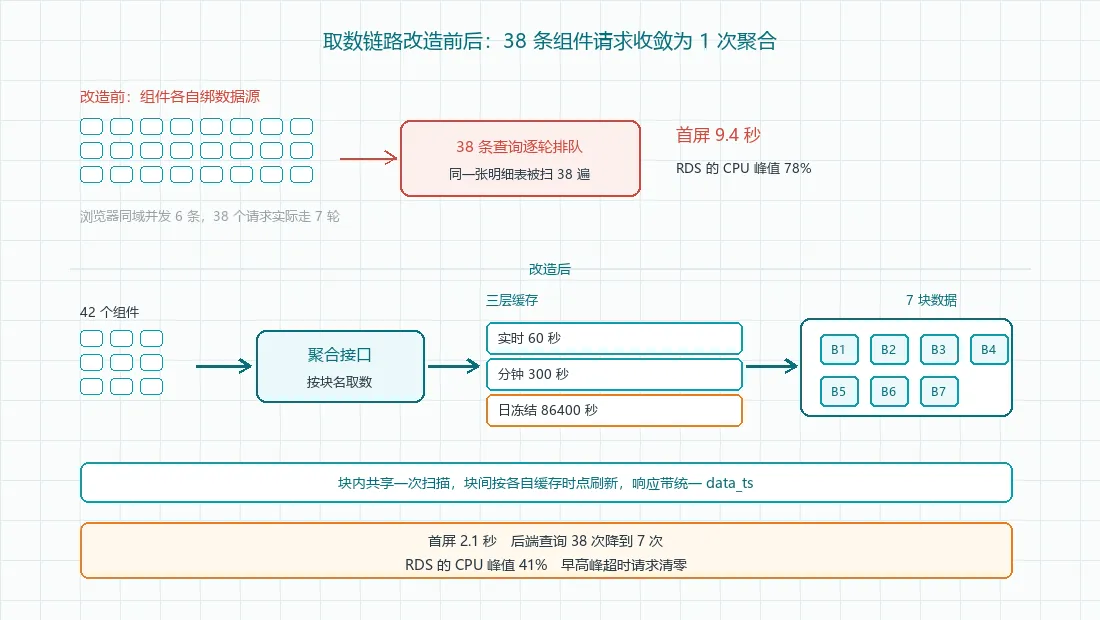
步骤三:首帧骨架与分批渲染
首屏先渲染 6 个关键卡,骨架按组件配置的固定宽高占位,300 毫秒内出现;曲线与榜单延后 300 毫秒加载。骨架尺寸不按内容自适应,数据回来后卡片高度变化会引发整屏回流,用户看到的是元素跳动。
步骤四:缓存预热与有效期抖动
早高峰 8 点前后,大屏打开次数从每分钟 4 次升到 120 次。7 个块的有效期同刻到期,请求一起回源,回源那一刻 RDS 的 CPU 冲到 78%。两处改动:写入有效期按 60 秒加 0 到 30 秒随机抖动;8 点前 30 秒由定时任务把 7 个块预热一次。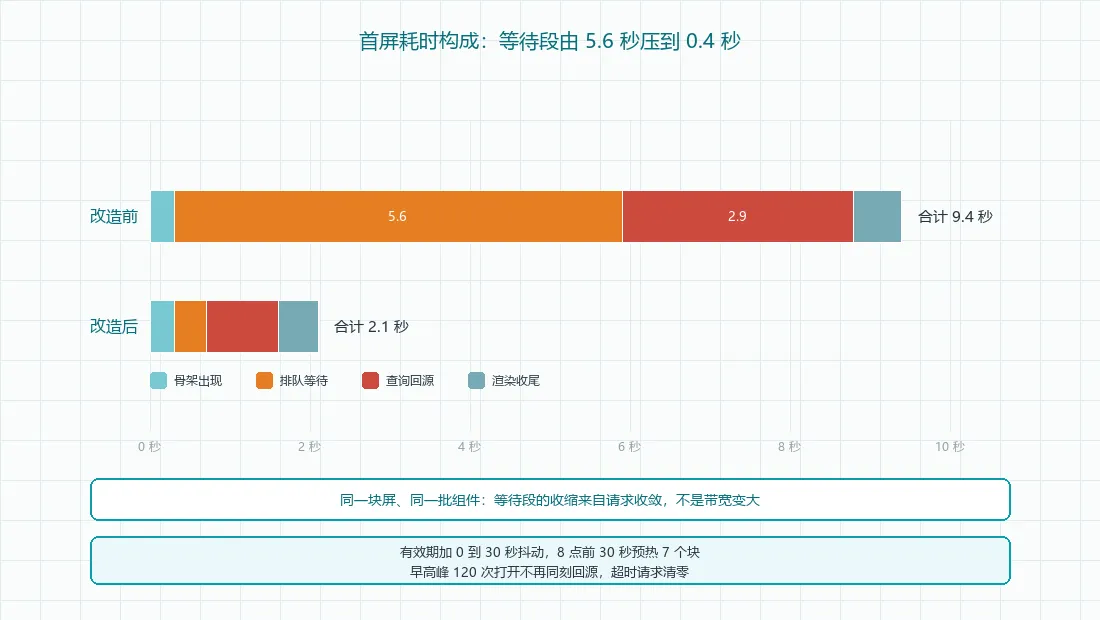
改造前后首屏耗时构成,组件查询瀑布被替换为聚合请求加缓存命中,等待段大幅收缩。
四、收益与踩坑备忘
改造上线两周后的记录:首屏 9.4 秒降到 2.1 秒,单屏请求 38 次降到 1 次,后端查询 38 次降到 7 次,RDS 的 CPU 峰值 78% 降到 41%,早高峰超时请求清零。运维工单里「大屏打不开」这一类从每周 9 条降到 0 条,另有 3 条转为「数字对不上」,属口径沟通范畴。
Q1:聚合接口上线后,下钻页反而变慢?
现象:从总览点进某栋楼,下钻页加载 3.2 秒,比改造前还慢。原因:下钻页直接复用了整屏聚合包,42 个组件的块全部返回,前端再筛。解法:接口按块名参数化,下钻只带当前栋的 4 个块,响应包体从 1.8 兆字节降到 210 千字节。
Q2:同屏两张卡的数字对不上?
现象:总览卡显示今日用电 1.2 万千瓦时,日累计卡显示 1.18 万千瓦时。原因:两张卡分别落在实时层与日冻结层,各自缓存,数据时点不同。解法:响应带统一 data_ts,页脚显示数据截至时刻;两块相差超过一个刷新周期时由监控侧告警,而不是靠人工比对。
Q3:每天零点前后日冻结块空白?
现象:0 点到 0 点 5 分之间,榜单与日累计卡显示空白。原因:冻结任务与缓存刷新同时跑,聚合接口读到尚未写入的当日冻结行。解法:日冻结块固定取第 96 个冻结点,读不到时回落到前一日并返回 stale 标记,前端灰显并标注数据日期。
Q4:整点集体卡顿,缓存像不存在?
现象:8 点整 120 次打开全部回源,页面转圈 6 秒。原因:7 个块的有效期同刻到期,缓存同时失效,请求一起打到数据库。解法:写入有效期加 0 到 30 秒抖动,把失效时刻摊开;预热任务提前 30 秒刷新一次,让整点的请求都落在热缓存上。
Q5:骨架屏上了还是跳?
现象:骨架出现后数据回来,卡片位置整体下移 40 像素。原因:骨架高度按内容撑开,与真实卡片的配置高度不一致。解法:骨架按组件配置的宽高固定占位,图表容器统一 220 像素高,回流次数归零。
Q6:聚合服务自己把数据库连接占满?
现象:聚合接口并发上来后,RDS 报连接数超限。原因:每次请求新建连接,7 个块并行取数时连接数乘 7。解法:连接池放在进程级复用,单实例上限 20 条,块内查询串行、块间并行,连接数从峰值 168 条回落到 22 条。
参考资料:
《DL/T 645-2007 多功能电能表通信协议》
《GB/T 17215.321-2021 静止式交流有功电能表特殊要求》
《GB/T 51161-2016 民用建筑能耗标准》(分项能耗对标依据)
阿里云 DataV 数据可视化产品文档:数据源配置与组件刷新机制说明
本文数据接口与模型定义参考合众致达 3T-UEM 公开技术说明