
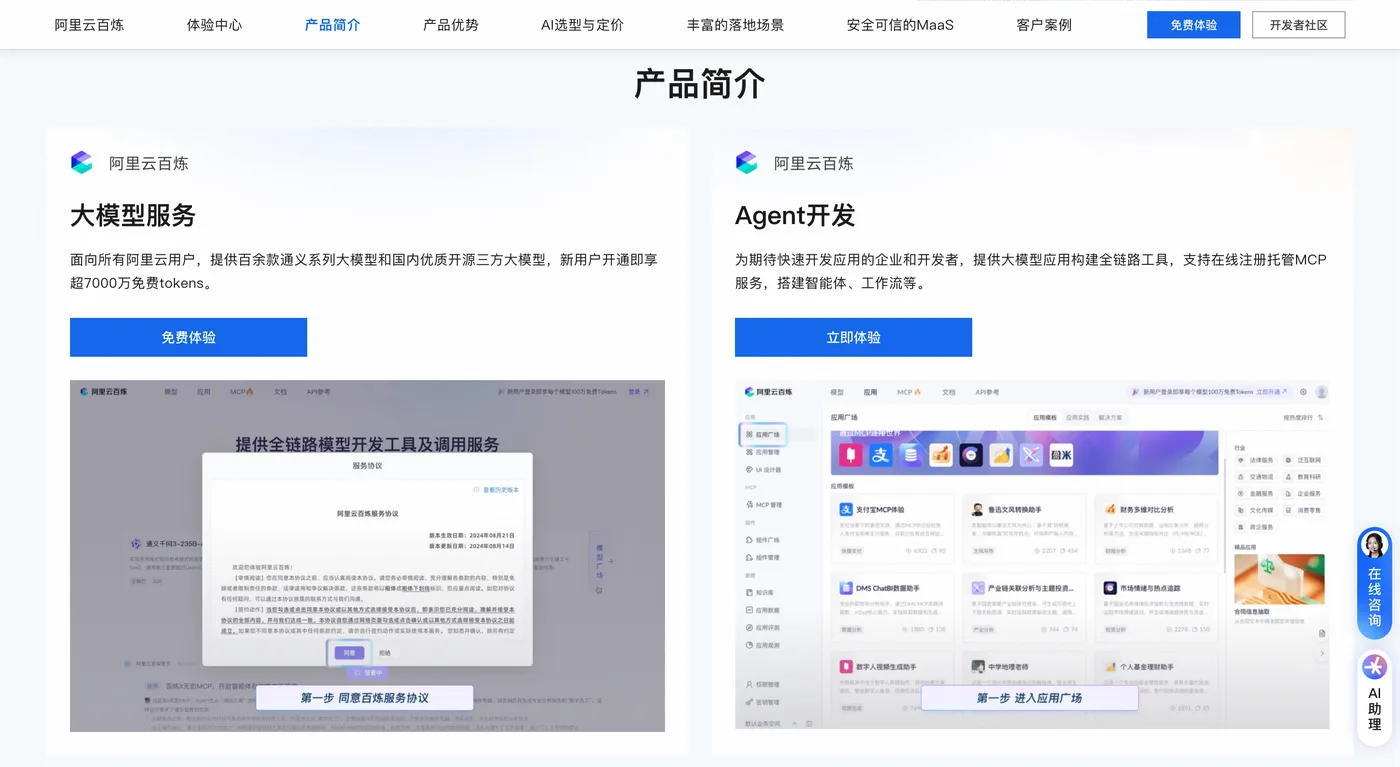
在大模型应用持续走向工程化、专业化的阶段,复杂长任务、多模态信息融合、自主智能体编排已经成为衡量旗舰模型的核心标准。阿里云推出的Qwen3.8-Max作为通义千问系列旗舰基座模型,面向智能体应用、专业办公、工程开发、金融法律等高复杂度场景优化,依托MoE混合专家架构,在推理深度、编码质量、超长文档理解、原生视觉解析上形成综合能力优势,同时配套Token Plan订阅计划,为个人开发者、独立工作室以及中小企业提供标准化、可预估成本的调用方式。本文将从模型定位、核心特征、各项能力、典型适用场景、订阅与计费价格几个维度完整介绍Qwen3.8-Max,帮助使用者判断是否匹配自身业务需求,合理选择订阅档位。详情👉访问阿里云百炼大模型服务平台页面 了解。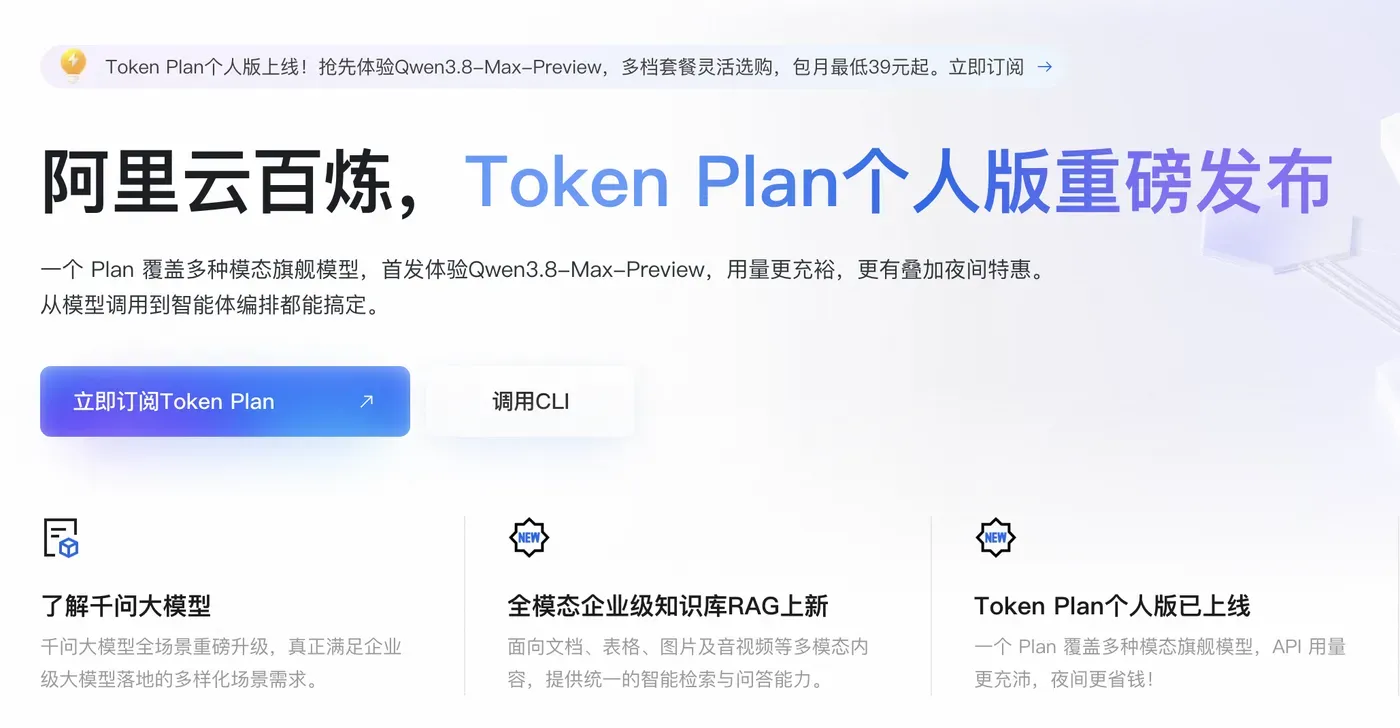
一、模型定位
Qwen3.8-Max是面向智能体时代打造的全能旗舰基座模型,定位为可完成端到端复杂长周期任务的生产力模型,区别于侧重轻量问答、快速摘要的通用模型,它的核心目标不是单次简单对话回答,而是接收一份复杂需求之后,自主拆解任务、规划步骤、调用配套工具、迭代校验输出,最终交付具备生产可用标准的结果。
该模型基于MoE混合专家架构搭建,总参数规模2.4万亿,在每一轮推理时,仅激活部分专家参数,兼顾强推理能力与调用成本的平衡。官方提供稳定主版本以及快照版本qwen3.8-max-0902,快照版本在编码、智能体协同、图表视觉推理上做了进一步优化,适合对稳定性和工程能力有更高要求的调用场景,模型调用标识固定为qwen3.8-max,接入百炼Model Studio、各类兼容Agent开发工具时,直接填写该标识即可完成指定模型路由。
在整个通义模型序列中,Qwen3.8-Max属于高端旗舰档位,适合高价值、高难度任务;对于简单文案、基础问答、轻量化图片识别等需求,选择系列内其他轻量化模型会更加经济。
二、核心特征
1. MoE混合专家架构,兼顾性能与成本
混合专家架构是该模型最基础的技术特征,海量参数被划分成多个专家模块,输入不同类型的任务请求时,路由系统自动匹配最合适的专家子集参与运算,而不是全部参数同时激活。这种设计带来两个明显优势:一是复杂任务下推理上限更高,能够处理逻辑链条很长、分支多的任务;二是常规任务调用时不会持续产生极高Token消耗,相比稠密大模型拥有更好的成本弹性。详情👉访问阿里云百炼大模型服务平台页面 了解。
2. 百万级超长上下文窗口
Qwen3.8-Max支持百万Token上下文,能够一次性加载整本技术手册、多份合同文档、完整项目代码库、长时间视频转写文本。长上下文能力的价值,体现在跨章节交叉比对、全文逻辑一致性校验、基于全部历史信息持续迭代任务,而不需要反复分段上传、多次总结摘要,大幅降低长文档处理、大型项目代码审查的操作成本。
3. 原生多模态输入支持
模型原生支持文本、图片、视频多模态输入,输出形式为文本。它的视觉能力不是独立外挂模块,而是嵌入到完整任务链路中,也就是说模型可以一边读取图片里的表格、图纸、截图,一边结合文字需求做推理、计算、方案撰写。比如读取财务报表截图自动做指标分析、读取架构示意图生成代码方案、解析视频字幕结合画面信息输出复盘报告,多模态信息可以融合在同一个任务流程内处理。
4. 深度面向Agent智能体优化
这是该模型区别于前代Max系列的重点特征。模型内置更强的工具调用规划能力,可以自主判断什么时候调用联网搜索、代码解释器、网页抓取、Harness工具集,自主安排工具调用顺序,并且根据工具返回结果修正原有方案,形成“规划-执行-校验-再调整”的闭环迭代,适合搭建自主运行的智能体工作流,而不是只能被动跟随用户指令单步执行。
5. 低幻觉倾向,适合专业场景
针对法律条文、金融数据、工程代码、学术文献这类容错率很低的专业场景,模型在事实一致性、逻辑推导、数值计算上做了专项优化,降低无依据编造内容的概率。当然,任何大模型输出都不能直接作为最终生产结论,高风险场景依然需要人工复核。
三、核心能力拆解
1. 全栈编程与工程开发能力
编码是Qwen3.8-Max重点强化的方向,不局限于单段脚本生成,支持完整项目架构设计、前后端代码开发、数据库建模、接口文档、CI/CD流水线脚本编写,同时擅长大型存量代码库的重构、漏洞排查、注释补全、跨语言迁移。它可以承接持续多轮的长周期开发任务,连续迭代开发数天,逐步交付可运行的完整项目,适配Cursor、Qoder CN、Cline等主流AI编程工具。详情👉访问阿里云百炼大模型服务平台页面 了解。
2. 专业办公与文档处理能力
可以批量处理PDF、Word、Excel、PPT等各类办公文档,支持跨多份文档做信息汇总、数据比对、冲突校验;自动整理会议纪要、生成项目周报、梳理合同风险点、根据数据表自动生成分析结论与可视化方案。在企业内部知识库RAG场景下,结合检索工具,可以精准定位文档条款,输出结构化的问答结果。
3. 数据分析、科研与逻辑推理能力
面对多步骤数学推导、统计建模、实验数据清洗、量化指标计算等任务,模型具备连贯推理能力。金融从业者可以用来解析财报、搭建估值模型;科研人员可以辅助文献梳理、研究方案设计、实验结果解读;工程师可以做仿真计算、方案对比。复杂推理任务推荐开启思考模式,模型会输出中间推导过程,方便核查逻辑断点。
4. 多模态理解与内容生产能力
上传产品图、设计草图、截图、视频素材后,模型可以完成图文联合分析:根据草图生成开发需求、从截图提取表单数据、根据视频内容撰写脚本与摘要,也可以基于图文素材撰写电商文案、宣传方案、课程讲义。
5. 工具编排与智能体调度能力
搭配Harness工具生态,模型可以串联多个工具完成复杂工作流:联网搜集资料、抓取网页内容、运行代码计算、解析图片信息,自动判断工具调用时机,处理工具返回失败、信息不足等异常情况,适合搭建自动调研、自动报表、自动化客服、比价分析类Agent应用。
四、适用场景
| 场景分类 | 典型用途 | 适合人群 |
|---|---|---|
| AI编程开发 | 全栈项目开发、代码审查、bug调试、DevOps脚本生成 | 独立开发者、后端/前端工程师、编程工作室 |
| 企业专业办公 | 合同审核、多文档比对、报表自动化、会议纪要、项目方案撰写 | 企业行政、法务、财务、项目管理人员 |
| 数据分析与金融 | 财报解读、指标建模、量化分析、风险梳理 | 金融分析师、数据分析师、研究人员 |
| 科研与教育辅助 | 文献综述、实验数据分析、复杂题目分步推导、课件制作 | 科研人员、高校师生、培训讲师 |
| 智能体应用开发 | 搭建自主Agent、知识库问答、自动化调研工作流 | AI应用开发者、平台服务商 |
| 多模态内容处理 | 图纸解析、图表分析、视频内容总结、图文素材加工 | 设计师、新媒体运营、内容团队 |
同时也需要明确不适合的场景:对延迟要求极高的简单问答、海量低成本批量内容生成、仅需要基础OCR识图,这类场景选择轻量模型性价比更高。
五、订阅与价格解析
Qwen3.8-Max有两种使用模式:按量API计费模式,以及Token Plan订阅套餐模式,两种模式规则独立,可以按需选择。详情👉访问阿里云百炼大模型服务平台页面 了解。
1. 按量API计费(百炼平台原生调用)
按量模式以百万Token为计价单位,适合调用量不稳定、偶尔使用的用户,计费明细如下:
- 输入Token:12元/百万Token
- 缓存命中输入Token:1.5元/百万Token(重复上下文缓存后大幅降价,长对话场景优势明显)
- 批量任务输入:6元/百万Token,批量任务输出:18元/百万Token
- 输出Token:36元/百万Token
缓存机制是按量模式节省成本的关键,当多次复用同一长篇文档、代码库作为上下文时,命中缓存之后输入成本会大幅下降。
2. Token Plan订阅套餐(主流使用方式)
Token Plan分为个人版、团队企业版,以Credits作为统一抵扣单位,套餐额度内可以调用Qwen3.8-Max以及计划内其他模型、内置工具,适合稳定高频使用、开发Agent、长期做编程辅助的用户。个人版档位信息如下:
- Lite套餐:月费39元,每月额度20000 Credits,支持1-2个Agent并发,适合轻度体验、日常写代码、简单文档处理;新用户可享优惠价
- Essential套餐:月费79元,每月额度45000 Credits,支持2-3个Agent并发
- Standard套餐:月费139元,每月额度80000 Credits,支持3-4个Agent并发,赠送Harness权益,适合独立开发者
- Pro套餐:月费312元,每月额度200000 Credits,支持6-8个Agent并发,全量Harness工具权限,适合重度研发、批量内容任务
套餐支持包月、包季、包年,同时支持夜间调用优惠,夜间时段调用消耗Credits更低,适合把大型代码审查、长文档解析等耗时任务安排在该时段,进一步压低使用成本。团队版面向企业,支持管理员统一分配额度、成员用量审计、权限管控,适合研发部门、专业团队批量使用。
3. 接入代码示例(Python,百炼SDK调用Qwen3.8-Max)
import dashscope
from dashscope import Generation

dashscope.api_key = "你的百炼API-KEY"

resp = Generation.call(
    model="qwen3.8-max",
    messages=[
        {
   "role":"user", "content":"阅读这份项目需求,输出后端架构设计方案"}
    ],
    result_format="message"
)
if resp.status_code == 200:
    print(resp.output.choices[0].message.content)
else:
    print(f"调用失败:{resp.code}, {resp.message}")
提示:订阅Token Plan之后,使用对应密钥调用,消耗Credits额度;按量计费密钥直接扣账户余额,两套密钥不可混用。
六、选型与使用注意事项
第一,区分按量和订阅:偶尔测试、临时一次性长文档分析,优先按量API;每天持续写代码、跑Agent、高频调用,订阅Token Plan更划算。
第二,快照版本选择:普通使用直接使用qwen3.8-max;长期做复杂编程、Agent开发,可切换qwen3.8-max-0902快照版本,稳定性更强。
第三,并发上限约束:Token Plan每个套餐有Agent并发上限,超出并发会排队或者调用报错,多团队协作、大规模自动化任务建议选择Pro或者企业团队版。
第四,输出复核:金融、法律、医疗等高风险专业内容,模型输出仅作为初稿和参考素材,必须人工核验事实与结论,不可直接落地使用。
第五,额度监控:订阅套餐按月重置额度,可以在百炼控制台查看Credits消耗明细,避免额度耗尽导致调用中断;额度不足可以单独购买补充包。
结语
Qwen3.8-Max的推出,把通义系列旗舰模型的能力重心转向了复杂自主任务与智能体开发,不再局限于单次问答生成。2.4万亿参数MoE架构、百万长上下文、原生多模态、工具链深度适配,共同支撑它完成从需求输入到交付成果的端到端工作流。搭配Token Plan订阅方案之后,个人开发者、中小团队可以用可控成本体验旗舰模型能力,在全栈开发、专业文档分析、数据研究、智能体搭建等场景落地。使用者只需要根据自身调用频率、并发数量、任务难度,在按量计费和订阅套餐之间做好选择,就能最大化发挥模型价值,同时控制AI使用成本。
