一句话定位:这不是"哪个 Agent 写代码更强",而是"怎么判断一篇自动生成的测试有没有真在检查东西"——载体是一批测试用例,被测对象是"用一份标准答案来验收测试"这个评测标准本身。同样的方法可迁移到自动生成接口用例、批量补单测、用 AI 补回归、把手工用例转自动化这四类场景。
二、摘要
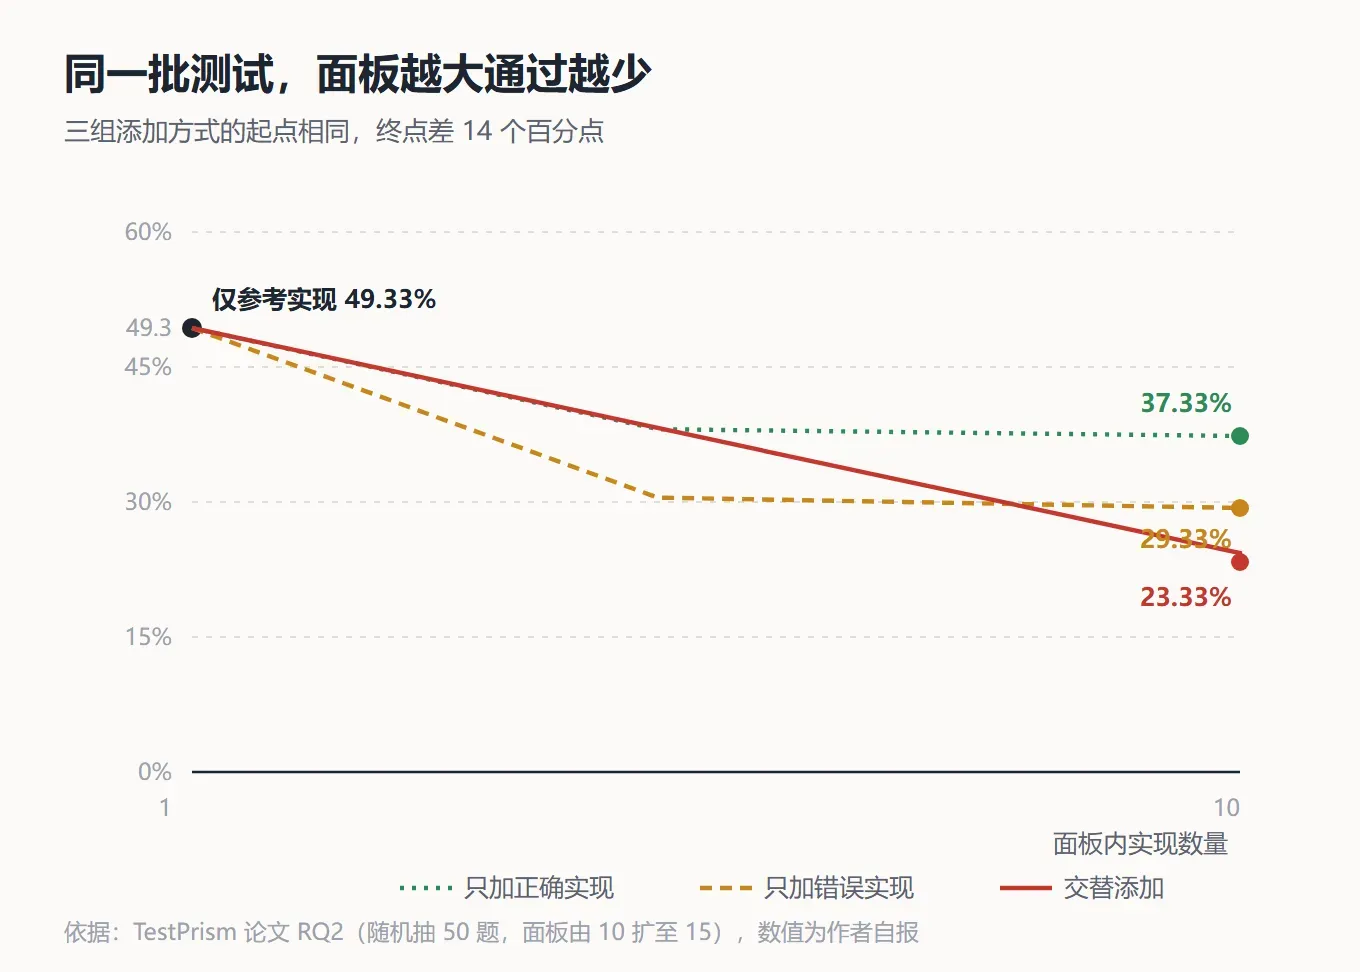
2026 年 10 月公开的 TestPrism 给每道测试任务配了 10 份实现:1 份参考实现、4 份正确的替代实现、5 份错误实现。衡量标准只有一条——测试要在原始代码上失败、接受全部 4 份正确实现、拒绝全部 5 份错误实现,三件事同时做到才算过。在这个标准下,14 种 Coding Agent 配置里最强的一个从 59.67% 掉到 28.00%。本文讲清三件事:为什么通过标准答案的测试有一半不可靠;286 条失败轨迹里最大的一类错误是什么;以及怎么在自己团队用最低成本做一次同样的体检。
先看一组对照,因为它把问题说完了。
同一个测试,在原始代码上跑,失败;在标准答案上跑,通过。按传统标准,这是一份成功的测试——它区分了"修复前"和"修复后"。
现在给同一道题再加九份实现:四份是另一个模型写的、同样正确的解法,五份是错的。再跑这个测试。结果它接受了某些错误实现,或者拒绝了某些正确实现。
传统标准判它成功,新标准判它失败。
这就是 TestPrism 做的事情。它的官方仓库(github.com/TestPrism/TestPrism,Apache 2.0 协议)里,"multi-patch protocol" 一节把判定写得没有歧义:A strict solve requires detecting the baseline, accepting every oracle-valid candidate, rejecting every oracle-invalid candidate, and encountering no patch execution errors.
四项同时满足才算解出:在基线上能检出、接受每一份正确的、拒绝每一份错误的、且补丁执行本身不报错。
一个被用了很多年的评测标准,隐含了一个很强的假设
过去的测试生成评测怎么做?叫 Fail-to-Pass:测试在修复前失败、在参考修复后通过,就算成功。这个标准简洁、可执行,用的人很多。
它的隐含假设是:只要测试能区分"修复前"和"参考修复后"这两个状态,它就足以判断任意实现是否正确。
这个假设在现实中很容易不成立。两个方向都会出问题:
漏检:测试只构造了部分输入,或者断言写得太弱。参考答案能过,有 bug 的实现也能过。
误伤:测试把参考答案的实现细节当成了需求本身——固定了内部函数名、输出格式、中间状态。另一种同样合法的实现被它判错。
第一种情况团队多少有意识。第二种很少被讨论,但数据说它更常见。
数字
论文与开源仓库报告的结果(以下均为论文作者自报):评测覆盖 14 种 Coding Agent 配置、6 个模型家族,测试集 300 道任务、3000 份带标签的候选实现,来自 17 个公开 benchmark。
| 配置(各家族中 JSF 最高者) | 单一参考评测成功率 RAR | 联合成功 JSF |
|---|---|---|
| Claude Fable 5.1 | 59.67% | 28.00% |
| Kimi K3 / Qwen3.8 Max / GPT 5.6 sol-max | 54%—57% | 23%—25% |
| DeepSeek V4 Pro | — | 13.33% |
| GLM 5.3 | — | 11.33% |
第一行是全文最重要的一个数:同一个测试集,同一个模型,把验收标准从"一份参考答案"换成"十份实现",通过率从 59.67% 掉到 28.00%。
掉了一半多。这掉下去的部分,就是"通过了参考答案但经不起别的实现检验"的那批测试。
原文还有两个细节值得记:
覆盖率与 JSF 的相关系数:Change Coverage 0.91、Entry Coverage 0.96,很高。但原文说得很清楚——覆盖到相关代码只是正确判断的前提,测试执行了某段逻辑不等于它的断言能判断这段逻辑的行为。高覆盖率和"能抓 bug"是两件事,只不过经常被当成一件事。
六个配置里有五个 IRR 高于 VAR,也就是"拒绝错误实现的能力"普遍强于"接受正确实现的能力"。换句话说,当前 Agent 写测试更常犯的错是过严——把一种写法定成唯一写法。
这一条对我们理解自己团队的情况很有用。人为写测试偏松(怕麻烦、怕假红),AI 写测试偏紧(它把看到的那一种实现当成规范)。所以用 AI 补的用例,第一波红往往不是发现了 bug,是误伤。
失败的 286 条轨迹里,一半不是"没测到"
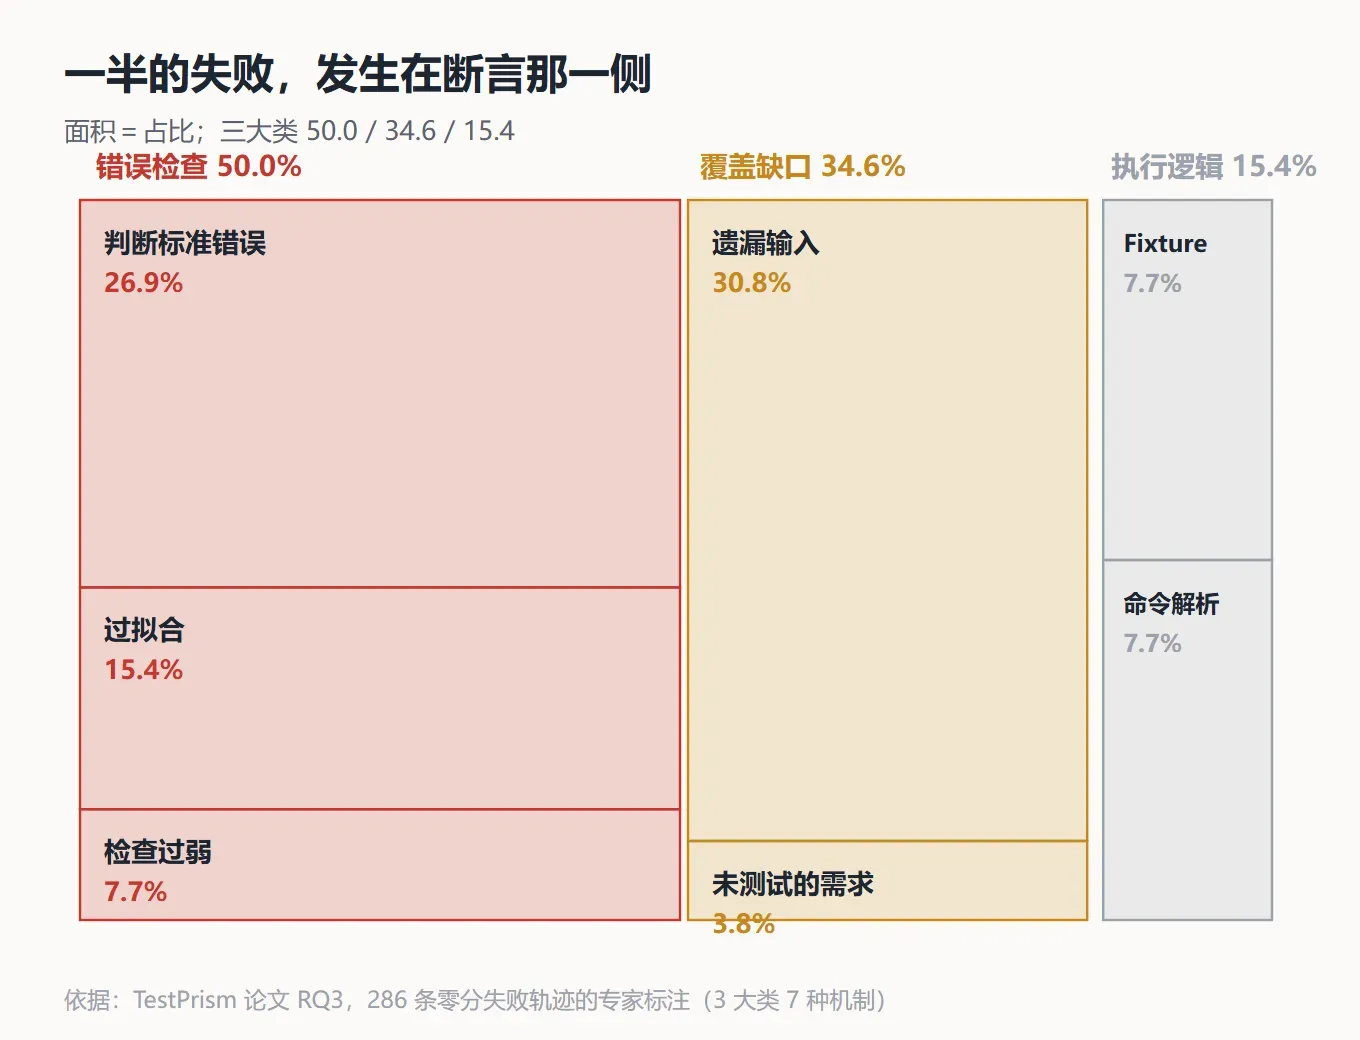
研究团队从六个家族的最佳配置里各抽 50 条 JSF 为零的失败轨迹,去掉 14 条超时,两位专家独立标注 286 条(Cohen's κ = 0.81),分歧时引入第三位专家。最后归纳出 3 大类、7 种错误机制。
| 大类 | 占比 | 具体机制 |
|---|---|---|
| 覆盖缺口 | 34.6% | 遗漏输入 30.8%、未测试的需求 3.8% |
| 错误检查 | 50.0% | 判断标准错误 26.9%、过拟合 15.4%、检查过弱 7.7% |
| 执行逻辑错误 | 15.4% | Fixture 与 API 使用错误 7.7%、命令执行与输出解析错误 7.7% |
一半的失败在"错误检查"这一类。而这些测试都跑到了相关代码、都执行完了、都产出了结果——它们只是在判断一件事的时候判错了。
两个原文例子,我认为值得逐字复述,因为它们太好了:
扑克牌型判断:生成的测试从来没比较过"A 作为最小牌的顺子"和"三条"的大小,于是一个把这种顺子错判成"高牌"的实现顺利通过了测试。
括号解析:测试确实构造了包含不匹配括号的输入,但只检查了输出结果的数量,没检查内容,导致一个丢弃了合法分组的实现被接受。
这两个例子都有一个共同点:测试在原始代码上失败、在参考实现上通过。 按单一参考评测,它们都是"成功"。只有加入额外的错误实现,遗漏的输入组合和过弱的断言才被暴露。
这是我在这整份材料里最想让人记住的一句话:一个测试"在 bug 上红了",不证明它测对了,只证明它能红。 这句话我之前只是模糊地觉得对,现在有 286 条标注轨迹做支撑。
这个仓库里有什么,能不能真跑
这部分我专门核了,因为"开源实现"这四个字经常是虚的。
仓库里确实有 testprism/(benchmark CLI、agents、容器运行时、解析器、评测 harness、只读的多补丁契约)、TestHelix/(论文里的测试生成 agent,含源码、skills、适配器、配置与测试),以及 scripts/validate_artifact.py(离线结构、体积与匿名性检查)。
数据不在仓库里,在两个 Hugging Face 数据集:2000 任务的完整测试集(testprism-verified-tasks),和 300 任务的冻结多补丁集(testprism-patch-sets,每题 10 份候选)。
跑法给了两个命令,我原样抄下来,因为它说明"可运行"不是形容词:
uv run tb testbench run \
  --dataset-path verified_tasks/test \
  --patch-set-path patch_sets \
  --task-id <TASK_ID_FROM_BENCHMARK300> \
  --agent codex \
  --model openai/<model-name> \
  --n-concurrent 1 \
  --patch-concurrency 1 \
  --no-cleanup
要求是 Python 3.12+、Node 22.19+、uv、带 Compose 的 Docker,以及你选的 agent 的凭据。每题会 build 或 pull 自己的 Docker 环境,官方也提醒全量跑很吃算力和存储。
一个必须说明的局限:这个仓库是匿名评审用的 artifact,git 历史被重建为单次提交(作者署名为 Anonymous),补丁生成器"有意排除"在外。所以你能复跑评测,但没法复现他们生成那 3000 份候选实现的完整过程。
这对我们使用它意味着什么?意味着它是一个可复用的验收标准,不是一个可直接复制的生产工具。想把 JSF 搬到自己团队,功课在"怎么造那九份实现"上,不在"怎么算这个分数"上。
自己团队怎么用:先别抄指标,先抄构型
这是我给的具体动作,三步,成本递增。
第一步,挑三个用例,各造两份错误实现。 不用九份,两份就够。造法很土:把被测逻辑里最关键的一个判断翻过来(> 改成 >=、if 里的条件取反、边界值加减一)。然后用你现有的测试跑。如果有测试对两份错误实现都放行,你的测试里就有一份是"能红但不会抓"的。
第二步,给这三份中的每份再配一份"写法不同的正确实现"。 这一份最难造,但它专门用来抓"过严"。造法是:换一种等价实现(用不同的库、不同的数据结构、不同的函数拆分),只要输入输出一致就算正确。你的测试如果对它报错,说明它绑定了实现细节。
第三步,把这两步写成脚本挂进流水线,只对新生成的测试跑。 不用对存量跑——存量太多,跑不动;新生成的那批才是风险集中区。
下面这段我按这个构型写了个最小实现,可以直接改成你项目里的形式:
# 多实现面板:一份测试要在 1 正 1 错(或多份)上同时"红得对、绿得对"
from dataclasses import dataclass
from typing import Callable

@dataclass
class Candidate:
    name: str
    impl: Callable[..., object]
    oracle_valid: bool   # True = 正确实现;False = 错误实现


def evaluate(test_fn: Callable[[Callable[..., object]], bool],
             baseline: Callable[..., object],
             panel: list[Candidate]) -> dict:
    """
    test_fn(impl) 返回 True 表示该测试在这个实现上通过。
    严格解出(JSF)要求四件事同时成立:
      1) 在基线上不通过(能检出问题)
      2) 接受全部正确实现
      3) 拒绝全部错误实现
      4) 执行过程不抛意外异常
    """
    errors: list[str] = []

    # 1) 基线必须红
    try:
        baseline_passed = test_fn(baseline)
    except Exception as exc:            # 测试自身写错,不是被测代码的问题
        return {
   "jsf": False, "reason": f"baseline 执行异常: {exc!r}"}
    if baseline_passed:
        errors.append("基线通过:测试无法检出原始问题")

    # 2) / 3) 逐份比对
    for cand in panel:
        try:
            passed = test_fn(cand.impl)
        except Exception as exc:
            errors.append(f"{cand.name} 执行异常: {exc!r}")
            continue
        if cand.oracle_valid and not passed:
            errors.append(f"{cand.name} 是正确实现却被拒绝(过严)")
        if (not cand.oracle_valid) and passed:
            errors.append(f"{cand.name} 是错误实现却被接受(过松)")

    return {
   "jsf": not errors, "reason": ";".join(errors) or "严格解出", "n_panel": len(panel)}
注意 except 那一支的写法。测试自己抛异常,不能算作"成功检出了问题"——这是最容易写错的一处。原始评测里专门把 patch 执行错误单列为一项失败条件,就是因为这个坑。
还有一处我自己的教训:造"错误实现"时一定要检查它错得看起来合理。把 return price 改成 return None 这种,任何测试都会拒;真正要试的是"少算了一档折扣"这种——它返回一个数,看起来正常,只是数错了。我第一版造的三个错误实现全是None,跑出来通过率 100%,什么也没测出来。
我的判断:这套东西的方向对,但别停在分数上
我可以明确地说,JSF 这个指标比 Fail-to-Pass 强,因为它把"测试太严"这个长期被忽略的方向纳入了评测。但它也有个明显代价:造面板的成本比造测试还高。 每道题 10 份带标签的实现,靠人写不现实,靠模型生成又引入新的不确定性(面板本身的质量由谁保证?)。
所以我的建议是分场景用:评测集、公共 benchmark、关键模块的验收——值得全量做;日常补单测——做缩水版(1 正 1 错),跑得起、看得懂。
另外,这套东西让我重新理解了一句话:过去我们说"这个测试没覆盖到",现在更准确的说法是"这个测试覆盖到了,但没有判断力"。这两个描述的修复方式完全不同——前者加用例,后者改断言。
本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。