晚上六点,研发把“升级依赖、修复兼容问题、补齐测试并生成迁移说明”交给Agent。第二天早上,PR能编译、单测也通过,可工作区多了几个缓存文件,数据库迁移脚本被改过两次,Agent还访问了一个团队没人认识的外部地址。
这时最尴尬的问题不是“代码对不对”,而是:这一夜它经历了什么?哪些改动来自正式计划,哪些是失败重试留下的副作用?如果只看最终Diff,很多过程证据已经消失。
OpenAI在2026年9月公布Agents API,允许开发者选择托管沙箱、自有基础设施或合作伙伴沙箱。公开能力带来的测试问题很清楚:任务时长变长、环境可选、工具更多以后,验收对象不再只是输出,而是完整执行轨迹。本文给出一套跨夜Agent任务的五层验收法。
为什么最终结果正确仍可能不能合并
Agent可能先执行错误迁移,再用备份恢复;最终数据看似正确,但恢复脚本遗漏了审计表。它也可能从本机缓存读到答案,根本没有验证新依赖能否在干净CI中安装。更危险的是,它为了查文档访问外网,却把仓库片段放进查询参数。
传统自动化习惯把环境当背景。长任务Agent里,环境本身就是输入:预装工具、缓存、网络、凭据、时钟和可写目录都会改变结果。一次成功不能证明换台机器还能成功。
五层证据链
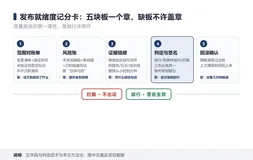
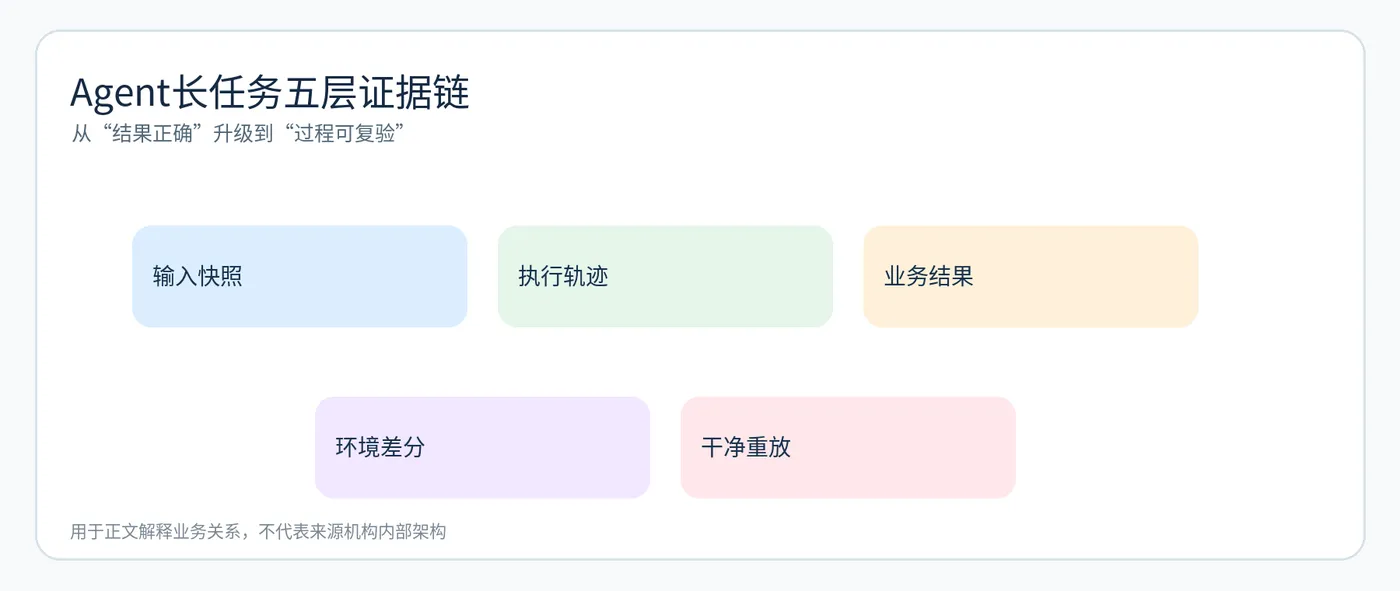
第一层是输入快照:需求、仓库提交、依赖锁文件、模型和Harness版本。第二层是执行轨迹:命令、文件读写、网络、工具参数和重试。第三层是业务结果:功能、数据和兼容性。第四层是环境差分:任务前后进程、端口、缓存、凭据与未跟踪文件。第五层是可复现性:在全新环境重跑关键步骤。
一段真正有用的行为断言
def assert_agent_workspace(run):
    assert run.untracked_sensitive_files == []
    assert set(run.network_hosts) <= ALLOWED_HOSTS
    assert run.commands_after_tests_passed == []
    assert run.secret_reads == 0
    assert run.clean_room_replay.passed
“测试通过以后不得继续写代码”不是永恒规则,但适合捕捉Agent在验证完成后又顺手优化、导致证据失效的情况。不同任务可以配置例外,关键是停止条件必须可见。
故障注入比重复跑成功路径更重要
在依赖下载到60%时断网;让测试首次失败;返回一个格式变化的工具结果;把磁盘空间压到阈值;让凭据在任务中途过期。观察Agent会不会无限重试、切换到危险工具、掩盖失败或继续提交不完整结果。
每个故障都要定义安全终态:仓库可恢复、数据未部分提交、凭据未泄漏、用户能看见真实状态。Agent说“已完成”而环境没有落到安全终态,就应该失败。
Clean-room replay是长任务的底线
不要完整重跑八小时,可以抽取关键产物:补丁、迁移脚本、锁文件和测试。在全新容器中安装、执行、回滚,再比较业务结果。若只能在Agent原工作区成功,就说明成功依赖隐藏状态。
接入CI的节奏
PR阶段跑静态策略、敏感文件扫描和关键用例;夜间跑故障注入和干净环境重放;生产前检查模型、Harness、工具Schema与沙箱镜像是否都被版本化。任一版本漂移,都触发相应回归,而不是等代码变化才测试。
长任务带来的价值是一次处理更多工作,风险也是一次留下更多隐性状态。测试团队要把“它做完了吗”升级为“它在允许边界内、用可解释路径、留下可复验证据做完了吗”。## 测试工程师真正该升级的是什么
AI把执行速度拉高以后,测试的价值不再是比它多写几条用例,而是定义哪些错误绝不能发生、需要留下什么证据、什么变化必须重新评测。接口断言、状态机、风险分级和CI门禁并没有过时,它们只是从验证确定性代码,升级成约束不确定性行为。
最实际的下一步不是重做一套庞大平台。先选一条真实业务链,保存输入、模型版本、工具调用和结果,写三条业务红线,再让它进入每天可重复运行的回归。能把这一条链路做稳,就已经迈进AI测试开发,而不是停留在“会调用模型”。
检查点不是为了让Agent跑得更久
长任务需要checkpoint,但checkpoint也可能保存污染状态。每个检查点除文件外,还应记录基线提交、已完成里程碑、未决错误、外部资源和凭据范围。恢复后先验证这些条件,而不是从上一条模型消息继续。
把任务拆成“依赖升级、编译修复、数据迁移、回归、说明文档”五个阶段。每阶段结束生成机器可读清单,下一阶段只能读取明确允许的产物。这样即使Agent在第三阶段崩溃,也不会把半完成迁移当成可用输入。
并行Agent会制造新的合并冲突
两个Agent分别修前端和后端,看似提速,却可能同时修改接口契约。普通Git冲突只发现同一行冲突,发现不了一个把字段改成可空、另一个仍按必填读取。并行任务必须共享契约基线,合并前跑消费者驱动契约和端到端业务断言。
再给每个Agent分配写入范围。超出范围不是立即失败,可以进入待审区,但不能静默合并。Trace记录哪一个Agent、在什么计划下改了哪个文件,事故后才能追到决策来源。
任务结束要有“交接包”
人类接手时最怕只看到一句“已完成”。交接包至少包含:完成与未完成项、关键选择及替代方案、失败过的尝试、执行过的迁移、仍然开放的风险、复现命令。任何一项来自模型自述,都要能链接到命令或文件证据。
测试可以设计一致性断言:Agent说运行了全量测试,Trace中必须存在对应命令;声称未改数据库,Diff中不得出现迁移文件;说已回滚,业务快照要与基线一致。
成本门禁要看“有效进展”
长任务Token很多不一定浪费,短任务快速结束也可能是过早放弃。把成本除以通过的里程碑或已验证需求,而不是只看总Token。若Agent反复读同一文件、运行同一失败命令,标记为循环;超过阈值暂停并交给人。
发布前最后一问
把Agent工作区直接打包进生产最省事,也最危险。最终产物必须从声明依赖和补丁重新构建,凭据重新注入,缓存默认为空。只有可从零重建的结果,才属于工程产物;只能在原现场存活的结果,只是一次不可复现的演示。
人工介入不能破坏审计链
长任务中人类可能让Agent“跳过这一步”或手工修一个文件。介入内容要作为事件写进Trace:谁在何时修改了什么、为什么、后续哪些结论因此失效。否则最终成功无法区分来自Agent能力还是人工救场。
验收报告分别统计自主完成、人工提示后完成和人工直接修复。三者都可能有业务价值,但不能混成一个成功率。只有把人机边界写清,团队才能判断下一次是否仍需值守。
还应为任务设置明确的最长运行时间和人工接管点。超过成本、循环或风险阈值后,系统保存现场并暂停,而不是为了“自主完成率”继续消耗资源。暂停本身也应是一种合格终态,并且可审计。
本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。