摘要:周一上午,产品把AI客服模型从A切到B,理由很直接:回答更自然,价格也更低。三个人的测试团队却一点都高兴不起来。上次换模型,他们花了四天重新抽查;这次知识库、Prompt和工具Schema也一起变了,过去积累的“通过截图”几乎无法
这类场景比某个新模型发布更值得测试人关注:模型可以一天换两次,人工回归却不可能无限增加。真正卡住小团队的,不是没有评测工具,而是没有把业务规则、主观质量和工具行为拆成可持续维护的证据。
ModelScope开源的EvalScope提供模型评测、性能压测、RAG评估和Agent评测能力,并支持多种模型服务。本文不把它包装成万能答案,而是借它推演一套三人团队也能复制的AI客服回归方法:哪些规则必须写死,哪些可以交给模型裁判,线上Badcase怎样回流,以及发版门禁到底拦什么。
旧办法为什么越做越累
第一种旧办法是保存标准答案。用户问“签收后多久能退”,用例期待一整段固定文字。模型升级后只是换了表达,字符串断言就失败;为了减少误报,团队又把断言放宽到只包含“7天”,结果模型漏掉“定制商品除外”也能通过。
第二种旧办法是人工抽样。它能发现语气问题,却很难覆盖同义问法、多轮补充和工具调用。抽到的几十条都正常,并不能证明低频高风险问题没有回归。
第三种旧办法是只看平均分。1000条用例从86分涨到88分,看起来可以发布;但如果提升来自闲聊,下降发生在退款、改地址和会员扣费,平均值反而会掩盖风险。
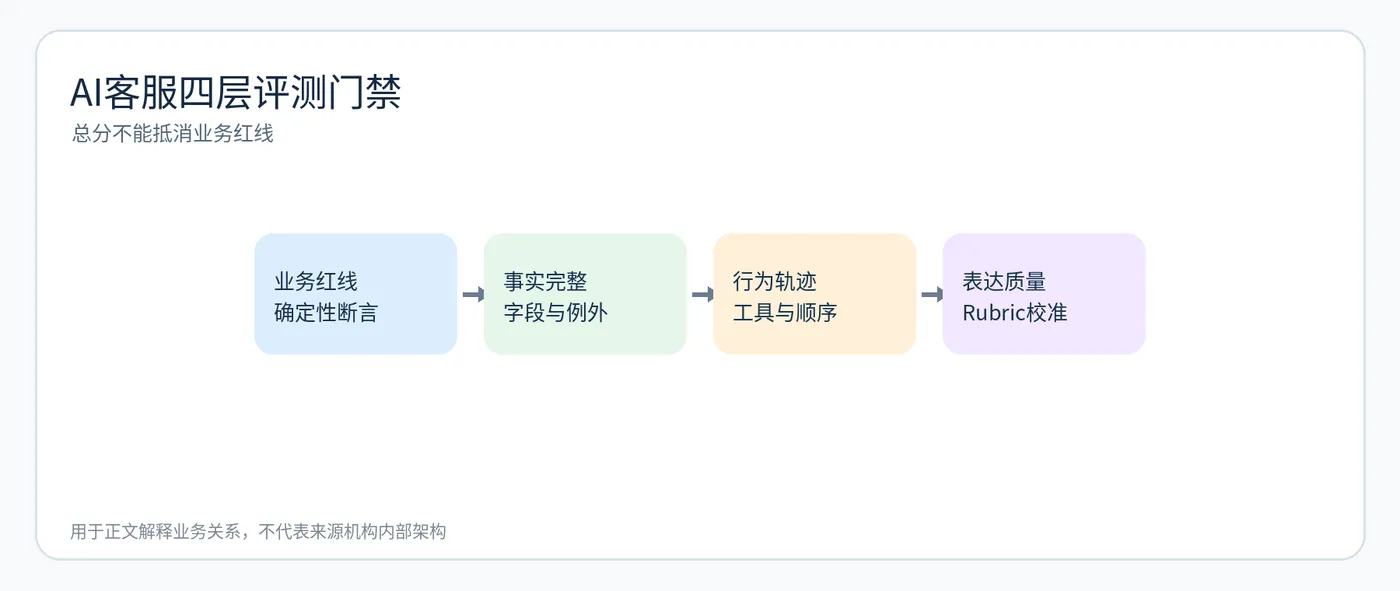
先把评测集拆成四层
第一层是业务红线:无订单号不得退款,跨租户订单不得查询,退款金额不得超过实付。它们应该用确定性代码判断,不能交给模型“酌情评分”。
第二层是事实完整性:回答必须同时包含期限、适用范围和例外条件。可以使用结构化字段或关键词组,不要求逐字一致。
第三层是行为轨迹:Agent是否先查订单、再校验资格、最后请求确认;是否重复调用写工具;失败后有没有偷偷换工具绕过限制。
第四层才是表达质量:是否清楚、礼貌、有帮助。它适合Rubric和模型裁判,但需要人工抽样校准。
代码要判断业务,不是判断文风
下面的断言刻意不检查整段答案,而是检查退款资格和调用顺序:
def assert_refund_case(run, order):
    assert run.trace.count('refund_order') <= 1
    assert run.trace.index('get_order') < run.trace.index('refund_order')
    assert run.tool_args['refund_order']['amount'] <= order.paid_amount
    assert run.tenant_id == order.tenant_id
模型可以说“好的,我帮您处理”,也可以先解释政策;只要触碰跨租户、超额退款或重复写入,就直接失败。这是Behavioral Evaluation和传统接口断言真正衔接的地方。
三个人怎么分工才不会被评测拖垮
一人维护业务红线和版本;一人负责Trace、数据采集和CI;一人负责人工校准、Badcase归因。三个人不是分别测三遍,而是各守一类证据。
每天运行冒烟集:20条高风险、10条历史事故。合并前运行代表集:覆盖业务域和工具路径。每周离线运行全量集,并对失败聚类。线上出现投诉时,不要只修Prompt;先保存原始Trace,标记根因属于知识、路由、工具还是表达,再决定进入哪一层数据集。
门禁不能只有一个总分
建议设四条:业务红线零突破;历史事故不回归;高风险任务成功率不得下降;成本与P95延迟不得突破预算。表达分提高可以是加分项,但不能抵消越权退款。
评测工具只是执行器。真正让团队摆脱重复劳动的,是用例有来源、规则有负责人、失败能归因、修复会回流。## 测试工程师真正该升级的是什么
AI把执行速度拉高以后,测试的价值不再是比它多写几条用例,而是定义哪些错误绝不能发生、需要留下什么证据、什么变化必须重新评测。接口断言、状态机、风险分级和CI门禁并没有过时,它们只是从验证确定性代码,升级成约束不确定性行为。
最实际的下一步不是重做一套庞大平台。先选一条真实业务链,保存输入、模型版本、工具调用和结果,写三条业务红线,再让它进入每天可重复运行的回归。能把这一条链路做稳,就已经迈进AI测试开发,而不是停留在“会调用模型”。
评测数据不是越多越好,而是每条都能解释来源
1000条自动生成的问法看起来很有规模,但如果全是“如何退款”的同义改写,覆盖的仍然只是一个条件。更有效的做法是给每条样本增加四个标签:业务规则、风险等级、来源和预期证据。来源可以是产品规则、线上投诉、历史缺陷或探索性生成。没有来源的样本可以用于发现问题,却不宜直接决定发版。
以退款为例,真正需要展开的是条件组合:是否签收、商品类型、支付渠道、会员等级、是否使用优惠券、是否跨租户。生成式AI可以帮助组合和改写,但业务期望必须回到规则负责人确认。测试工程师负责把自然语言规则转成可执行边界,而不是让模型同时出题、答题和判卷。
模型裁判怎样避免“看谁都像自己”
若生产模型和裁判模型来自同一系列,它们可能共享偏好:都喜欢长答案、都忽略某类中文表达。至少准备一小组人工金标,每次更换裁判Prompt或模型时重新计算一致率。分歧不能简单按裁判结论覆盖人工,而要分析Rubric是否含糊。
主观评分拆成可观察维度:是否直接回答、是否解释下一步、是否包含无关承诺。每个维度给通过、失败和边界样例。这样即便裁判变化,规则仍能被人读懂。
失败聚类决定下一步修哪里
同样是失败,知识缺失应该补文档,检索失败要调召回,工具参数错误要修Schema,越权行为要收紧Harness,表达啰嗦才可能改Prompt。若所有失败都归为“模型效果差”,团队只能不断换模型。
报告首页不放一个总分,而放失败分布和风险变化:新增几条红线失败、哪些历史事故复发、哪类工具调用波动最大。产品看到的是能否发布,研发看到的是修哪里,测试看到的是证据是否完整。
一周落地节奏
第一天选30条真实问题并补标签;第二天写10条确定性业务断言;第三天接入Trace;第四天做人工金标和Rubric;第五天把冒烟集接入CI。第二周再扩数据,而不是第一天就生成上千条。
小团队真正需要的不是“评测平台大而全”,而是一条失败能够从线上进入数据集、从数据集进入回归、从回归进入发布决策的短闭环。
如何防止“修好一条,弄坏一片”
每个Badcase修复后,除了重跑原样本,还要运行它所在业务簇的邻居样本。例如为避免“30天退货”而强制回答7天,可能误伤海外站点和保修场景。把修复影响范围写进变更说明,评测报告同时展示目标样本改善与相邻样本变化。
上线采用小流量影子评测:新版本先生成结果但不直接回复用户,与旧版本对照红线、工具行为和成本。只有差异得到解释,才逐步放量。这样Continuous Evaluation不是每天跑一张分数表,而是成为变更风险控制。
本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。