Google最新发布的Gemini 4 Hydrogen,定位非常清晰:它不是追求极限长推理的旗舰模型Carbon/Argon,而是专门面向Agent 智能体工作流、日常代码任务、规模化企业落地的高性能主力版本,把Gemini4系列能力下沉到全产品线,普通开发者、业务团队都可以用上新一代Agent能力。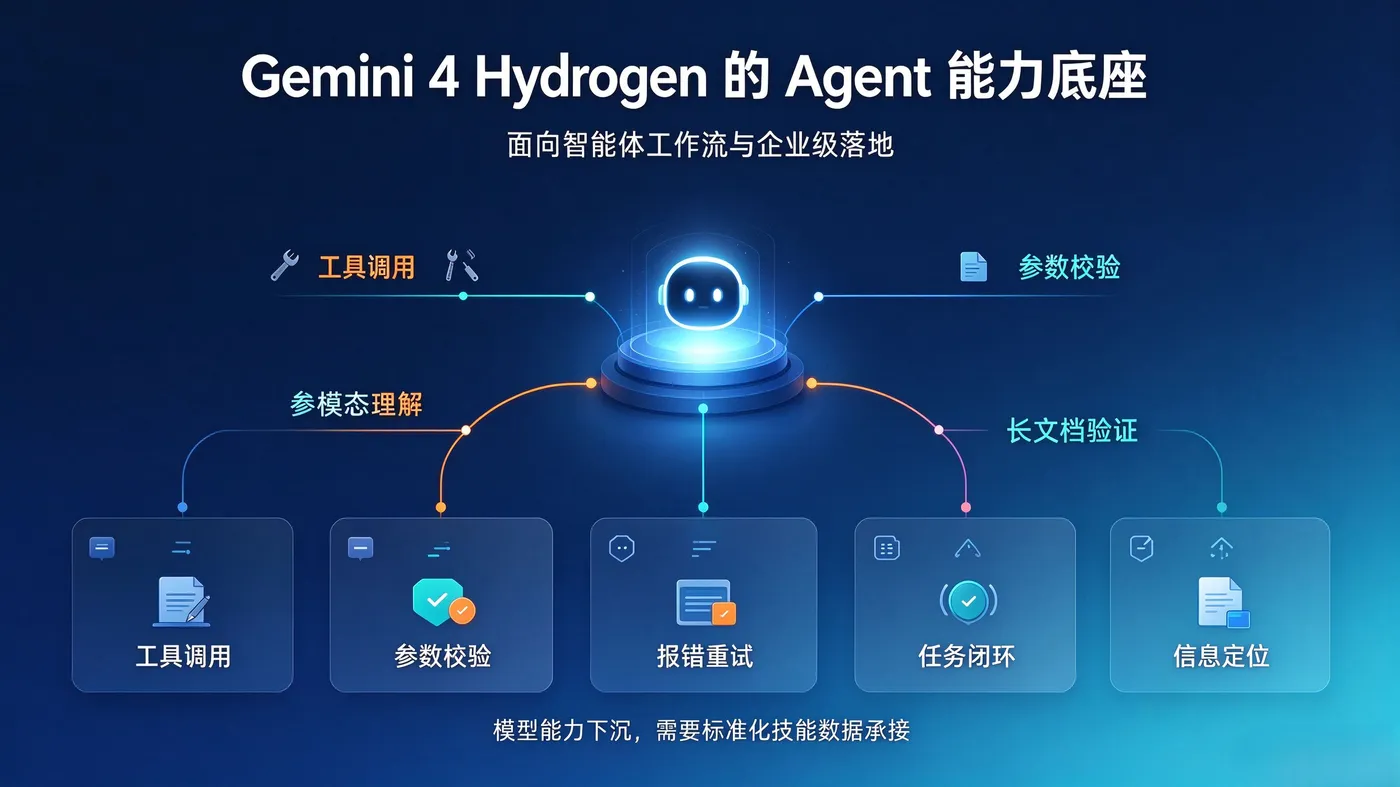
很多人只看到跑分提升,但背后真正决定Agent模型上限的,其实是数据供给、技能样本、领域高质量数据集。Hydrogen的能力上涨,本质是训练、微调、Agent轨迹数据共同堆出来的结果;但普通开发者想要复刻、二次微调、自建Agent,最大的卡点恰恰就是拿不到成套、标准化的Agent训练数据。
很多开发者上手之后会发现一个共性痛点:哪怕拿到了参数很强的模型,一上工具调用、多轮链式任务就容易翻车。会出现选不对函数、参数传错、遇到报错不会重试、任务中途跑偏、长文档里找错关键信息等问题。本质原因不是模型底座不够强,而是缺少配套的 Agent技能数据。那像Gemini 4 Hydrogen这类Agent优先的模型,到底需要什么样的数据?
第一,是完整的Agent 多轮轨迹样本。不只是 “输入 - 输出” 的简单问答对,而是包含思考、选工具、调用API、接收返回、纠错重试、分支判断的全链路轨迹,既要有成功样本,更要有大量异常、报错、边界case、负向样本,这是训练模型学会规划、学会容错的核心。
第二,是工程化代码工作流数据。不是零散代码片段,而是多文件项目修改、调试排错、单元测试、版本diff、项目级任务闭环的数据,适配Hydrogen面向编码自动化的能力。
第三,长上下文对齐数据。百万token上下文下的信息定位、跨文档对比、信息校验、摘要推理样本,解决长文本场景下的信息遗忘、幻觉漂移。
第四,垂直领域的任务指令集。金融、医疗、工业、电商等行业专属任务范式,用来做领域微调,让智能体看得懂行业术语、遵守行业规范。
第五,多模态融合任务数据。图文、截图、表格结合的规划任务,满足很多业务场景里看图理解、填表、提取信息再调用工具的复合需求。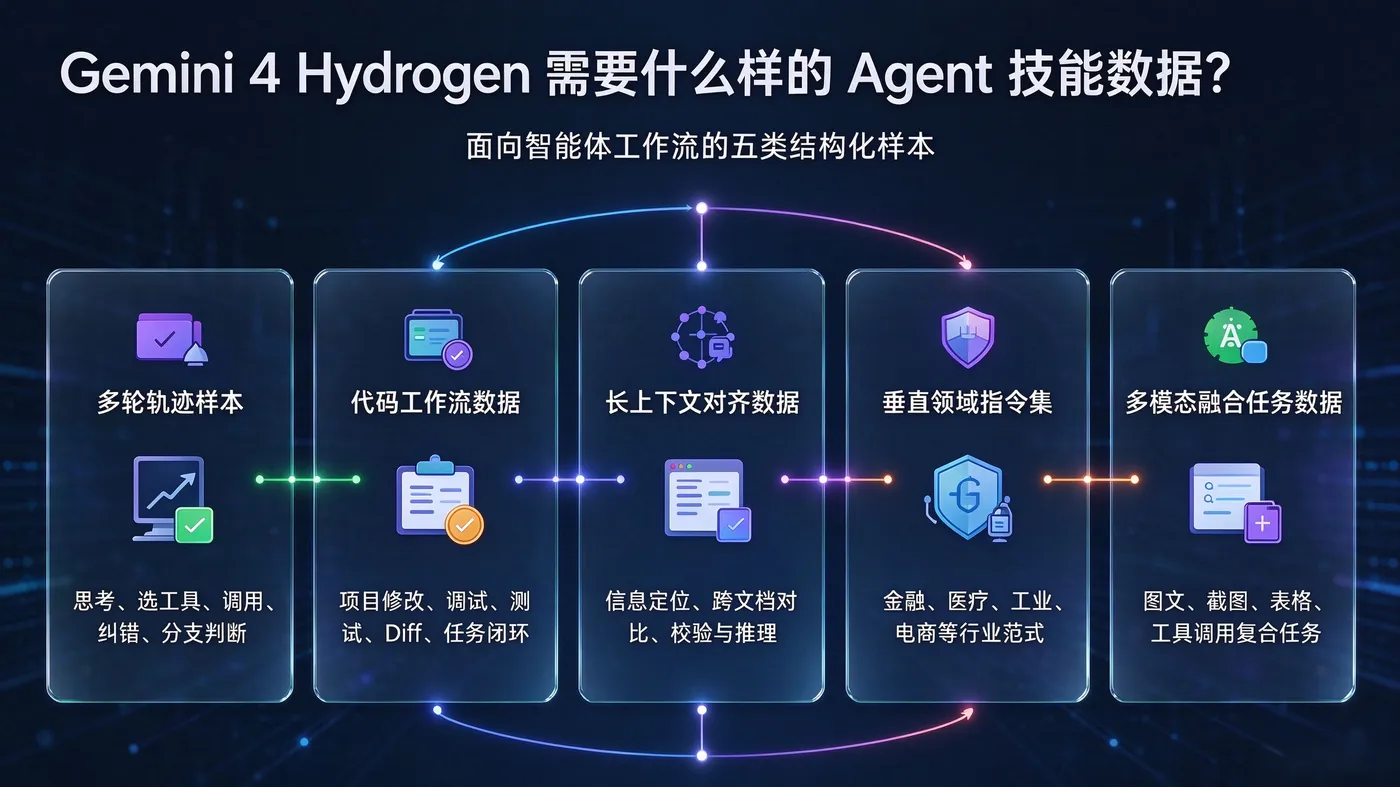
随之而来第二个问题:这类Agent技能数据,到底该怎么生产?
传统的数据集大多依靠网页爬虫,拿来做通用对话模型尚可,但完全撑不起Agent训练。高质量Agent数据集,是一套很重的闭环生产链路:首先由Agent和行业专家定义标准化 Skill范式,明确每个技能的输入、输出、约束条件、失败场景;其次归集真实业务里智能体运行日志,沉淀真实轨迹;再通过人机协同标注,修正逻辑错误,校准工具调用链路;之后基于少量高质量种子样本,AI可控合成海量边界case、边缘场景;最后经过多轮清洗、去重、污染过滤、质量打分、格式标准化,输出可以直接用于SFT、DPO、评测的结构化样本。
整套链路的成本、技术门槛非常高。绝大多数团队,不管是个人开发者、小AI创业团队,还是传统企业的AI部门,都没有能力自建完整的数据生产流水线。自己招人标注、搭建合成和清洗工具,周期长、投入大,最后产出的数据质量参差不齐,直接拖累Agent迭代速度。这也是当下Agent落地最大的卡点:模型API越来越容易拿到,但高质量、标准化的技能数据依然稀缺。
Hydrogen想要发挥出Agent能力,非常依赖一类特殊数据:多轮规划、工具调用、失败重试、代码工程闭环、长文档校验的结构化样本,不是普通网页文本。这类数据生产门槛很高,需要业务轨迹归集、专家范式定义、人机标注、可控合成+清洗校验整套链路,自己搭建成本巨大。
刚好Datasetseek精准踩中这个痛点:覆盖医疗、金融、工业、3D、推理、具身智能、机器人等上百类垂直数据集,配套标注、数据合成、治理工具;简单说:Gemini 4 Hydrogen 给了Agent底座,但想要把工具调用、复杂任务自动化做稳,缺的就是Agent技能数据集。Datasetseek-全栈人工智能数据基础服务平台,不管是基于Gemini二次开发,还是自研国产Agent,都能大幅降低数据生产和迭代成本。